YouTubeコメントの高評価が多い理由:ほぼタイミング
要点
- 投稿時刻付きの135万件のYouTubeコメントでは、動画内でのコメントの高評価順位を決める要因の83.5%が露出で説明でき、コンテンツで説明できるのは約8%。
- 公開コメントコーパスには高評価数があってタイムスタンプがないため、それで学習したモデルはタイミングを学ぶ。私はタイムスタンプ付きのものを収集し、公開した。
- コメントの82%は高評価ゼロで、上位1%が高評価の95%を占める。そのため平均値では到着時刻の効果が見えないが、対数高評価では5.9倍の低下が見える。
- 人間向けの助言としては、大きな動画の最初の1時間にコメントすること。最も成績が良いのは、ある一瞬への短い言及だ。
人が実際に高評価するYouTubeコメントを書けるモデルを訓練できるのか知りたかった。明らかな学習信号は高評価数で、まさにそれをやっている最近の研究もある。高評価数上位10%のコメントでファインチューニングし、ランダムなコメントで訓練したモデルの約3倍のエンゲージメントを報告している。
それから、高評価数が実際に何を測っているのかを見た。動画の最初の1時間に投稿されたコメントは、1週間後に投稿されたものより桁違いに多くの人に見られる。しかもYouTubeの「上位のコメント」の順位付けがそれを増幅する。上位に並ぶことが高評価を生み、高評価が上位に並ぶことを生むからだ。まったく同じ2つのコメントが、到着時刻だけで3桁違うことがありうる。
そこで問いは「モデルは良いコメントを書けるか」ではなく、「高評価数はそもそもコメント自体について何か含んでいるのか」に変わった。
公開データではこの問いに答えられない
大規模な公開YouTubeコメントコーパスのYT-30MとYTCommentVerseは、合わせて約3200万件のコメントを持つ。どちらも upvotes を提供している。どちらもタイムスタンプは提供していない。
投稿時刻がなければ、コメントが何を言ったかといつ現れたかを切り分けられない。これらのコーパスで訓練されたモデルはすべて、その先行分を見る手立てもないまま、それに当てはめている。
そこで投稿時刻を持つコーパスを収集した。34チャンネル・633本の動画からのトップレベルコメント1,345,353件で、投稿時刻、取得時刻、返信数、動画統計、そしてYouTube自身のアルゴリズムが各コメントに与えた順位が含まれる。3日間、約14,900 APIユニット。
ひとつの判断が他のすべてより重要だった。commentThreads.list はコメントを新しい順に返すため、動画ごとのページ上限を設けると最も古いコメントが落ちる。それはまさにこの研究の対象である高露出のコメントだ。すべての動画を完全に列挙した。1日のクォータ内で完了できないほど大きい動画は最初から除外し、静かに切り詰めるのではなくマニフェストに記録した。
露出が83.5%を占める
各コメントの高評価順位をその動画内で予測する。これにより動画そのものの効果が学習信号から除かれる。そこに一度に1つずつ加えていく。露出特徴量、次に長さと形、次に200,000個のTF-IDF特徴量、次にMiniLM埋め込み。分割はコメント単位ではなく必ずチャンネル単位にして、モデルが見たことのない視聴者層へ転移するかを問う。
| 要素 | 偶然を超える順位付け能力のうちの割合 |
|---|---|
| 露出(投稿時刻、動画規模) | 83.5% |
| 長さと形 | 8.4% |
| コメントが実際に述べている内容 | 8.2% |
コメントの長さはコンテンツと見なす余地もあり、露出ではない。そう数えるとコンテンツは16.5%になる。どちらにしても露出は83.5%なので、この結論はその線引きをどこに置くかに依存しない。
私にとって決着をつけた数字はこれだ。384次元の文エンコーダがbag of wordsに対して稼ぐのは 0.0015 AUC だけ。語彙ベースのヌルモデルに対する定番の反論はテキストモデルが弱すぎたというものだが、まったく異なる表現の系統も同じ場所に着地する。
絶対的な予測可能性は全体を通して低い。最良のモデルでもAUCは0.671で、偶然は0.5。露出は大差でコンテンツに勝ち、そしてどちらも、どのコメントが高評価されるかを決める他の何かに負けている。
このデータセットに潜む罠
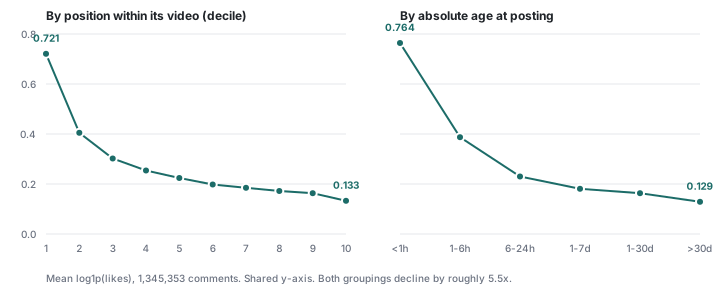 両パネルとも同じコメント、同じy軸。動画内での位置と絶対的な経過時間の両方が同じ低下を示す。
私は最初これを間違えた。データに触れる前に知っておくべきことだ。
コメントを投稿の遅さでバケットに分け、各バケットの高評価数の平均を取る。
| 投稿時点の経過時間 | <1h | 1-6h | 6-24h | 1-7d | 1-30d | >30d |
|---|---|---|---|---|---|---|
| 平均高評価数 | 19.8 | 21.7 | 19.5 | 19.8 | 25.8 | 20.4 |
平坦だ。到着時刻の効果はまったくない。私はそれを知見として書き上げた。
今度は同一のバケットで log1p(likes) の平均を取る。
| 投稿時点の経過時間 | <1h | 1-6h | 6-24h | 1-7d | 1-30d | >30d |
|---|---|---|---|---|---|---|
| 平均log1p(likes) | 0.764 | 0.387 | 0.230 | 0.181 | 0.163 | 0.129 |
5.9倍の低下。効果はずっとそこにあった。
コメントの82.1%は高評価ゼロで、上位1%が全高評価の94.9%を占める。 そうした分布でのグループ平均は、グループについての統計ではなくグループの外れ値についての統計だ。1つのバズったコメントがバケット全体の平均を決めてしまう。
このコーパスを生の高評価数の平均で要約すれば、大きな効果が存在するところで効果なしと報告することになる。
3倍を認定した指標
先行研究は、生成されたコメントを埋め込み、参照コーパスからK近傍を取り出し、その高評価数を平均することで採点する。私はこれが類似性で攻略できると予想した。高評価上位のテキストで訓練し、高評価上位のテキストの近くに着地すれば、人間が実際に高評価したかどうかに関係なく高得点が出る、と。
私は二重に間違っていた。実際の高評価上位コメントを選んでも3倍の比は再現しない(私の結果は0.88から1.21)。半分を高評価上位の例でfew-shot条件付けして960件のコメントを生成しても再現しない。
代わりに分かったのは、この統計量がまったく安定しないことだ。K=5では、平均の比は条件付けによって3倍悪化したと言い、その区間は1.0を含まない。同じ480サンプルでの中央値の比は、2倍良くなったと言う。3回の実行で同じ数字が138、次に0.09、次に0.25(平均)で中央値では2.00になった。
同じヘビーテール、上で述べた私自身の間違いと同じ失敗モードだ。どう要約するかで向きが反転する指標は、特定の公表値が何によって生まれたにせよ、3倍という主張を支えられない。
しかもそれは推定対象をほとんど追えていない。実際の高評価の結果に対して、コメントを Spearman 0.050 の精度で順位付けする。コメントがいつ投稿されたかと動画の規模だけを知るモデルは、同じコメントで0.19を出す。
自分のコメントを刺したいだけなら
モデルではなく人に向けると、同じ数字は戦略として読める。効果の大きい順におおよそ並べる。
早く投稿する。 動画内では、最も早い十分位のコメントは最も遅い十分位の平均5.4倍。絶対的な経過時間で見ると、最初の1時間のコメントは1か月後に投稿されたものの5.9倍。自分で制御できる他の要素はこれに及ばない。
大きな動画で早く投稿する。 動画規模は他のすべてを掛け算する。生データでは、NileRedの投稿に6週間遅れで付いたコメントが、Computerphileの動画の最初の1時間のコメントを上回る。500万再生の動画への平凡なコメントは、7万再生の動画への良いコメントを上回る。
本当の賞品は最初のページだ。 そこに表示されるコメントは平均419.5高評価で、それ以外は1.13。これは勾配ではなく373倍の閾値で、順位付けが初期の高評価で動くため、入場券を買うのは最初の1時間だ。
チャンネルを選ぶ。 高評価ゼロのコメントの割合は、Voxの52.8%からDavie504の90.7%まで幅がある。一文字も書く前に、どこにコメントするかで何らかの高評価を得る確率がほぼ2倍変わる。
Shortsではさらに速く動く。 そこでの早期優位は7.6倍で、長尺は5.3倍。
何を書くかは全体の約8%。 その形は短い。平均コメント長は高評価とともに上がり、そして反転する。100〜999の層で171文字、1000以上では147文字に下がる。コーパスの上位コメントは、練られた考察ではなく特定の一瞬への圧縮された言及だ。
錬金術師はこの一手を嫌がる
この動画、ほぼ全編グレースケールじゃないか
あの無理のある「地元の店を応援しよう」で笑った
一瞬を引用し、圧縮し、そこで止める。
重要な留保が2つ。全コメントの82%は高評価ゼロで、私が作ったすべての特徴量を持つモデルでも順位付けはAUC 0.671にとどまる。つまりこの大半は制御できない分散だ。そして私が測ったのは高評価を予測するものであり、高評価を引き起こすものではない。タイミングの効果は機械的な露出なので因果である可能性が高い。「短い言及」は他の何かの相関物であっても不思議はない。
正直に要約すれば、勝つ戦略は書くことよりほとんど段取りの問題だ。
ここから見えること
高評価数を目標にコメント生成器を最適化することは、ほとんど時計を目標に最適化することだ。高評価上位のコメントで訓練されたモデルは、大きな動画の早いコメントがどんな見た目をしているかを学ぶのであり、コメントの内容に帰属する部分は8%程度だ。
それでコメントの質が測定不能になるわけではない。測定はまず露出で条件付けしなければならず、これまでは公開データセットでそれができなかった、ということだ。次に作りたいのは、私が作れなかった部分だ。露出を固定したうえでのコメントの人間評価であり、このコーパスはそれを可能にするが、それ自体は含んでいない。
データセットはHugging Face上でCC BY 4.0で公開しており、コードと凍結した母集団マニフェストはGitHub上にある。論文には完全な段階的分析、分割方法、そして私が間違えた箇所が載っている。