為什麼有些 YouTube 留言讚數更多:主要靠時機
簡而言之
- 在 135 萬則帶有發佈時間的 YouTube 留言中,曝光解釋了一則留言在同一支影片內讚數排序的 83.5%,內容約解釋 8%。
- 公開的留言語料庫只有讚數而沒有時間戳記,所以用它們訓練出來的模型學到的是時機。我自己收集了一份有時間戳記的語料庫並公開發佈。
- 82% 的留言是零讚,而前 1% 的留言擁有其中 95% 的讚,所以平均值看不出任何到達時間效應,而對數讚數卻顯示出 5.9 倍的衰減。
- 給一般人的建議:在大影片的第一小時內留言。表現最好的留言是針對某個片段的簡短呼應。
我想知道能不能訓練出一個模型,寫出人們真的會喜歡的 YouTube 留言。最直觀的訓練訊號就是讚數,而最近確實有研究這麼做:用最多讚的前 10% 留言做微調,回報的互動量大約是用隨機留言訓練的模型的 3 倍。
接著我去看讚數實際上測的是什麼。在影片發佈第一小時內留的言,被看到的人數比一週後留的言多好幾個數量級,而 YouTube 的「熱門留言」排序又加劇了這一點,因為排得高會帶來讚,而讚又會讓你排得更高。兩則一模一樣的留言,光憑到達時間就能差上三個數量級。
於是問題不再是「模型能不能寫出好留言」,而變成「讚數究竟包含任何關於留言本身的資訊嗎」。
用公開資料回答不了這個問題
兩個大型的公開 YouTube 留言語料庫 YT-30M 與 YTCommentVerse,合計約有 3,200 萬則留言。兩者都提供 upvotes,但都沒有提供時間戳記。
沒有發佈時間,你就無法把留言說了什麼和它何時出現分開。每一個用這些語料庫訓練的模型,都是在擬合那段先發優勢,卻完全看不到它。
所以我收集了一份有時間戳記的語料庫:來自 34 個頻道、633 支影片的 1,345,353 則頂層留言,包含發佈時間、抓取時間、回覆數、影片統計資料,以及 YouTube 自家演算法給每則留言的排名。耗時三天,約 14,900 個 API 單位。
有一個決定比其他所有決定都重要。commentThreads.list 會由新到舊回傳留言,所以任何以影片為單位的頁數上限都會丟掉最舊的留言,而那些正是本研究關心的高曝光留言。每支影片都被完整列舉。大到無法在每日配額內跑完的影片會事先排除,並記入清單,而不是被悄悄截斷。
曝光佔了 83.5%
預測每則留言在自己所屬影片內的讚數排名,這樣就把影片效應從訓練訊號中剔除。然後一次加一項:曝光特徵,接著是長度與形式,接著是 200,000 個 TF-IDF 特徵,最後是 MiniLM 嵌入。按頻道切分,絕不按留言切分,因此問題在於它能不能轉移到模型從未見過的觀眾群。
| 成分 | 在高於隨機的排序能力中所佔比例 |
|---|---|
| 曝光(發佈時間、影片規模) | 83.5% |
| 長度與形式 | 8.4% |
| 留言實際說了什麼 | 8.2% |
留言長度也可以說是內容,而不是曝光。若這樣算,內容會提高到 16.5%。不論怎麼算,曝光都是 83.5%,所以這個結論不取決於你把界線畫在哪裡。
讓我確信的數字是:相較於詞袋模型,一個 384 維的句子編碼器只多換來 0.0015 AUC。對詞彙層面虛無結果的標準反駁是文字模型太弱,但一個完全不同的表徵家族落在同一個位置。
整體的絕對可預測性很低。最好的模型 AUC 為 0.671,隨機是 0.5。曝光大幅勝過內容,而兩者都敗給其他決定哪些留言會被按讚的因素。
這份資料集裡的陷阱
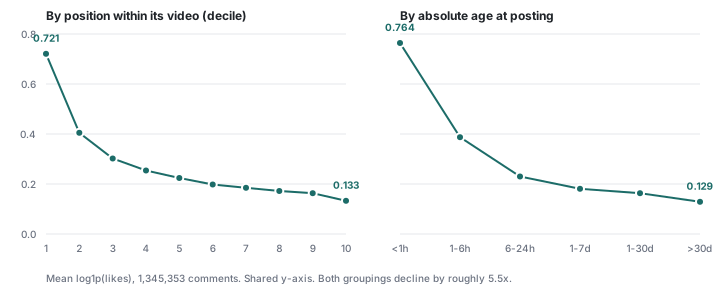 兩張圖,同樣的留言,同樣的 y 軸。影片內的相對位置與絕對時間差都呈現同樣的衰減。
我一開始搞錯了,在你動手處理資料前應該先知道這件事。
把留言依發佈的早晚分桶,取每個桶的讚數平均值:
| 發佈時的年齡 | <1h | 1-6h | 6-24h | 1-7d | 1-30d | >30d |
|---|---|---|---|---|---|---|
| 平均讚數 | 19.8 | 21.7 | 19.5 | 19.8 | 25.8 | 20.4 |
平的。完全沒有到達時間效應。我還把這寫成了一項發現。
現在對完全相同的分桶取 log1p(likes) 的平均值:
| 發佈時的年齡 | <1h | 1-6h | 6-24h | 1-7d | 1-30d | >30d |
|---|---|---|---|---|---|---|
| log1p(likes) 平均值 | 0.764 | 0.387 | 0.230 | 0.181 | 0.163 | 0.129 |
5.9 倍的衰減。這個效應一直都在。
82.1% 的留言是零讚,而前 1% 擁有全部讚數的 94.9%。在這樣的分佈上取組平均,得到的是關於該組離群值的統計量,而不是關於該組本身。一則爆紅留言就決定了整個桶的平均值。
任何對這份語料庫取原始讚數平均的摘要,都會在效應明顯存在的地方回報沒有效應。
認證了 3 倍的那個指標
先前的研究為生成的留言評分的方式是:把它嵌入,從參考語料庫中取出 K 個最近鄰,再對它們的讚數取平均。我原本以為這會被相似度刷分:用高讚文字訓練,落在高讚文字附近,不管人類是否真的會喜歡都能拿高分。
我錯了,而且錯了兩次。挑選真實的高讚留言無法重現 3 倍的比值(我得到 0.88 到 1.21)。生成 960 則留言、其中一半以高讚範例做少樣本條件化,也一樣重現不了。
我實際發現的是這個統計量根本站不住。在 K=5 時,平均值之比說條件化讓結果糟了 3 倍,而且區間不含 1.0。在同樣的 480 個樣本上,中位數之比卻說好了 2 倍。三次執行下來,同一個數字先是 138,然後 0.09,然後 0.25(以平均值計)以及 2.00(以中位數計)。
同樣的重尾,跟我前面自己犯的錯是同一種失效模式。一個方向會隨著摘要方式翻轉的指標,撐不起 3 倍的主張,無論某個已發表的數字是怎麼來的。
它也幾乎追不上它要估計的東西。對照真實的讚數結果,它對留言的排序只有 Spearman 0.050。而一個只知道留言何時發佈以及影片有多大的模型,在同樣的留言上拿到 0.19。
如果你只是想讓自己的留言被看到
把同樣這些數字對準一個人而不是一個模型,就成了一套策略。大致按影響力排序:
要早。在一支影片內,最早的十分位留言平均是最晚那組的 5.4 倍。按絕對時間差算,第一小時的留言比一個月後發佈的高 5.9 倍。你能控制的其他因素都望塵莫及。
在大影片上搶早。影片規模會把其他所有因素乘上去。在原始資料裡,NileRed 影片上晚了六週發的留言,勝過 Computerphile 影片上第一小時的留言。一支 500 萬觀看影片上的平庸留言,表現勝過一支 7 萬觀看影片上的好留言。
首頁那一頁才是真正的獎品。顯示在上面的留言平均 419.5 個讚,其餘全部只有 1.13。那是一道 373 倍的門檻,不是漸層,而且因為排序是靠早期的讚運作,第一小時才是買到入場券的東西。
挑頻道。零讚留言的比例從 Vox 的 52.8% 到 Davie504 的 90.7%。在你寫下一個字之前,你拿到任何一個讚的機率就已經依留言地點差了將近一倍。
在 Shorts 上要更快。那裡的早期優勢是 7.6 倍,長影片是 5.3 倍。
你寫什麼大約只佔 8%。它呈現的形式是短。留言平均長度隨讚數上升,然後反轉:100-999 讚這一層是 171 字元,到 1000 以上降到 147。語料庫中最高讚的留言是針對某個特定片段的壓縮呼應,而不是展開的觀察:
煉金術士最恨的一個小技巧
這支影片幾乎整部都是灰階
那句硬撐出來的「支持本地商家」笑死我了
引用一個片段,壓縮它,然後收尾。
兩個重要的限制。所有留言中有 82% 是零讚,而即使是用上我建構的每一項特徵的模型,排序的 AUC 也只有 0.671,所以這其中大部分是你控制不了的變異。而且我測的是什麼能預測讚,不是什麼造成讚。時機效應有合理的因果性,因為它是機械性的曝光。「簡短呼應」很可能只是其他某件事的相關項。
誠實的結論是:贏的策略主要是後勤,而不是寫作。
這帶我們到哪裡
以讚數為目標去最佳化留言生成器,主要是在對著一個時鐘做最佳化。用高讚留言訓練出的模型學到的是大影片上早期留言長什麼樣,而能歸因於留言內容的部分約為 8%。
這並不代表留言品質無法測量。它代表測量必須先以曝光為條件,而在此之前沒有任何公開資料集讓你做到這件事。我接下來想建的正是我做不到的那一塊:在曝光固定的條件下,由人類對留言評分,這是這份語料庫現在使之可行、但本身並不包含的東西。
資料集在 Hugging Face 上,採用 CC BY 4.0,程式碼與凍結的母體清單在 GitHub 上,而論文有完整的階梯式實驗、切分方式,以及我搞錯的部分。