餐廳的違規項目數多半只是記帳方式
重點摘要
- 科羅拉多州的 Boulder County 與 Tri-County 使用同一份 56 項稽查表單,違規數卻相差 2.65×。Boulder 的稽查員有 58% 的表單項目未勾選,而 Tri-County 的格式根本無法記錄「未檢查」。
- Marin County 每次稽查的違規數在一年內下降 74%,稽查員相同、餐廳相同,也沒有任何資料移轉可以解釋。
- 在控制餐廳與年份之後,由哪位稽查員出勤會讓違規數變動達平均值的 172%。
- 違規數只在單一轄區、單一時期、單一稽查員之內才有意義。跨越其中任何一項的比較都會失效。
美國每個衛生局都會公布餐廳稽查結果,也有一長串應用程式試著在你挑選餐廳的那一刻把結果送到你眼前。其前提是違規數能告訴你一些關於廚房的事。
我原本想比較幾個轄區,看看標準在郡與郡之間究竟差多少。我發現的是,這個比較根本做不了,而原因比比較結果本身更有意思。
以下所有內容都來自即時的公開 API。程式碼在這裡,只用標準函式庫、不需要 API 金鑰就能重新產生每一個數字。
兩個郡、同一份表單,相差 2.65 倍
Boulder County 與 Tri-County(Adams、Arapahoe、Douglas)都把資料發佈到科羅拉多州的開放資料平台,也都使用同一份 56 項的 FDA 食品法規檢核表。同樣的工具、同樣的違規代碼 FC01 到 FC56、同一個州。
以下是 2019 年到 2022 年 10 月、兩邊資料集重疊期間的例行稽查:
| 每次稽查的違規數 | n | |
|---|---|---|
| Boulder County | 2.10 | 1,984 |
| Tri-County | 5.57 | 7,886 |
我的第一個念頭是 Tri-County 比較嚴格。資料似乎也支持這點。Tri-County 是一個機關管三個郡,這剛好把地理因素和管理機關分開來,而其中三個郡的數值分別是 5.83、5.36 與 5.54。在同一個機關之下、橫跨兩條郡界,差距約 9%。機關之間卻是 165%。
接著我把餐廳固定住。Subway 就是 Subway:同樣的企業流程、同樣的設備、同樣的稽核制度。
| 連鎖品牌 | Boulder | Tri-County |
|---|---|---|
| Subway | 2.42 | 4.41 |
| Starbucks | 0.65 | 2.18 |
| Chipotle | 0.69 | 1.94 |
| McDonald’s | 1.47 | 3.11 |
| Taco Bell | 1.00 | 3.36 |
| Wendy’s | 0.11 | 4.47 |
| 合併 | 1.15 | 3.16 |
九個連鎖品牌,九個全都指向同一個方向,合併後為 2.76 倍。到那個時候,我很確信科羅拉多州這兩個相鄰衛生局在執法上確實有差異。
這個數字是個分數,而我只有分子
Boulder 每個檢核項目各發佈一列,每列都附帶狀態。Tri-County 每次稽查發佈一列,附上 56 個二元旗標。
差別在於每種格式能表達什麼。
| 稽查員記錄的內容 | Boulder | Tri-County |
|---|---|---|
| 已開立 | Out、Out-High、Out-Medium、Out-Low |
旗標 = 1 |
| 看過了,沒問題 | In |
無法區分 |
| 沒有去看 | Not Observed |
無法區分 |
| 此處不適用 | Not Applicable |
無法區分 |
Boulder 可以說「我檢查過而且沒問題」以及「我從沒檢查這一項」。Tri-County 的格式把兩者都壓成零。
於是我算了算 Boulder 的稽查員實際評估了表單的多少比例:
| 表單項目數 | 已評估項目數 | 違規數 | 每個已評估項目的比率 | |
|---|---|---|---|---|
| Boulder | 56.8 | 24.1 | 2.10 | 8.7% |
| Tri-County | 56 | 無法得知 | 5.57 | 若全部 56 項則為 9.9% |
Boulder 的稽查員有 58% 的表單完全沒動。若用實際查看過的項目去除,2.65 倍就變成大約 1.14 倍。
就連這個數字也高估了殘差,因為 Tri-County 的分母無法還原。如果他們的稽查員也大約評估 24 個項目,他們真正的比率約為 23%,是 Boulder 的兩倍多,效果的方向就反轉了。Boulder 的比率有界。Tri-County 的沒有。
馬里蘭州的 Montgomery County 使用一份 15 項的表單,採用同樣的三分類用語,而它把 2% 到 6% 的項目標為「Not Observed」,Boulder 則標了 58%。目前沒有任何全國性慣例可作為正規化的基準,而這正是為什麼任何拿公布數字做比較的人都看不見這個問題。
同樣的問題也出現在時間軸上
如果數字會隨著記錄慣例而變動,那麼在單一轄區之內,只要該轄區改變書面記錄方式,數字也應該會跟著動。
加州的 Marin County 公布了 12 年的稽查資料。每次例行稽查的違規數,依年份列出:
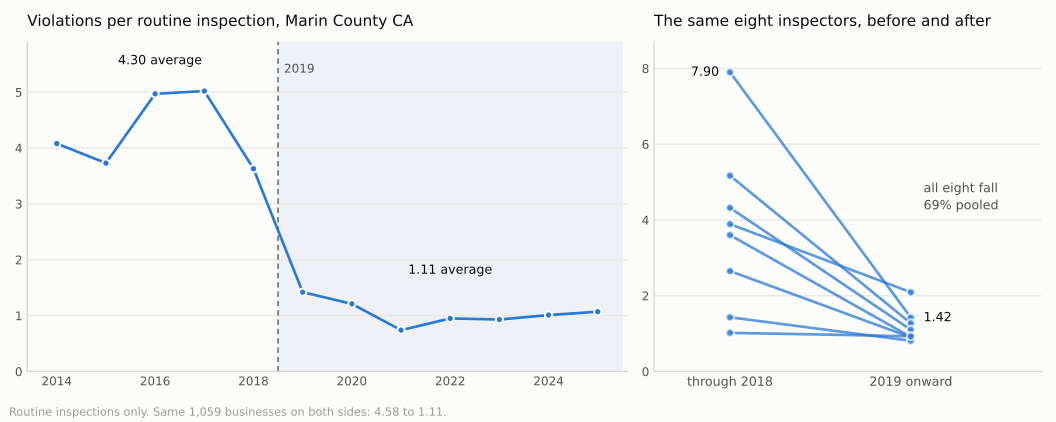 左:序列在 2019 年斷裂,之後再也沒有回升。右:每一位橫跨斷點工作的稽查員都下降。
| 2014 | 2015 | 2016 | 2017 | 2018 | 2019 | 2020 | 2021 | 2022 | 2023 | 2024 | 2025 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 4.08 | 3.73 | 4.97 | 5.02 | 3.63 | 1.42 | 1.21 | 0.74 | 0.95 | 0.93 | 1.01 | 1.07 |
跨越單一年份界線,從 4.30 降到 1.11。 同期的稽查量還上升了,從 2018 年的 1,351 次例行稽查增加到 2019 年的 1,514 次。違規代碼用語沒有改變。評等標示制度早在 2015 年就已在執行。
Marin 在每一列都標明稽查員姓名,幾乎沒有其他轄區會這麼做。所以我能檢查人員是否換過一輪。在斷點兩側都至少有 40 次例行稽查的稽查員:
| 稽查員 | 2019 年前 | 2019+ | 變化 |
|---|---|---|---|
| A | 7.90 | 1.42 | −6.48 |
| B | 5.17 | 1.27 | −3.90 |
| C | 4.32 | 1.10 | −3.22 |
| D | 3.89 | 2.09 | −1.79 |
| E | 3.60 | 0.91 | −2.68 |
| F | 2.65 | 0.90 | −1.75 |
| G | 1.43 | 0.81 | −0.62 |
| H | 1.02 | 0.93 | −0.09 |
八位全部下降。合併後為 −69%。稽查員 A 是同一個人做同一份工作,從每次稽查 7.90 個違規降到 1.42。
而把餐廳固定住之後:在斷點兩側都受過稽查的 1,059 家業者,從 4.58 降到 1.11。
同樣的人。同樣的餐廳。同樣的代碼。違規數只剩四分之一。
真正改變的東西,可以從稽查如何分類看出來。完全沒發現問題的比例幾乎沒動,從 11-16% 變成 13-26%。被分類為重大的比例從 23-39% 降到 8-15%,差額由輕微類吸收,而每次有違規的稽查所逐項列出的違規數,從約 4.1-5.8 降到 1.1-2.1。一次稽查發現問題的機率大致持平。每次稽查被寫下來的問題數量卻崩塌了。
檢查我看到的是不是一次資料移轉
能推翻這一切的解釋是資料來源。如果 2019 年之前的列來自另一套系統再移轉進來,那麼這個斷點就是資料集的產物,而不是實務作法造成的。
三項測試,全部為否:
紀錄 ID 是連續的。 整整 13 年就是一條單調遞增的序列,而且在界線處範圍互相重疊:2018 年跨越 25,039 到 37,081,2019 年跨越 24,518 到 42,338。沒有重新起算,也沒有斷口。
結構沒有變動。 inspector、placard、correct_by_date、corrected_on_site、inspector_comments、inspection_frequency 與 license_number 在 2014 到 2026 年的每一年都是 100% 填滿。唯一改變的欄位是違規代碼,從 96-97% 變成 67-90%,而這正是本文的發現,不是結構變更。
匯出檔的指紋改變的地方在別處。 這個資料集中有些字串值被字面上的引號字元包住。這個產物在 2024 年之前出現於 0% 的列,2025 年為 83%,2026 年為 100%。
最後這一項是這裡最強的證據。資料管線確實改變過,是在 2025 年,不是 2019 年。如果那 74% 的下降是資料移轉造成的,格式特徵應該會一起移動。
它也造成了我遇到的第一個錯誤。依稽查員分組而沒有去掉那些引號,會得到 46 位稽查員。實際上是 40 位。其中六位是同一個人出現兩次,一次帶引號、一次不帶。
像 Marin 這樣的斷裂有多常見
這時一個合理的質疑是,我是去找不連續點才找到一個,而且衛生局本來就不斷修改文書作業。所以我用同樣的方法檢查了另外三個長時間序列。
| 轄區 | 指標 | 期間 | 最大的單年變動 |
|---|---|---|---|
| 科羅拉多州 Boulder County | 每次例行稽查的違規數 | 2013-2025 | 13 年間從 1.60 到 2.35,無斷裂 |
| 芝加哥 | 稽查不合格的比例 | 2010-2026 | 16.0% 到 24.9%,緩慢漂移,無斷裂 |
| 紐約市 | 被標為重大的違規比例 | 2022-2026 | 52.4% 到 56.7%,無斷裂 |
Marin 是異常值。Boulder 是乾淨的對照,因為它是同一個指標、涵蓋更長的期間,而且逐年變動從未超過約 20%。
關於那張表有兩點提醒。芝加哥的合格/不合格與紐約市的重大違規比例,都比違規數更粗略,一個單位可能改變了逐項列舉的程度,而這兩個指標都不會動。另外紐約市公布的序列只回溯到 2022 年,這幾乎談不上是測試。
綜合起來看:像 Marin 這樣的斷裂並不是這類資料的常態,但也還沒罕見到可以直接假設不存在。我手上有長序列的四個轄區之中就有一個出現了,而公布的資料裡沒有任何地方會告訴你。
這也讓科羅拉多的比較更站得住腳。Boulder 在 13 年間保持平穩,意味著 2.65 倍差距中它那一側並不是我剛好挑了哪幾年所造成的產物。
誰來稽查的預測力幾乎和哪家餐廳一樣強
芝加哥把它的稽查優先排序模型開放原始碼,而一份獨立審查發現影響力最大的單一來源是由哪位衛生稽查員執行稽查。那是內部資料。Marin 的稽查員欄位讓這件事可以在公開資料上檢驗。
在 15,888 次例行稽查、1,645 家業者與 40 位稽查員之中,稽查員的原始平均值從 0.74 到 5.99。其中大部分來自時期因素,因為稽查員各自在不同時段任職,而 2019 年的斷點正好位於中間。
於是我減去業者平均值,使用的是那 1,453 家由兩位以上不同稽查員查過的業者,然後再減去年度平均值:
| 控制項 | 稽查員之間的差距 | 標準差 |
|---|---|---|
| 原始 | 8.1x | 1.41 |
| 減去業者平均 | 5.18 個違規 | 1.27 |
| 減去業者與年份 | 3.81 個違規,為平均值 2.22 的 172% | 0.86 |
在年度控制之下排序被打亂,這正好排除了純粹時期因素的解釋。控制後最嚴格的稽查員是 2025 年開始任職的,位於斷點的寬鬆側。最寬鬆的那位在 2018-2019 年任職,位於嚴格側。
原始序列上的粗略變異數占比:業者身分約占 24%,稽查員身分約占 21%。
這是算術上的去均值,而不是配適出來的模型,所以請把它當成方向與量級,而不是標準誤。稽查員與年份部分共線,而橫跨斷點的那八位稽查員承擔了辨識的重任。另外兩項發現沒有這個問題,因為它們是在精確控制之下的原始平均值。
結論落在哪裡
三個軸向,而這個數字在三者上都失效。跨轄區時,它會因為記錄慣例而變動 2.65 倍。跨時間時,同樣的人稽查同樣的餐廳,它卻變動 74%。跨稽查員時,控制之後它變動達平均值的 172%。
這些都不是在衡量稽查有沒有用。稽查員確實找出真實問題、確實關掉真實的廚房,本文任何內容都不對此表態。我衡量的是那個數字,而這個數字恰恰在你拿一個去比另一個時失效,而那正是下游所有人唯一會拿它去做的事。
真正的風險暴露位於查詢類應用程式的下游:以違規結果訓練的城市預測模型,以及比較不同地方或政策實施日前後評等制度的研究。芝加哥的模型就是用這類結果訓練的,而它自己的審查發現稽查員是最強的預測因子,當目標變數的一部分屬於文書作業時,這正是你會預期的結果。一項橫跨某轄區自身記錄方式變更的研究,會直接撞上 Marin 問題,因為世界靜止不動時序列卻在移動。
實用版的說法:違規數只有在單一轄區、單一時期,並針對是誰去稽查做過調整之後,才具可解讀性。其他情況都不行。如果你要在這些資料上做東西,第一件要檢查的不是數字,而是你的來源能不能表達「未觀察」,以及那個慣例在你的時間窗內有沒有保持不變。
這些都不是餐廳特有的問題。一個公布出來的計數,記錄的是某個機構寫下了什麼,而我看過的四個單位之中,有一個改變了書面記錄方式卻沒有說明。
如果你知道 2019 年 Marin County 究竟改了什麼,我很想聽,我也會更新這篇。這裡的每一個數字都能用那份程式碼對著即時 API 重新產生,歡迎驗證我的工作。