餐厅的违规项数量,大半只是记账方式
摘要
- 科罗拉多州的Boulder County和Tri-County用的是同一张56项检查表,违规项数量却相差2.65×。Boulder的检查员有58%的表项没有填写,而Tri-County的格式根本无法记录「未检查」。
- Marin County每次检查的违规项数量一年内下降74%,检查员没换,餐厅也没换,并且没有任何数据迁移能解释它。
- 在控制餐厅和年份之后,由哪位检查员上门造成的数量差异达到均值的172%。
- 违规项数量只在同一辖区、同一时期、同一名检查员的范围内有意义。跨越其中任何一项,比较就失效了。
美国每个卫生部门都会公布餐厅检查结果,也有一长串应用试图在你挑选吃饭地点的那一刻把这些结果摆到你面前。它们的前提是:违规项数量能说明厨房的某些情况。
我本想比较几个辖区,看看各县之间的标准到底差多少。结果发现这种比较根本做不了,而原因比比较结果本身更有意思。
下面的内容全部来自公开的实时API。代码在这里,用标准库、无需API密钥就能重新生成每一个数字。
两个县,同一张表,相差2.65倍
Boulder County和Tri-County(Adams、Arapahoe、Douglas)都把数据发布到科罗拉多州的开放数据门户,两家用的都是同一张56项的FDA食品法规检查表。同一种工具,同样的违规代码FC01到FC56,同一个州。
两家数据集重叠的区间,2019年至2022年10月的例行检查:
| 每次检查的违规项数量 | n | |
|---|---|---|
| Boulder County | 2.10 | 1,984 |
| Tri-County | 5.57 | 7,886 |
我最初以为是Tri-County更严格。数据似乎也支持这一点。Tri-County是一家覆盖三个县的机构,这就把地域和监管方分开了,机构内部三个县的数值分别是5.83、5.36和5.54。同一家机构、跨两条县界,差距约9%。而机构之间差距是165%。
接着我固定了餐厅。Subway就是Subway:同样的企业流程、同样的设备、同样的审核制度。
| 连锁品牌 | Boulder | Tri-County |
|---|---|---|
| Subway | 2.42 | 4.41 |
| Starbucks | 0.65 | 2.18 |
| Chipotle | 0.69 | 1.94 |
| McDonald’s | 1.47 | 3.11 |
| Taco Bell | 1.00 | 3.36 |
| Wendy’s | 0.11 | 4.47 |
| 合计 | 1.15 | 3.16 |
九个连锁品牌,九个方向一致,合计2.76倍。到这一步,我确信科罗拉多州两个相邻的卫生部门在执法上存在真实差异。
这个数字是个分数,而我只有分子
Boulder每个检查表项目发布一行,每行带一个状态。Tri-County每次检查发布一行,带56个二元标记。
差别在于每种格式能表达什么。
| 检查员记录了什么 | Boulder | Tri-County |
|---|---|---|
| 已开单 | Out、Out-High、Out-Medium、Out-Low |
标记 = 1 |
| 看过了,没问题 | In |
无法区分 |
| 没看 | Not Observed |
无法区分 |
| 此处不适用 | Not Applicable |
无法区分 |
Boulder既能表达「我查过了,没问题」,也能表达「我从没查过这一项」。Tri-County的格式把两者都压缩成一个零。
于是我统计了Boulder的检查员实际评估了表格的多少内容:
| 表格项目数 | 已评估项目数 | 违规项 | 每个已评估项目的比率 | |
|---|---|---|---|---|
| Boulder | 56.8 | 24.1 | 2.10 | 8.7% |
| Tri-County | 56 | 无法得知 | 5.57 | 若全部56项则为9.9% |
Boulder的检查员有58%的表项完全没动。用实际查看过的项目作分母,2.65倍就变成约1.14倍。
就连这个数字也夸大了残余差异,因为Tri-County的分母无法还原。如果他们的检查员也只评估约24项,那他们的真实比率大约是23%,是Boulder的两倍多,效应的方向就反过来了。Boulder的比率有界,Tri-County的没有。
马里兰州的Montgomery County用的是15项的表格,同样有这三类词汇,标记为「Not Observed」的项目占2%到6%,而Boulder是58%。并不存在可供归一化的全国惯例,而这正是任何比较已公布数量的人都看不到这一点的原因。
同样的问题在时间维度上也会出现
如果这个数字会随记录惯例变化而变化,那么只要某个辖区改变了记录方式,这个数字在该辖区内部也应该会变。
加州Marin County公布了12年的检查数据。按年份统计的每次例行检查违规项数量:
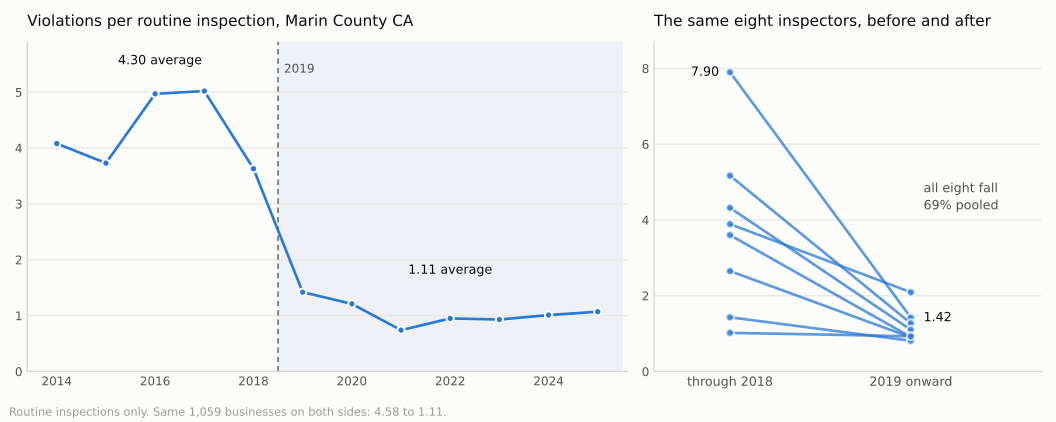 左图:序列在2019年断裂,之后再未恢复。右图:横跨断点两侧工作的每一名检查员数值都下降。
| 2014 | 2015 | 2016 | 2017 | 2018 | 2019 | 2020 | 2021 | 2022 | 2023 | 2024 | 2025 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 4.08 | 3.73 | 4.97 | 5.02 | 3.63 | 1.42 | 1.21 | 0.74 | 0.95 | 0.93 | 1.01 | 1.07 |
跨一个年度边界,从4.30降到1.11。 同期检查量反而上升,例行检查从2018年的1,351次增加到2019年的1,514次。违规代码词汇没有变化。评级公示牌项目从2015年起就已在运行。
Marin在每一行都写明检查员姓名,这是几乎没有辖区会做的事。于是我可以检查员工是否更换过。在断点两侧各有至少40次例行检查的检查员:
| 检查员 | 2019年前 | 2019+ | 变化 |
|---|---|---|---|
| A | 7.90 | 1.42 | −6.48 |
| B | 5.17 | 1.27 | −3.90 |
| C | 4.32 | 1.10 | −3.22 |
| D | 3.89 | 2.09 | −1.79 |
| E | 3.60 | 0.91 | −2.68 |
| F | 2.65 | 0.90 | −1.75 |
| G | 1.43 | 0.81 | −0.62 |
| H | 1.02 | 0.93 | −0.09 |
八个人里八个人都下降。合计为−69%。检查员A是同一个人做同一份工作,从每次检查7.90个违规项降到1.42。
再固定餐厅:在断点两侧都接受过检查的1,059家商户,从4.58降到1.11。
同样的人。同样的餐厅。同样的代码。违规项只剩四分之一。
真正改变的东西,在检查如何被归类上看得出来。什么问题都没发现的比例几乎没动,从11-16%变为13-26%。归类为重大的比例从23-39%降到8-15%,差额被轻微类吸收,而每次有违规的检查所列明的违规项数量从约4.1-5.8降到1.1-2.1。检查发现问题的概率基本稳定,而每次检查记录下来的问题数量崩塌了。
验证我看到的是不是一次数据迁移
能推翻这一结论的解释是数据来源。如果2019年前的记录来自另一个系统并被迁移进来,那这个断点就是数据集的产物,而不是执法实践的变化。
三项检验,结果都是否定的:
记录ID是连续的。 全部13年是一个单调递增的序列,边界处区间还有重叠:2018年跨25,039到37,081,2019年跨24,518到42,338。没有重新开始,也没有断档。
数据结构没有变动。 inspector、placard、correct_by_date、corrected_on_site、inspector_comments、inspection_frequency和license_number在2014到2026年的每一年都是100%填充。唯一变化的字段是违规代码,从96-97%变为67-90%,而这本身就是发现的结论,而非结构变化。
导出指纹的变化出现在别的地方。 这个数据集里有些字符串值被字面的引号字符包住。这个痕迹在2024年之前的行里占0%,2025年占83%,2026年占100%。
最后这一条是这里最有力的证据。数据管线确实发生过变化,是在2025年,不是2019年。如果那74%的下降源自迁移,格式特征就会跟着一起变动。
它也造成了我遇到的第一个bug。按检查员分组时不剥掉这些引号,会得到46名检查员。实际只有40名。其中六人是同一批人出现了两次,一次带引号,一次不带。
像Marin这样的断点有多常见
到这一步,一个合理的质疑是:我是去找不连续点的,所以找到了一个;而卫生部门本来就不停修改自己的文书。于是我用同样的方法检查了另外三条长期序列。
| 辖区 | 指标 | 时间跨度 | 最大的单年变动 |
|---|---|---|---|
| 科罗拉多州Boulder County | 每次例行检查的违规项数量 | 2013-2025 | 13年间在1.60到2.35之间,无断点 |
| Chicago | 检查不合格的比例 | 2010-2026 | 16.0%到24.9%,缓慢漂移,无断点 |
| New York City | 被标为严重的违规项比例 | 2022-2026 | 52.4%到56.7%,无断点 |
Marin是异常值。Boulder是干净的对照,因为它是同一指标、跨越更长的时间,而且年度间变动从未超过约20%。
关于那张表有两点说明。Chicago的合格/不合格和NYC的严重项比例都是比违规项数量更粗的工具,一个部门完全可以改变列明违规的细致程度,而这两个指标都不动。另外NYC公布的序列只回溯到2022年,这几乎算不上检验。
综合来看:像Marin这样的断点不是这类数据的常态,但也没有稀少到可以假装不存在。我手上有长期序列的四个辖区里就有一个存在这种断点,而已公布的数据里没有任何地方对此作出提示。
这也加强了科罗拉多州那组比较的可信度。Boulder在13年里保持平稳,说明2.65倍差距中它这一侧并不是我恰好挑了哪些年份造成的产物。
谁上门的预测力几乎和是哪家餐厅一样强
Chicago把自己的检查优先排序模型开源了,一份独立评审发现最大的单一影响来源是由哪位卫生员执行检查。那是内部数据。Marin的检查员字段让这一点可以在公开数据上检验。
在15,888次例行检查、1,645家商户和40名检查员中,各检查员的原始均值从0.74到5.99。其中大部分来自时期因素,因为检查员的工作时段不同,而2019年的断点正好落在中间。
于是我减去商户均值,使用的是由两名以上不同检查员检查过的1,453家商户,然后再减去年份均值:
| 控制项 | 检查员之间的差异 | 标准差 |
|---|---|---|
| 原始 | 8.1倍 | 1.41 |
| 减去商户均值 | 5.18个违规项 | 1.27 |
| 减去商户与年份均值 | 3.81个违规项,为均值2.22的172% | 0.86 |
在年份控制下排序被打乱,这正是排除纯时期解释的依据。控制后最严格的检查员是2025年才开始工作的,处在断点的宽松一侧。最宽松的那位在2018-2019年工作,处在严格一侧。
原始序列上的粗略方差占比:商户身份约占24%,检查员身份约占21%。
这只是算术去均值,不是拟合模型,所以请把它当作方向和量级,而不是标准误。检查员与年份部分共线,横跨断点的那八名检查员承担了主要的识别作用。另外两项发现没有这个问题,因为它们是在严格控制下的原始均值。
由此得出的结论
三个维度,这个数量在每个维度上都失效。跨辖区,它因记录惯例而变动2.65倍。跨时间,同样的人检查同样的餐厅,它变动74%。跨检查员,控制后它变动达到均值的172%。
这些都不衡量检查制度是否有效。检查员确实发现真实问题、关停真实厨房,而这里的内容对此既不支持也不反对。我衡量的是这个数字,而这个数字恰恰在你把一个和另一个作比较时失效,而这正是下游所有人唯一会用它做的事。
真正的风险出在查询类应用的下游:以违规结果训练的城市预测模型,以及跨地区或跨某个政策日期比较评级制度的研究。Chicago的模型就是用这类结果训练的,而它自己的审核发现检查员是首要预测因子,当目标变量的一部分只是文书工作时,这正是你会预期到的。一项研究若跨越了某个辖区自身的记录方式变化,就会直接撞上Marin问题,因为现实静止不动,序列却在移动。
实用版结论:违规项数量只在单一辖区、单一时期、并针对是谁上门作出调整之后才可解读。别处都不行。如果你要基于这类数据做东西,首先要检查的不是数字,而是你的数据源能否表达「未观察」,以及这个惯例在你的时间窗口内有没有保持不变。
这些都不是餐厅独有的。一个公布出来的计数记录的是某个机构写下了什么,而我看过的四个部门里有一个改变了自己的记录方式却没有说明。
如果你知道2019年Marin County到底发生了什么变化,我很想听,我会更新本文。这里的每一个数字都可以用代码对着实时API重新生成,欢迎核查我的工作。