为什么有些 YouTube 评论点赞更多:主要看时机
简而言之
- 在 135 万条带发布时间的 YouTube 评论上,曝光解释了同一视频内评论点赞排序的 83.5%,内容只解释约 8%。
- 公开的评论语料有点赞数却没有时间戳,因此在其上训练的模型学到的是时机。我自己采集了一份带时间戳的语料并公开发布。
- 82% 的评论零点赞,前 1% 占据了 95% 的点赞,所以用均值看不出任何到达时间效应,而对数点赞数却显示出 5.9 倍的下降。
- 对个人的建议:在热门视频发布后的第一小时内评论。表现最好的评论是对某个瞬间的简短回扣。
我想知道能不能训练一个模型,写出人们真正会点赞的 YouTube 评论。最显然的训练信号就是点赞数,而且已有近期研究正是这么做的:在点赞数前 10% 的评论上微调,报告的互动量大约是在随机评论上训练的模型的 3 倍。
然后我看了看点赞数究竟在衡量什么。一条在视频发布后第一小时内发出的评论,被看到的人数比一周后发出的高出几个数量级,而 YouTube 的「热门评论」排序又会放大这一点,因为排名靠前带来点赞,点赞又带来排名靠前。两条完全相同的评论,仅凭到达时间就能相差三个数量级。
于是问题不再是「模型能不能写出好评论」,而变成了「点赞数里到底有没有关于评论本身的信息」。
用公开数据回答不了这个问题
两个大型公开 YouTube 评论语料 YT-30M 和 YTCommentVerse 合计约有 3200 万条评论。两者都给了 upvotes,都没有给时间戳。
没有发布时间,你就无法把评论说了什么和它何时出现分开。在这些语料上训练出的每个模型,都在拟合那份先发优势,却无从察觉。
所以我采集了一份带时间戳的语料:来自 34 个频道、633 个视频的 1,345,353 条顶层评论,包含发布时间、抓取时间、回复数、视频统计数据,以及 YouTube 自家算法给每条评论的排名。历时三天,约 14,900 个 API 配额单位。
有一个决定比其他都重要。commentThreads.list 按从新到旧返回评论,所以任何按视频设置的分页上限都会丢掉最早的评论,而那正是本研究关注的高曝光评论。每个视频都被完整枚举。体量太大、无法在当日配额内跑完的视频会提前排除,并计入清单,而不是被悄悄截断。
曝光占其中的 83.5%
预测每条评论在其所属视频内的点赞排名,这样就把视频层面的效应从训练信号里剔除了。然后逐项加入:先是曝光特征,再是长度和形态,接着是 20 万个 TF-IDF 特征,最后是 MiniLM 嵌入。按频道划分,绝不按评论划分,这样问的就是模型能否迁移到从未见过的受众。
| 成分 | 在高于随机水平的排序能力中的占比 |
|---|---|
| 曝光(发布时间、视频体量) | 83.5% |
| 长度与形态 | 8.4% |
| 评论实际说了什么 | 8.2% |
评论长度也可以算作内容而非曝光。按那样算,内容就升到 16.5%。无论怎么算,曝光都是 83.5%,所以这个结论不取决于你把界线划在哪里。
让我下定结论的数字是:一个 384 维的句子编码器相对词袋模型只带来 0.0015 的 AUC 提升。对词汇层面零结果的常见反驳是文本模型太弱,而一个完全不同的表示族落在了同一个位置。
绝对可预测性始终很低。最好的模型 AUC 为 0.671,随机水平是 0.5。曝光大幅胜过内容,而两者都不及其他决定哪些评论会被点赞的因素。
这份数据集里的陷阱
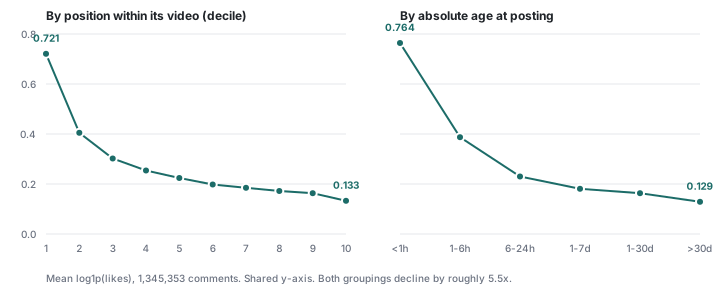 两幅图为同一批评论、同一纵轴。视频内的位置和绝对时长都呈现出同样的下降。
我一开始弄错了,在你动手处理数据之前应该先知道这一点。
按评论发布得多晚来分桶,取每桶的平均点赞数:
| 发布时的年龄 | <1h | 1-6h | 6-24h | 1-7d | 1-30d | >30d |
|---|---|---|---|---|---|---|
| 平均点赞数 | 19.8 | 21.7 | 19.5 | 19.8 | 25.8 | 20.4 |
一条平线。完全没有到达时间效应。我还把这当成一项结论写了出来。
现在在完全相同的分桶上取 log1p(likes) 的均值:
| 发布时的年龄 | <1h | 1-6h | 6-24h | 1-7d | 1-30d | >30d |
|---|---|---|---|---|---|---|
| log1p(likes) 均值 | 0.764 | 0.387 | 0.230 | 0.181 | 0.163 | 0.129 |
5.9 倍的下降。这个效应一直都在。
82.1% 的评论零点赞,而前 1% 占据了全部点赞的 94.9%。在这样的分布上取组均值,得到的是关于该组离群值的统计量,而不是关于该组本身。一条爆火评论就决定了整个桶的平均值。
任何对原始点赞数取平均的语料摘要,都会在效应明显存在的地方报告出无效应。
那个认证出 3 倍的指标
先前的研究是这样给生成的评论打分的:把它嵌入,从参考语料中取出 K 个最近邻,再对它们的点赞数取平均。我原以为这可以靠相似度来钻空子:在高赞文本上训练,落到高赞文本附近,不管人类是否真会点赞都能拿高分。
我错了两次。挑出真实的高赞评论并不能复现 3 倍的比值(我得到的是 0.88 到 1.21)。生成 960 条评论、其中一半用高赞样例做少样本条件化,也复现不出来。
我发现的反而是这个统计量根本不稳定。在 K=5 时,均值之比说条件化让结果差了 3 倍,且置信区间不含 1.0。而在同样的 480 个样本上,中位数之比却说好了 2 倍。三次运行中,同一个数字先是 138,然后 0.09,然后按均值算 0.25、按中位数算 2.00。
同样的重尾分布,同样的失效模式,和我上面自己犯的错误一模一样。一个方向会随汇总方式翻转的指标,承载不了 3 倍的结论,不管某个已发表的具体数字是怎么来的。
它也几乎追踪不到它想估计的东西。相对真实点赞结果,它对评论的排序只有 Spearman 0.050。而一个只知道评论何时发布、视频有多大的模型,在同样的评论上能拿到 0.19。
如果你只想让自己的评论被看到
把同样的数字对准个人而非模型,就成了一套策略。大致按影响力大小排列:
要早。在同一视频内,最早那一成的评论平均是最晚那一成的 5.4 倍。按绝对时长看,第一小时的评论比一个月后发布的高出 5.9 倍。你能控制的其他因素都远不及此。
在热门视频上抢早。视频体量会放大其他一切。在原始数据里,NileRed 某个视频上迟了六周发布的评论,仍胜过 Computerphile 视频上第一小时的评论。在 500 万播放的视频下一条平庸评论,胜过 7 万播放视频下一条好评论。
首页才是真正的奖品。展示在首页上的评论平均有 419.5 个点赞,其余的只有 1.13。这是一道 373 倍的门槛,不是渐变曲线,而由于排序依赖早期点赞,第一小时才是买到入场券的关键。
挑频道。零点赞评论的占比从 Vox 的 52.8% 到 Davie504 的 90.7%。在你写下一个字之前,你拿到任何点赞的概率就因评论地点不同而差近一倍。
在 Shorts 上要更快。那里的早期优势是 7.6 倍,长视频是 5.3 倍。
你写什么大约只占 8%。它的形态是短。评论平均长度随点赞数上升,然后反转:在 100-999 这一档是 171 个字符,到 1000+ 降到 147。语料中的顶级评论是对某个具体瞬间的压缩式回扣,而不是展开的观察:
炼金术士最讨厌这一招
这个视频基本全是灰度的
那句硬憋出来的「支持本地小店」把我笑到了
引一个瞬间,压缩它,收笔。
有两点重要的限制。所有评论中 82% 零点赞,而即便用上我构建的全部特征,模型的排序也只有 AUC 0.671,所以其中大部分是你控制不了的方差。而且我衡量的是什么能预测点赞,不是什么导致点赞。时机效应大概是因果的,因为它就是机械的曝光。「简短回扣」则很可能只是别的东西的相关项。
诚实的总结是:取胜策略主要是后勤,而不是写作。
结论落在哪里
以点赞数为目标优化评论生成器,主要是在对着一只钟做优化。在高赞评论上训练的模型,学到的是热门视频上早期评论长什么样,而能归因于评论内容本身的部分只有约 8%。
这并不意味着评论质量无法衡量。它意味着衡量必须先对曝光做条件化,而在此之前没有任何公开数据集让你做到这一点。我接下来想做的,正是我做不到的那一块:在曝光固定的条件下让人类给评论打分,这份语料让它成为可能,但本身并不包含它。
数据集已发布在 Hugging Face,采用 CC BY 4.0 许可;代码和冻结的总体清单在 GitHub;论文里有完整的递进流程、数据划分,以及我弄错的那些部分。