Stockfishの並列解析をスケールさせる
要点
- バッチStockfishパイプラインは、1台のウェブサーバーでの毎秒4局面から、クラウドCPUワーカーでの47〜60局面へ向上し、深さ18・MultiPV 3で251,166件の評価を処理した。
- 改善をもたらしたのはワーカーを取り囲む台帳だった。キューとしての局面キー、再試行単位としてのバッチサイズ、冪等な書き戻し、各ジョブ前のコスト上限である。
- 深さは時間予算ではない。あるバッチは1,800秒のタイムアウトに突き当たっていたが、無関係な各局面にそれぞれ独立したエンジンゲームを与えたところ、遅かった局面は1秒未満で終わった。
- より安価なワーカーとバッファ付き書き戻しにより、モデル上のコストは1局面あたり約$0.0000053まで下がった。
結果: Stockfish解析パイプラインは、1台のウェブサーバーでの 4.00 局面/秒から、クラウドCPUワーカーで安定して 47-60 局面/秒になった。ロールアウトは Stockfish 18、深さ 18、MultiPV 3 という契約の下で 251,166 件の局面評価を完了した。
現在の本番設定はバッチサイズ 32、max_containers=100、1局面あたり 300s の上限、そしてバッファ付き書き戻しである。以前の直接書き戻し実行は1局面あたり約 $0.0000200 とモデル化されていたが、現在の cpu=0.25 のバッファ経路は $0.0000053 に近い。
興味深かったのは、Stockfishが並列に走ることを証明した点ではない。チェスの局面はすでにエンジン作業の独立した単位である。難しかったのは、コストに上限を保ち、失敗を回復可能にし、深さの意味づけを正確に保てる動作点を見つけることだった。
ここでの実装はコントロールプレーンにRailway、StockfishワーカーにModalを使ったが、再利用できるのはワークロードモデル、測定方法、失敗時の制約である。
転用できる教訓: ワーカー数の最大化から始めてはいけない。エンジン契約、再試行単位、書き戻し契約、測定台帳を定義することから始める。その後で並列度を上げる。
これが最も当てはまるのは大量のオフライン解析である。独立した局面が多数あり、品質要件が厳しく、再試行が生の速度と同じくらい重要になるだけの作業量がある場合だ。レイテンシが支配的な単一対局のインタラクティブ解析にはあまり関係しない。
計測した本番設定:
| 設定 | 値 |
|---|---|
| エンジン | Stockfish 18 |
| 深さ | 18 |
| MultiPV | 3 |
| ワーカーCPU | 0.25 |
| バッチサイズ | 32 |
| 最大コンテナ数 | 100 |
| 1局面あたりの上限 | 300s |
| 書き戻しモード | バッファ付き |
| 広域実行のスループット | 47-60 局面/秒 |
| モデル上のコスト | 完了局面1件あたり約 $0.0000053 |
決定の記録:
| 決定事項 | 現在の値 |
|---|---|
| 作業単位 | ゲームIDではなく position_key |
| 品質契約 | 要求値は Stockfish 18、深さ 18、MultiPV 3 |
| 現在の設定 | バッチ 32、コンテナ 100、300s 上限、バッファ付き書き戻し |
| この点を選んだ理由 | コストに上限があり、テールが再試行可能で、後片付けが確実、そして到達深さを全結果に記録できる |
| 再検討の契機 | プロバイダ上限の変更、キャッシュヒット率の上昇、書き戻しのドレインが支配的になる、あるいはテール局面が実時間を支配する場合 |
ワークロードの定義
ユーザーから見える対象はチェスの対局。計算の対象は局面である。
システムは対局を取り込み、局面を抽出し、position_key で重複排除し、欠けている局面を評価し、前後の局面が揃った時点で手ごとの評価値行を実体化する。
PGN games
  -> positions
  -> unique position keys
  -> Stockfish queue
  -> position eval cache
  -> move-level eval rows
  -> reports, drills, prep, review
本番契約は Stockfish 18、要求深さ 18、MultiPV 3 で、position_key でキューに入れ、SQLiteを真実の源、クラウドCPUコンテナをワーカープールとした。
評価契約はデータモデルの一部である。 深さ 18、MultiPV 3 の行は、別のエンジン、別の深さ、別のMultiPV形状による公開キャッシュの行と互換ではない。将来のコードが計算済みの行、キャッシュヒット、より深い参照を区別できるよう、システムは出所を保存する。
手法
ほとんどの表では短い実行ラベルを使う。25g、100g、500g はその数の対局から用意した作業を意味する。b32 はバッチサイズ 32。c50 はワーカー上限 50。t300 は1局面あたり 300s の上限を意味する。
測定値には3つのラベルを使う。ワーカーや台帳の行は観測値、送信前のコスト見積りは推定値、CPU比率や書き戻し形状を変更した後の運用モデルはモデル値である。
スループットの数値は、実行が何を記録したかに応じて、送信の実時間またはサーバー側バッチのスパンを用いている。動作点を比較するには十分だが、普遍的なStockfishベンチマークを主張するものではない。
元のワークロードは私自身のチェス対局アーカイブである。本番データベースはジョブ、バッチ、キュー状態、実体化した評価値の件数、ワーカー実時間、書き戻し時間、コスト見積りを記録した。プロファイル専用の深さ実験は同じワーカー経路を通ったが、結果は本番の評価値テーブルには書き込んでいない。
件数についての注意が1点。ベースラインのステータス行と最終的なワークロード件数は同じ単位ではない。ベースラインの行は旧来のユーザー単位バックフィル経路のフェーズカウンタだった。最終の 251,166 という数字には、局面キーの重複排除、前後の局面評価、再計算作業、再試行、手ごとの評価値の再利用が含まれる。対局数や手数ではなく、最終的に解析したワークロードの規模として読んでほしい。
生の実験表はダウンロード可能な成果物としては公開しない。この記事には論旨に必要な計測行を含めており、運用者向けの完全な台帳はプロジェクトのノートに残す。
ベースライン
ベースライン: 4.00 局面/秒、実行中も 9.1h の完了予測が表示されていた。
元の経路はRailwayのウェブランタイム内でStockfishを走らせていた。小さなインポートには単純で十分正しかったが、大きなアーカイブには形が合っていなかった。
稼働中のステータス行はこう見えた。
stockfish phase: 6350/137250 (cache=6043, errors=0) 4.00/s ETA 9.1h
その行は正確だった。同時に上限も示していた。より大きなウェブインスタンスならスループットは線形に改善するが、作業は依然として1つの長時間プロセス、1つのデプロイライフサイクル、1台のマシンに縛られたままだ。
このバッチワークロードに必要だったのは、ワーカー容量で上限を設けた並列性、バッチまたは局面単位に限定された失敗、ジョブごとのコスト上限、そして永続的なキュー状態だった。最初のスケーリング目標は、回復に十分な状態を伴う計測可能なスループットだった。
コントロールプレーン
ワーカーを増やすなら台帳が必要になる。 台帳こそが主要なインフラだった。
コントロールプレーンは主に5つのテーブルを使った。
analysis_jobs: 親リクエスト、送信者、目的、エンジン契約、コスト上限、集約ステータス。analysis_job_batches: ワーカーシャードのステータス、受理件数、実体化件数、ワーカー実時間、書き戻しのタイミング。analysis_queue: 局面キーのステータスと正規化された評価結果。analysis_requests: 誰がどの局面をなぜ要求したか。evals: レポートや学習用面のための、手単位の実体化行。
ワーカーが作業を発見することはなかった。コントロールプレーンが局面キーを確保し、ジョブ行とバッチ行を作り、確保したキーをワーカープールに送った。所有権、ステータス、上限、再試行、実体化については、データベースが真実の源であり続けた。
親ジョブのカウンタは最終的に正規のバッチ行から導出するようにした。書き戻しは実質的に少なくとも1回の配送であり、クライアントの再試行によって同じ完了済みバッチのペイロードが再送されうるからだ。
SELECT
  SUM(accepted) AS accepted,
  SUM(materialized) AS materialized,
  SUM(CASE WHEN status != 'completed' THEN 1 ELSE 0 END) AS open_batches
FROM analysis_job_batches
WHERE job_id = ?
重複したコールバックに手作業の監査が必要なら、そのスループットの数値は信頼できない。
スループットの結果
安定した向上幅は、単一サーバーのベースライン比でおよそ 12-15x だった。
信頼できるスループット向上は、バッチサイズ、コンテナ上限、1局面あたりの時間上限、データベースクエリの形状、コールバックの冪等性という複数の変数を同時に変えたことで得られた。
純粋なワーカー数のベンチマークではなく、チューニングの段階表として読んでほしい。
| 実行形状 | 受理件数 | バッチ数 | 実時間/スパン | スループット | 推定コスト |
|---|---|---|---|---|---|
25g b32 c25 |
3,006 |
94 |
206.344s |
14.57 局面/秒 |
$0.06012 |
100g b32 c50 |
12,701 |
397 |
365.205s |
34.78 局面/秒 |
$0.25402 |
100g b32 c100 t300 |
10,282 |
322 |
216.439s |
47.50 局面/秒 |
$0.20564 |
500g b32 c100 t300 |
45,429 |
1,420 |
752.324s |
60.39 局面/秒 |
$0.90858 |
最終の広域チャンクも同じ帯域に収まった。
| ジョブ | 受理件数 | スパン | スループット |
|---|---|---|---|
30 |
45,429 |
752.324s |
60.39 局面/秒 |
31 |
38,248 |
~663.0s |
57.69 局面/秒 |
32 |
32,857 |
~599.0s |
54.85 局面/秒 |
33 |
27,650 |
~562.0s |
49.20 局面/秒 |
34 |
22,371 |
~444.0s |
50.39 局面/秒 |
35 |
15,951 |
~326.0s |
48.93 局面/秒 |
36 |
3,403 |
~72.0s |
47.26 局面/秒 |
本番設定は、失敗の診断が可能で後片付けが確実に行える範囲で最も並列度が高い構成だった。内部の実行台帳には、バッチ数、実体化した評価値、書き戻しの所要時間、コスト見積りも記録されている。
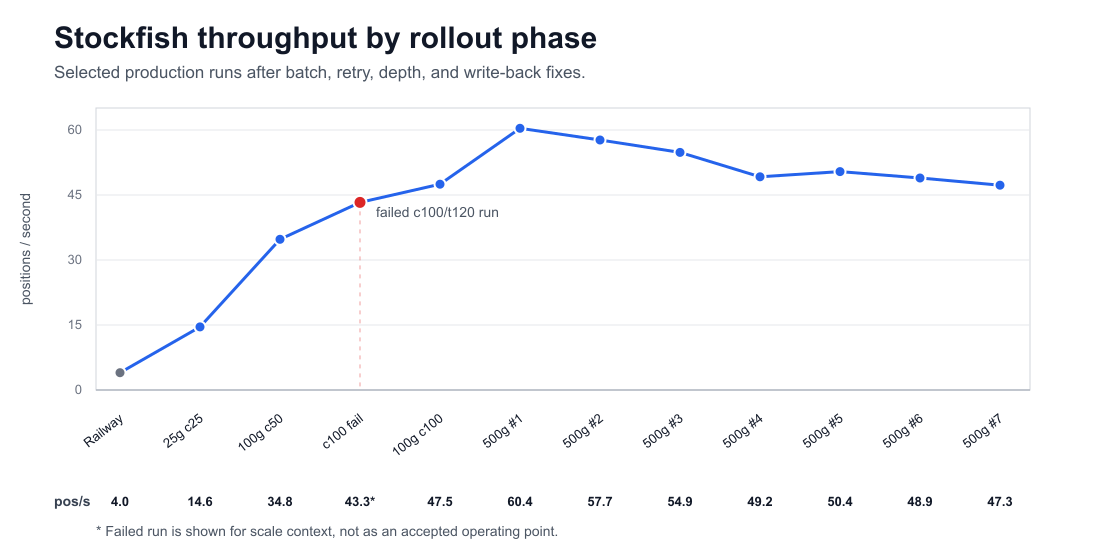 スループットが改善したのは、周辺のキュー、書き戻し、再試行の経路が本番規模の失敗に耐えられるようになった後だった。
バッチサイズ
バッチサイズは再試行の粒度である。 バッチを大きくするとスケジューリングとコールバックのオーバーヘッドは減るが、テールの失敗を切り分けるコストが上がる。
ロールアウトでそれが直接見えた。25g b64 c25 の実行は 44/45 バッチを完了し 2,767 局面を受理したが、1バッチが深さのガードで失敗した。その後のテール調査で、失敗範囲を 32 局面から 8 へ、さらに1局面まで絞り込んだ。
最終的なバッチサイズ 32 は妥協点だった。バッチサイズ 1 は診断には最適だが広域のオーケストレーションには高コストすぎる。8-16 は再試行の形として良い。64+ はバッチ数を減らすがテールの切り分けを悪化させる。再試行ツールは失敗した作業を単一局面まで分割できたが、それはわずかなスケジューリングのオーバーヘッドを削るより重要だった。
経験則: 無理なく再試行できる最大のバッチサイズを選ぶ。
ワーカー数
ワーカー数が効いたのは、コントロールプレーンがコールバックの流量を吸収できるようになった後だった。
コンテナ 25 から 50 への跳ね上がりは大きく、クリーンな50コンテナ検証で 34.78 局面/秒に達した。300s の上限をつけた100コンテナ実行は100対局のチャンクで 47.50 局面/秒に達し、最初の500対局チャンクは 60.39 局面/秒に達した。
計測された動作点は現在、プロバイダのワークスペース容量と単一の書き戻し先によって上限が決まっている。数百のワーカーがほぼ同時に終わる状況では、ワーカーからウェブへ直接コールバックする方式は長期的な書き込み経路としては不適切だ。バッファ付きシャードはバーストをModal Volumeに移し、その後サーバーが制御されたフェーズで結果をドレインする。
つまり max_containers だけが天井だったわけではない。ある点を越えると、次のボトルネックはスケジューリング、シャード処理、ドレイン速度、あるいはデータベースの実体化になる。
cpu=0.25 という設定が機能したのは、ワークロードに独立した局面が多数あり、正しさは到達深さの検証で担保されていたからだ。テール局面やプロバイダ上限がボトルネックになるまでは、十分な並列度を持つ安価なワーカーのほうが、少数の大きなワーカーより良い既定値だった。
コスト
コスト削減はワーカー形状と書き戻し形状から来たもので、解析基準を下げたからではない。 直接書き戻しの実行は、送信局面1件あたり約 $0.0000200 に落ち着いた。新しいスケジュール実行系は cpu=0.25 のコストスケーリングとバッファ付き書き戻しを使い、以前の見積りの約4分の1である。
| フェーズ | 例 | 局面数 | 推定コスト | コスト/局面 |
|---|---|---|---|---|
| 広域の直接書き戻しロールアウト | ジョブ 30 |
45,429 |
$0.90858 |
$0.0000200 |
バッファ付き cpu=0.25 経路 |
ジョブ 63 |
235 |
$0.001175 |
$0.0000050 |
実験期間のModalダッシュボードでは、リソース支出の合計が $17.43、うちCPUが $16.69、メモリが $0.74 と表示された。これには失敗したプローブ、プロファイリング、再試行、深さ実験、本番ロールアウト作業が含まれる。「この探索にいくらかかったか」に対する正しい数字であって、最終的な動作点の限界費用ではない。
規律となったのは、ワーカー送信の前にコスト上限を強制し、その見積りをジョブ台帳に書き込むことだった。
3つの数字は分けて扱うこと。送信前の推定コスト、実行後に観測されたプロバイダの請求額、そして再試行とキャッシュ再利用を経た受理局面あたりのコストである。それぞれ別の問いに答えている。
正しさの制約
エンジン契約には depth=18 以上のものが必要だった。
深さは実時間の予算ではない。深さだけを指定したStockfish呼び出しは、外側のプラットフォームのタイムアウトに殺されるまで走り続けうる。本番ワーカーには要求深さと1局面あたりの時間上限の両方が必要だった。
ワーカーには正しいエンジンのライフサイクル境界も必要だった。game= トークンを変えずに1つのStockfishプロセスを無関係なFEN間で再利用すると、python-chess はシャード全体を1つの暗黙のゲームとして扱った。無関係な局面の間に ucinewgame を送らなかったのだ。あるワーカーシャードは 1800s でプラットフォームのタイムアウトに達したが、64 局面すべてをローカルで再生すると約 91.8s で完了した。game= トークンを変えて ucinewgame を送るようにすると、問題の局面は1秒未満で [18,18,18] に到達した。
境界の修正は小さかった。
info = engine.analyse(
    board,
    chess.engine.Limit(depth=18, time=300),
    multipv=3,
    game=position_key,
)
重要なのはラッパーの具体形ではない。無関係な局面には無関係なエンジンゲーム識別が必要だという点である。
病的な局面
ロールアウトでは集約された失敗だけでなく実際の局面も記録した。重要なケースは2つのバケットに分かれた。
第一に、実際に消費する契約に対して厳しすぎる局面があった。この節の盤面は手番側から見た向きである。
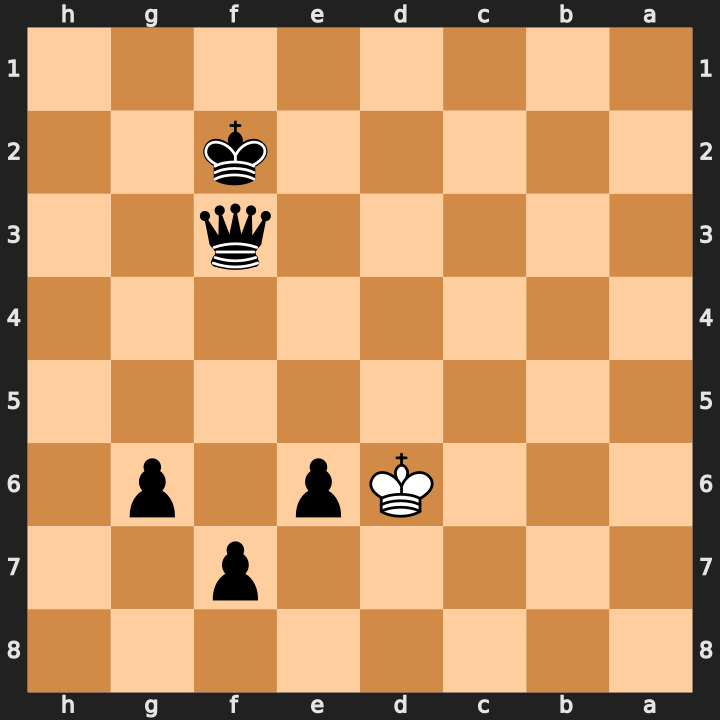
18に到達。代替手順は次で停止 17.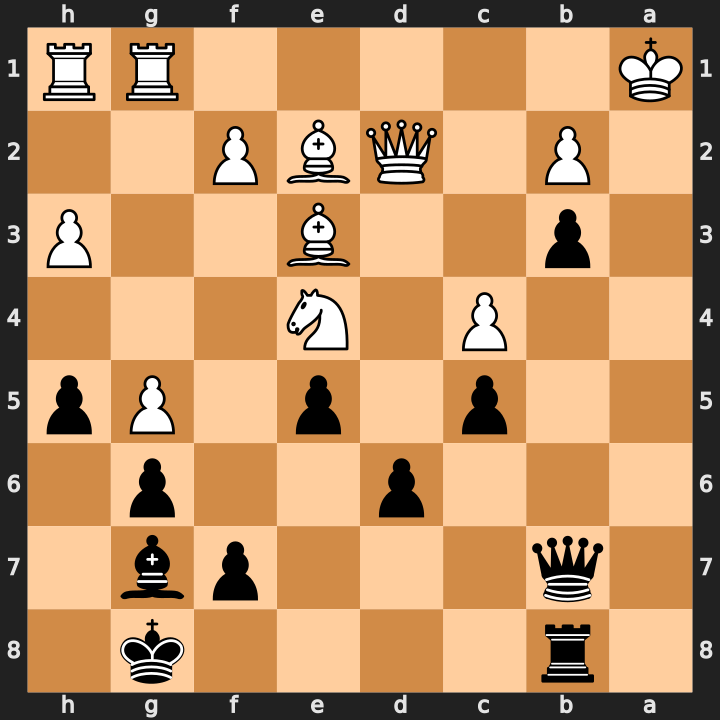
[15,15,14]のみ。低深さのフォールバックとして受理。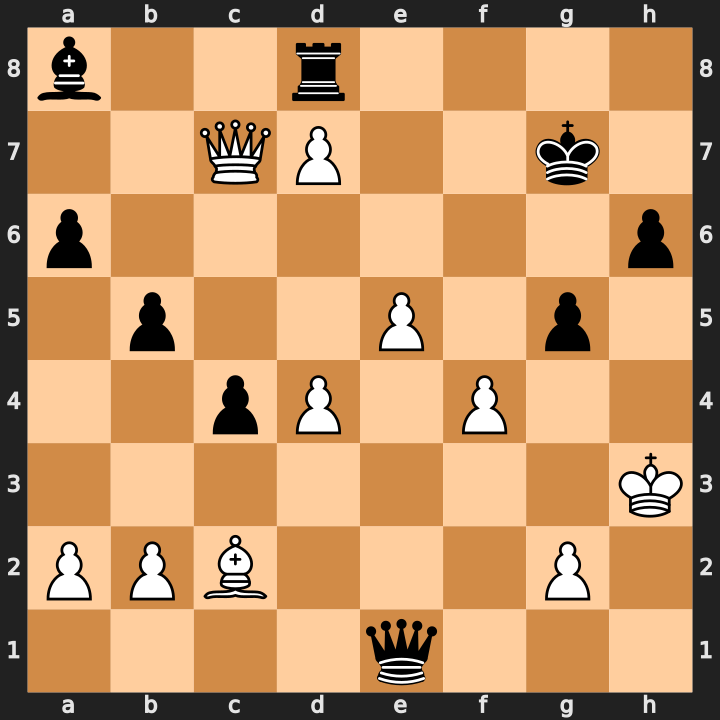
[17,17,17]。保存値は result_depth=17.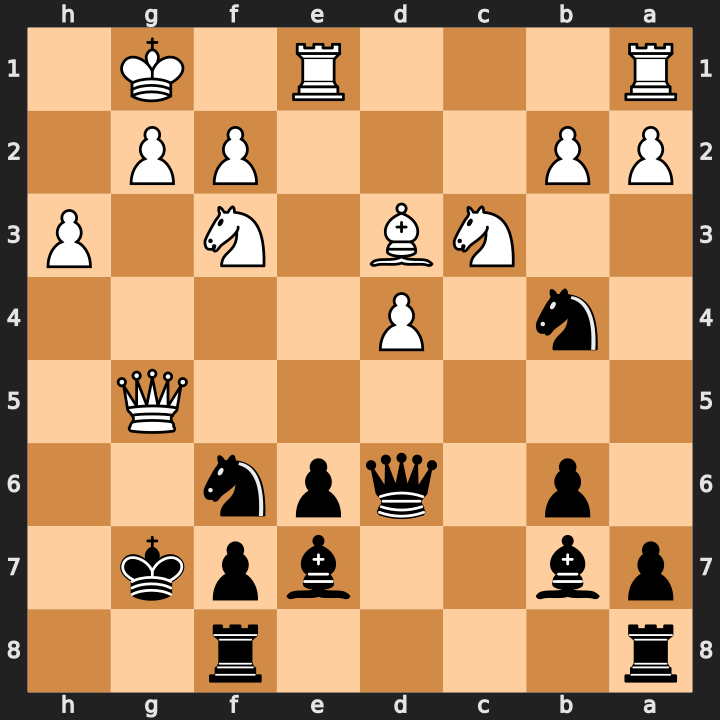
[17]。保存値は result_multipv=0/3.- MultiPVのテール。
失敗したバッチを
32 -> 8 -> 1と再試行して、この6駒のクイーンとポーンの終盤を切り分けた。Stockfishは深さ[18, 18, 17]を返した。最善手順は深さ18に達したが、3番目のPVは1手分浅いままだった。受理した行には最善手f3d5、評価値-8115cp、requested_multipv=3、result_multipv=2が記録されている。
FEN:8/5p2/3Kp1p1/8/8/5q2/5k2/8 b - -。 - Magnusの真に病的なテール。
120sと180sでの厳格な再試行でも、返ってきた深さは[15, 15, 14]のみだった。最終の非厳格フォールバックはresult_depth=15、最善手b7a7、評価値-933cp、そして低深さであることの明示的な出所を保存した。
FEN:1r4k1/1q3pb1/3p2p1/2p1p1Pp/2P1N3/1p2B2P/1P1QBP2/K5RR b - -。 - 低深さフォールバック1。
厳格な実行は
60.013s後に深さ[17, 17, 17]で停止した。フォールバック行はresult_depth=17、result_multipv=2/3、最善手h3g4、評価値-847cp、90,863,715ノードを記録している。
FEN:b2r4/2QP2k1/p6p/1p2P1p1/2pP1P2/7K/PPB3P1/4q3 w - -。 - 低深さフォールバック2。
厳格な実行は
60.010s後に深さ[17]で停止した。フォールバック行はresult_depth=17、result_multipv=0/3、最善手g7h8、評価値+761cp、89,579,084ノードを記録している。
FEN:r4r2/pb2bpk1/1p1qpn2/6Q1/1n1P4/2NB1N1P/PP3PP1/R3R1K1 b - -。
第二に、少なくとも1つの局面は悪いのではなく、最初の上限の下では単に遅かっただけだった。
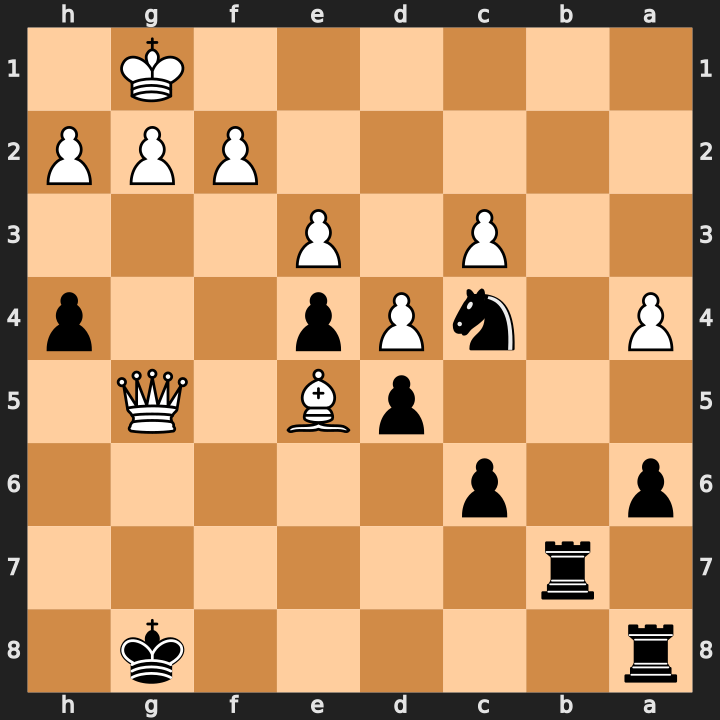
[18,18,18] (条件 300s.- 真の
120sテール。120sでは、ある単一局面の再試行が最善手順の深さ[17, 17, 18]を返し、近隣の31/32の再試行は速く完了した。300sの上限では、まったく同じ局面が140.171sで[18, 18, 18]に到達した。
FEN:r5k1/1r6/p1p5/3pB1Q1/P1nPp2p/2P1P3/5PPP/6K1 b - -。
こうした例は、受理した行のすべてが深さ 18、MultiPV 3 を満たしたふりをするのではなく、実際の結果深さと実際のMultiPV数を保存する理由を説明している。
ロールアウトではいくつかの失敗形状も記録した。
| 事例 | 兆候 | 解決 |
|---|---|---|
| エンジンのライフサイクル | あるシャードが 1800s のプラットフォームタイムアウトに到達。64 局面のローカル再生は 91.8s |
無関係なFENに別個の game= 識別を与え、ucinewgame が発火するようにする |
| MultiPVの深さガード | 32 -> 8 -> 1 の再試行分割で、代替PV手順が浅い合法局面を切り分けた |
実際に消費する最善手順を検証し、result_multipv を保存する |
| 真に遅いテール | 単一局面の再試行は 31/32 が速く完了。1件は 120s に間に合わなかったが 300s では 140.171s で完了 |
広域契約では1局面あたりの上限を高めに保つ |
| 低深さフォールバック | 切り分けた合法局面でも、フォールバック上限の下では深さ/MultiPVの目標をすべて満たせなかった | 明示的な result_depth と result_multipv の出所付きでのみ受理する |
| 深さのコストテール | サンプルでは深さ 36/MultiPV 1 が深さ 18/MultiPV 3 より 41.44x 遅かった |
すべてのキャッシュミスに対して深い再計算を既定経路にしない |
正しさのルール
最終的な正しさのルール。
- 無関係な局面ごとに新規ゲームの境界を送る
- 1局面あたりの時間上限を使う
- 消費する最善手順が要求深さに達したことを検証する
requested_multipvとresult_multipvを保存する- 親カウンタはバッチ行から導出する
- 完了したバッチ行は最終とみなす
主要で自明でない教訓: エンジンをバッチワーカーで走らせると、エンジンプロトコルの意味づけが本番の正しさになる。
ベンチマークが最終スループットだけを測り到達深さを無視すると、解析品質を静かに劣化させながら成功したように見えてしまう。
深さと品質のトレードオフ
深さを上げることはコストの乗数であり、無料の品質つまみではない。
10 局面のプロファイル専用サンプルで、複数の契約を比較した。
| エンジン契約 | ワーカー実時間 | 最も遅い局面 | 深さ18/MultiPV 3との比 |
|---|---|---|---|
深さ 18、MultiPV 1 |
5.301s |
0.571s |
0.51x |
深さ 18、MultiPV 3 |
10.329s |
2.442s |
1.00x |
深さ 24、MultiPV 1 |
24.861s |
5.728s |
2.41x |
深さ 24、MultiPV 3 |
56.252s |
13.428s |
5.45x |
深さ 30、MultiPV 1 |
87.375s |
16.263s |
8.46x |
深さ 36、MultiPV 1 |
428.071s |
106.782s |
41.44x |
これで本番の選択は明確になった。キャッシュミスは Stockfish 18、深さ 18、MultiPV 3 に保つ。出所が製品の必要と合致する場合は、より深い公開キャッシュのヒットを使う。個人対局のテール局面すべてに対して深さ 30+ や 36 を既定の再計算目標にはしない。
深さ 18 が普遍的に「十分」なのではない。曲線に値札をつけた結果、このワークロードに対して選ばれた既定の計算契約である。
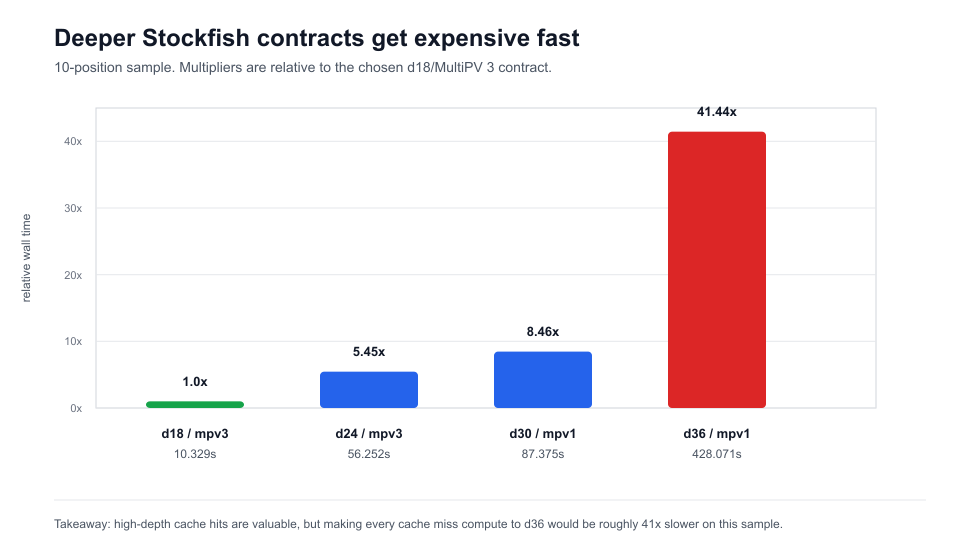 より深い解析は有用かもしれないが、コストの形をパーセントではなく倍数で変えてしまう。
キャッシュの挙動
ローカルの局面キー再利用は価値があった。公開キャッシュへの問い合わせは、大規模な準備処理のインラインに置ける段階になかった。
広域の準備処理では、ローカルキャッシュのリードスルーがクラウド計算の前に数千の手ごとの評価値を実体化した。これは有効にしておくべきだ。決定的で、ローカルで、同じ局面/評価契約に紐づいている。
公開のLichessやStockpile系のキャッシュ問い合わせには、初期テストで2つの問題があった。最初にサンプリングした 50 局面はヒットが 0 で、その後の健全性チェックでレート制限の挙動に当たった。つまり公開APIへの問い合わせが広域の本番準備処理をブロックしてはならない。
現行の方針。
- ローカル/グローバルの局面キャッシュのリードスルーを使う
- 公開キャッシュへの問い合わせは、大規模実行では上限付きかオフにする
- 再挑戦する前に、逐次的で永続的、バックオフを意識した問い合わせを追加する
- ソース、エンジンバージョン、深さ、MultiPV、取得時刻の状態、データセットのメタデータを保存する
- 私的な深さ18の行を、より深い公開の行と互換として扱わない
キャッシュはその契約が合うときに有用である。 キャッシュミス用の上限付き経路の代わりにはならない。
製品上のルール。キャッシュヒットは出所を伴う計算結果である。ソース、エンジン、深さ、MultiPV、レイテンシが製品の契約に合わないなら、キャッシュは任意の高速化手段として扱う。
このベンチマークの限界
これらの数値は有用な運用データであり、普遍的なStockfishベンチマークではない。
ワークロードは個人のチェスアーカイブ1つである。エンジン契約は Stockfish 18、深さ 18、MultiPV 3 に固定されている。実装はコントロールプレーンにRailwayとSQLite、そしてこのロールアウト期間に利用できたアカウント上限内のModal CPUコンテナを使った。深さ、MultiPV数、ハードウェア、局面分布、キャッシュヒット率、プロバイダ上限が変われば結果も変わる。
転用できるのは測定方法である。評価契約を定義し、ジョブとバッチの状態を記録し、出所を保存し、送信前に支出を制限し、ボトルネックを一度に1つずつ変える。
見つかったボトルネック
スケールが上がるにつれてボトルネックは移動した。
| ボトルネック | 症状 | 解決 |
|---|---|---|
| 単一のウェブCPU | 約 4 局面/秒、完了予測が数時間 |
独立した局面キーへファンアウトする |
| バッチのテール | 1つの遅い局面がシャードを占有した | バッチサイズ 32、再試行の分割、1局面あたりの上限 |
| エンジンのライフサイクル | ローカル再生は速いのにプラットフォームがタイムアウト | 局面ごとの ucinewgame 境界 |
| MultiPVの深さガード | 妥当な最善手順が却下された | 消費する手順を検証し、結果のMultiPVを保存する |
| SQLiteのキー集合サイズ | 500対局の準備処理がSQL変数の上限に当たった | クエリを分割し、一時テーブルを使う |
| 重複したコールバック | 親ジョブが過大計上された | カウンタを正規のバッチ行から導出する |
| 遅延したエラーコールバック | 完了済みバッチがエラー扱いになった | 完了した行は最終とする |
| 公開キャッシュのレイテンシ | 準備処理が停滞、あるいはレート制限された | 公開への問い合わせを上限付き・逐次的にする |
| デプロイのフィードバックループ | イメージのプッシュに 163s かかった |
重いMLスタックをウェブイメージから外す |
| ワークスペース上限 | 100コンテナ実行が実質的な天井になった | 上限を受け入れるか、より大きな計算容量を求める |
イメージサイズの修正はStockfishの計算とは関係ないが、反復速度には重要だった。ウェブイメージは 2.85 GB から 189.5 MB になり、イメージのプッシュは 163s から 8.1s に落ちた。
繰り返し現れたパターン: 1つのボトルネックが動いた後、次のボトルネックはたいていStockfishの外にあった。
計測した動作点
現在の本番設定で期待される挙動:
| 指標 | 期待される範囲 |
|---|---|
| 広域実行のスループット | 47-60 局面/秒 |
| 完了後のキューの後片付け | pending、running、errorの行が残らない |
| 大きめチャンクでの書き戻しp95 | 記録された実行では1秒未満 |
| 完了局面あたりのコスト | cpu=0.25 モデルで概ね $0.000005 |
これは安定した動作点であって、恒久的な最適解ではない。テール局面が実時間を支配する、ドレインの実時間が無視できなくなる、プロバイダの請求がモデルから乖離する、キューの行が古くなる、キャッシュヒット率が高く安定する、あるいはバッチプロバイダがアカウント上限を引き上げた場合に変更すること。
次の10倍の飛躍は、同じ上限内で max_containers を調整することからは、おそらく生まれない。 次の3つの変化のいずれかから生まれる。
- バッチプロバイダがワークスペース/コンテナの上限を引き上げる。
- ワークロードを独立した計算容量へ分割する。
- 出所互換のキャッシュでより多くの局面が満たされる。
それまでは、100コンテナのバッファ付き経路が本番の既定である。
転用すべきこと
長く残る部分は、特定のプロバイダや価格やバッチサイズではない。
| 原則 | 計測された実例 |
|---|---|
| まず評価契約を定義する | Stockfish 18、深さ 18、MultiPV 3 |
| 不変の作業単位をキューに入れる | ゲームIDではなく position_key |
| バッチサイズを再試行の粒度として扱う | バッチサイズ 32 が既定になった |
| 要求品質と到達品質を分ける | 要求深さ対到達深さ、要求MultiPV対結果MultiPV |
| 書き戻しを冪等にする | 親カウンタをバッチ行から導出 |
| キャッシュの出所を可視に保つ | ソース、エンジン、深さ、MultiPV、取得時刻のメタデータ |
| 送信前に支出を制限する | 各ジョブにコスト上限を記録 |
別のシステムがエンジンバージョン、目標深さ、ハードウェア、プロバイダ、局面分布を変えれば、計測値は変わるはずだ。原則は変わらないはずだ。
このベンチマークを再実行する
次のいずれかが変わったら再実行する。
- エンジンバージョンまたはUCIオプション
- 要求深さまたはMultiPV数
- 1局面あたりの時間上限
- CPU形状、ワーカー数、プロバイダ上限
- バッチサイズ
- 書き戻し経路
- キャッシュのソースとヒット率
- 局面の分布
ブリッツのアーカイブに最速の設定が、序盤データベースや終盤スタディ集、エンジン同士の棋譜集に最速とは限らない。最小限で有用なベンチマークのループはこうだ。
- 初期局面やテスト用FENだけでなく、実際のワークロードから局面をサンプリングする。
- 目標のエンジン契約と、少なくとも1つのより深い契約をプロファイルする。
- 小さなバッチの段階表を実行する。
1、8、16、32、64。 - 再試行と書き戻しが信頼できるようになった後で、ワーカー数の段階表を実行する。
- ワーカー実時間、送信スパン、書き戻し時間、残ったキューの行を別々に計測する。
- 送信前の推定コストと、事後の実際のプロバイダ支出を追跡する。
- スループットだけでなく、到達深さと保存された出所を検証する。
- プロバイダ、深さ、ワーカー形状を変えた後で同じサンプルを繰り返す。
教訓
- 計算をスケールさせる前にエンジン契約を定義する。
- 対局ではなく局面キーをキューに入れる。
- バッチサイズを再試行の粒度として扱う。
- 実時間の上限を加える。深さは予算ではない。
- エンジンのライフサイクル境界を正しさの要件として扱う。
- 冪等性を性能作業の一部にする。
- キャッシュの出所を可視に保つ。
- 本番チューニング中はデプロイのフィードバックループを最適化する。
後退させないこと。
- 無関係な局面には別個のエンジンゲーム識別を送る。
- 要求深さと到達深さを別々に保存する。
- 要求MultiPVと結果MultiPVを別々に保存する。
position_keyでキューに入れ、重複排除する。- バッチの書き戻しを冪等にする。
- 失敗したバッチは、より小さな粒度で再試行可能に保つ。
- 低深さのフォールバックは、深さ
18を満たしたものではなく明示的な出所として扱う。 - 本番実行は
pending=0、running=0、error=0で終える。