擴展平行化 Stockfish 分析
重點摘要
- 一條批次 Stockfish 流程,從單一網頁伺服器每秒 4 個局面提升到雲端 CPU 工作節點的 47 到 60 個,在深度 18、MultiPV 3 下完成 251,166 次評估。
- 增益來自工作節點周邊的帳本:以局面鍵作為佇列、以批次大小作為重試單位、冪等的寫回,以及每次工作前的成本上限。
- 深度不是時間預算。有一個批次撞上 1,800 秒逾時,直到每個彼此無關的局面各自擁有獨立的引擎對局為止;之後那個慢局面不到一秒就完成。
- 更便宜的工作節點搭配緩衝寫回,把建模成本壓到每個局面約 $0.0000053。
結果: Stockfish 分析流程從單一網頁伺服器的每秒 4.00 個局面,提升到雲端 CPU 工作節點上穩定的每秒 47-60 個局面。整個推行在 Stockfish 18、深度 18、MultiPV 3 的契約下完成了 251,166 次局面評估。
目前的正式環境設定為批次大小 32、max_containers=100、每局面 300s 上限,以及緩衝寫回。較早的直接寫回執行建模出每個局面約 $0.0000200;目前的 cpu=0.25 緩衝路徑建模接近 $0.0000053。
有趣的地方不在於證明 Stockfish 可以平行執行。一個西洋棋局面本來就是獨立的引擎工作單位。困難之處在於找出那個能讓成本受限、失敗可復原、深度語意正確的運作點。
這裡的實作以 Railway 作為控制平面、Modal 作為 Stockfish 工作節點,但可重複利用的部分是工作負載模型、量測方法與失敗限制。
可移轉的教訓: 不要一開始就去最大化工作節點數量。先定義引擎契約、重試單位、寫回契約與量測帳本,然後再提高並行度。
這最適用於大量離線分析:許多獨立局面、嚴格的品質要求,且工作量大到重試和純速度一樣重要。對於延遲主導的單局互動分析,相關性較低。
實測的正式環境設定:
| 設定 | 數值 |
|---|---|
| 引擎 | Stockfish 18 |
| 深度 | 18 |
| MultiPV | 3 |
| 工作節點 CPU | 0.25 |
| 批次大小 | 32 |
| 最大容器數 | 100 |
| 每局面上限 | 300s |
| 寫回模式 | 緩衝 |
| 大規模執行吞吐量 | 每秒 47-60 個局面 |
| 建模成本 | 每個完成的局面約 $0.0000053 |
決策紀錄:
| 決策 | 目前數值 |
|---|---|
| 工作單位 | position_key,而非對局 id |
| 品質契約 | 要求 Stockfish 18、深度 18、MultiPV 3 |
| 目前設定 | 批次 32、100 個容器、300s 上限、緩衝寫回 |
| 為何選這個運作點 | 成本受限、長尾可重試、清理可靠、每筆結果都記錄實際達到的深度 |
| 何時重新檢視 | 供應商上限改變、快取命中率上升、寫回排空成為主導,或長尾局面主導實際耗時 |
工作負載定義
面向使用者的物件是一局棋。運算的物件是一個局面。
系統匯入對局、擷取局面、依 position_key 去除重複、評估缺少的局面,然後在前後局面都具備後,具體化每一著的評估列。
PGN games
  -> positions
  -> unique position keys
  -> Stockfish queue
  -> position eval cache
  -> move-level eval rows
  -> reports, drills, prep, review
正式環境契約為 Stockfish 18、要求深度 18、MultiPV 3,以 position_key 排入佇列,SQLite 作為真實來源,雲端 CPU 容器作為工作節點池。
評估契約是資料模型的一部分。 一筆深度 18、MultiPV 3 的列,不能和來自不同引擎、深度或 MultiPV 形狀的公開快取列互換。系統會儲存來源資訊,讓未來的程式碼能區分自行計算的列、快取命中與更深的參考。
方法論
大多數表格使用精簡的執行標籤。25g、100g 與 500g 表示由該數量的對局準備出的工作。b32 表示批次大小 32。c50 表示工作節點上限 50。t300 表示每局面 300s 上限。
量測使用三種標籤:工作節點或帳本列為實測,提交前的成本估計為估計,而在改變 CPU 比例或寫回形狀後的運作模型為建模。
吞吐量數字依該次執行所記錄的內容,採用提交實際耗時或伺服器批次跨度。它們足以比較不同運作點,但不足以宣稱為通用的 Stockfish 基準。
來源工作負載是我自己的歷史西洋棋檔案庫。正式環境資料庫記錄了工作、批次、佇列狀態、具體化的評估數量、工作節點實際耗時、寫回時間與成本估計。僅供剖析的深度實驗走的是同一條工作節點路徑,但不會把結果寫入正式環境的評估資料表。
有一個計數上的注意事項:基準狀態列與最終工作負載計數不是同一種單位。基準列是舊的逐使用者回填路徑中的階段計數器。最終的 251,166 包含了局面鍵去重、前後局面評估、重新計算的工作、重試與著法評估的重複利用。請把它視為最終分析的工作負載規模,而不是對局數或著法數。
我不會把原始實驗表格作為可下載的產物發佈。本文包含了論證所需的實測列;完整的操作帳本留在專案筆記中。
基準
基準:每秒 4.00 個局面,執行途中仍可看到 9.1h 的預估完成時間。
原本的路徑是在 Railway 的網頁執行環境中執行 Stockfish。對小型匯入而言它簡單且足夠正確,但對大型檔案庫來說形狀是錯的。
即時狀態列長這樣:
stockfish phase: 6350/137250 (cache=6043, errors=0) 4.00/s ETA 9.1h
那一行是準確的。它同時也顯示出上限。更大的網頁機器能線性提升吞吐量,但工作仍然綁在單一長時間執行的程序、單一部署生命週期與單一機器上。
這個批次工作負載需要的是受工作節點容量限制的平行度、限縮在批次或局面層級的失敗、每個工作的成本上限,以及持久的佇列狀態。第一個擴展目標是實測吞吐量,並具備足以復原的狀態。
控制平面
更多工作節點需要一本帳本。 帳本就是主要的基礎設施。
控制平面使用五個主要資料表:
analysis_jobs:父層請求、提交者、用途、引擎契約、成本上限、彙總狀態。analysis_job_batches:工作節點分片狀態、已接受數量、已具體化數量、工作節點實際耗時、寫回時間。analysis_queue:局面鍵狀態與正規化後的評估結果。analysis_requests:誰為了什麼原因要求哪個局面。evals:供報表與訓練介面使用的著法層級具體化列。
工作節點不會自行尋找工作。控制平面認領局面鍵、建立工作與批次列,然後把這些已認領的鍵送往工作節點池。資料庫在所有權、狀態、上限、重試與具體化方面仍是真實來源。
父層工作計數器最終由標準的批次列推導而來,因為寫回實際上是至少一次語意:客戶端重試可能再次提交同一個已完成批次的內容。
SELECT
  SUM(accepted) AS accepted,
  SUM(materialized) AS materialized,
  SUM(CASE WHEN status != 'completed' THEN 1 ELSE 0 END) AS open_batches
FROM analysis_job_batches
WHERE job_id = ?
如果重複的回呼需要人工稽核,那個吞吐量數字就不可信。
吞吐量結果
相對於單一伺服器基準,穩定的躍升大約為 12-15x。
可靠的吞吐量增益來自同時改變多個變數:批次大小、容器上限、每局面時間上限、資料庫查詢形狀,以及回呼的冪等性。
請把這當作調校階梯來看,而不是純粹的工作節點數量基準。
| 執行形狀 | 已接受 | 批次數 | 耗時/跨度 | 吞吐量 | 估計成本 |
|---|---|---|---|---|---|
25g b32 c25 |
3,006 |
94 |
206.344s |
每秒 14.57 個局面 |
$0.06012 |
100g b32 c50 |
12,701 |
397 |
365.205s |
每秒 34.78 個局面 |
$0.25402 |
100g b32 c100 t300 |
10,282 |
322 |
216.439s |
每秒 47.50 個局面 |
$0.20564 |
500g b32 c100 t300 |
45,429 |
1,420 |
752.324s |
每秒 60.39 個局面 |
$0.90858 |
最終的大規模區塊都維持在同一區間:
| 工作 | 已接受 | 跨度 | 吞吐量 |
|---|---|---|---|
30 |
45,429 |
752.324s |
每秒 60.39 個局面 |
31 |
38,248 |
~663.0s |
每秒 57.69 個局面 |
32 |
32,857 |
~599.0s |
每秒 54.85 個局面 |
33 |
27,650 |
~562.0s |
每秒 49.20 個局面 |
34 |
22,371 |
~444.0s |
每秒 50.39 個局面 |
35 |
15,951 |
~326.0s |
每秒 48.93 個局面 |
36 |
3,403 |
~72.0s |
每秒 47.26 個局面 |
正式環境設定是在仍能診斷失敗、清理可靠的前提下,並行度最高的配置。內部執行帳本也記錄了批次數、具體化的評估、寫回時間與成本估計。
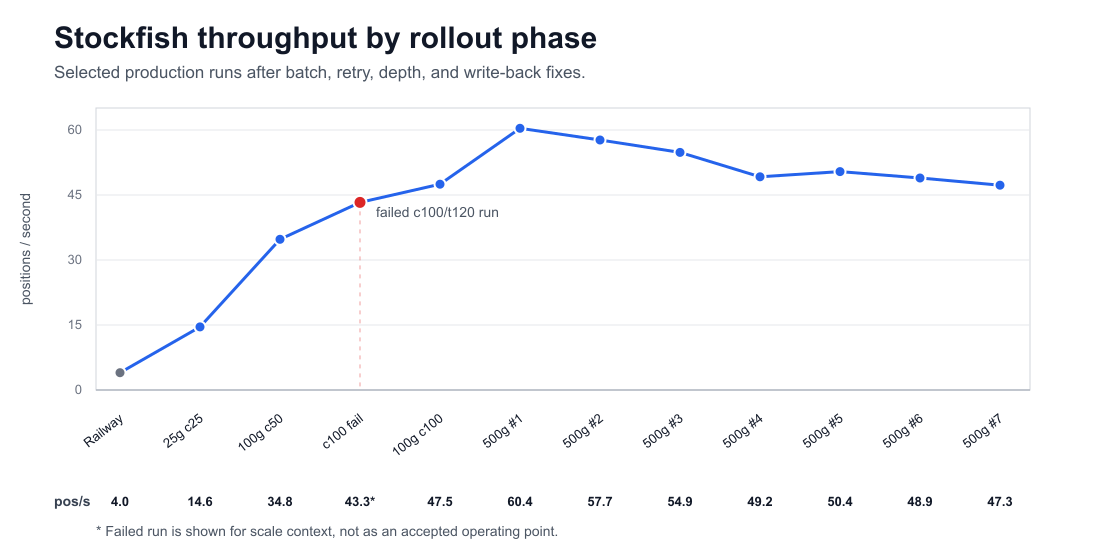 只有在周邊的佇列、寫回與重試路徑能夠承受正式環境規模的失敗之後,吞吐量才有所提升。
批次大小
批次大小就是重試的粒度。 較大的批次減少排程與回呼開銷,但讓每一次長尾失敗更難隔離、代價更高。
推行過程中直接看到了這點。一次 25g b64 c25 的執行完成了 44/45 個批次、接受了 2,767 個局面,之後有一個批次未通過深度檢查。後續的長尾調查把失敗範圍從 32 個局面縮小到 8 個,再縮到單一局面。
最終選定批次大小 32 是一種折衷。批次大小 1 最利於診斷,但對大規模調度而言太昂貴。批次大小 8-16 是不錯的重試形狀。批次大小 64+ 減少批次數,但讓長尾隔離變差。重試工具能把失敗的工作拆分到單一局面,這比擠出一點排程開銷更重要。
經驗法則: 選擇你能從容重試的最大批次大小。
工作節點數量
在控制平面能吸收回呼速率之後,增加工作節點數量才有幫助。
從 25 個容器跳到 50 個的提升很大:一次乾淨的 50 容器驗證達到每秒 34.78 個局面。100 容器搭配 300s 上限的執行,在 100 局的區塊上達到每秒 47.50 個局面,而第一個 500 局的區塊達到每秒 60.39 個局面。
目前實測的運作點受限於供應商工作區容量與單一寫回目標。當數百個工作節點幾乎同時完成時,工作節點直連網頁的回呼是很差的長期寫入路徑。緩衝分片把突發流量移到 Modal Volume,然後伺服器在受控的階段中排空結果。
這表示 max_containers 不是唯一的上限。超過某個點之後,下一個瓶頸會變成排程、分片處理、排空速率或資料庫具體化。
cpu=0.25 的設定之所以可行,是因為工作負載有大量獨立局面,而正確性透過達到深度的驗證來確保。在長尾局面或供應商限制成為瓶頸之前,較便宜且平行度足夠的工作節點,比少數較大的工作節點是更好的預設選擇。
成本
成本上的勝利來自工作節點形狀與寫回形狀,而不是降低分析標準。 直接寫回的執行落在每個提交局面約 $0.0000200。較新的排程執行器使用 cpu=0.25 的成本比例與緩衝寫回,約為舊估計的四分之一。
| 階段 | 範例 | 局面數 | 估計成本 | 每局面成本 |
|---|---|---|---|---|
| 大規模直接寫回推行 | 工作 30 |
45,429 |
$0.90858 |
$0.0000200 |
緩衝 cpu=0.25 路徑 |
工作 63 |
235 |
$0.001175 |
$0.0000050 |
實驗期間的 Modal 儀表板顯示總資源花費 $17.43:CPU $16.69、記憶體 $0.74。這包含失敗的試探、剖析、重試、深度實驗與正式環境推行工作。它回答的是「這次探索花了多少錢」,而不是最終運作點的邊際成本。
紀律在於提交工作節點之前強制執行成本上限,並把估計值寫進工作帳本。
請把三個數字分開看:提交前的估計成本、執行後實測的供應商帳單,以及扣除重試與快取重用後每個已接受局面的成本。它們回答不同的問題。
正確性限制
引擎契約需要的不只是 depth=18。
深度不是實際耗時預算。只指定深度的 Stockfish 呼叫可能一直執行到外層平台逾時把它砍掉為止。正式環境的工作節點同時需要要求深度與每局面時間上限。
工作節點也需要正確的引擎生命週期邊界。在沒有變動的 game= token 的情況下,跨彼此無關的 FEN 重複使用同一個 Stockfish 程序,會讓 python-chess 把整個分片視為同一局隱含的對局。它不會在無關局面之間送出 ucinewgame。曾有一個工作節點分片在 1800s 撞上平台逾時;在本機重播全部 64 個局面只花約 91.8s。加上變動的 game= token 與 ucinewgame 之後,那個有問題的局面在不到一秒內達到 [18,18,18]。
邊界的修正很小:
info = engine.analyse(
    board,
    chess.engine.Limit(depth=18, time=300),
    multipv=3,
    game=position_key,
)
重點不在於確切的包裝方式,而在於彼此無關的局面需要彼此無關的引擎對局識別。
病態局面
這次推行記錄了實際的局面,而不只是彙總的失敗。重要的案例分為兩類。
第一,有些局面對我們實際消費的契約而言太過嚴格。本節的棋盤皆以輪走方視角呈現。
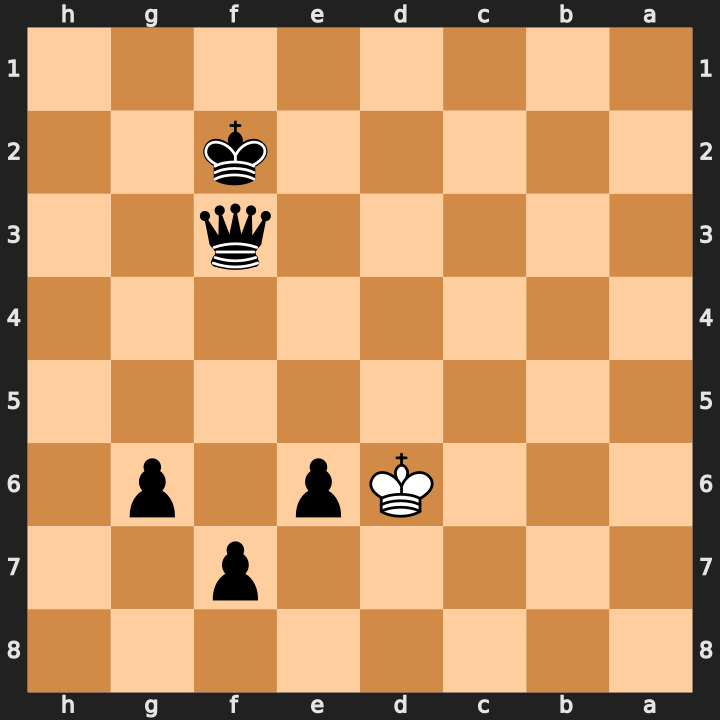
18;替代路線停在 17.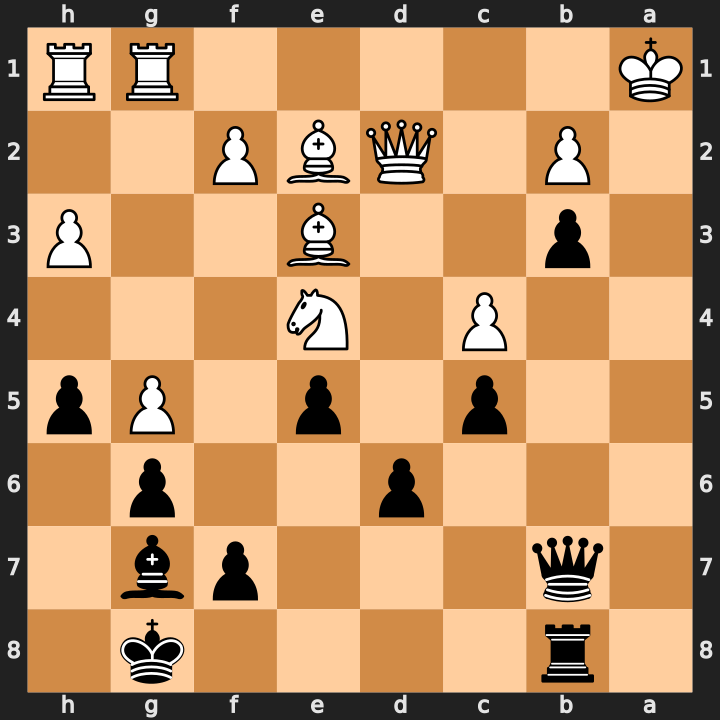
[15,15,14];以低深度備援方式接受。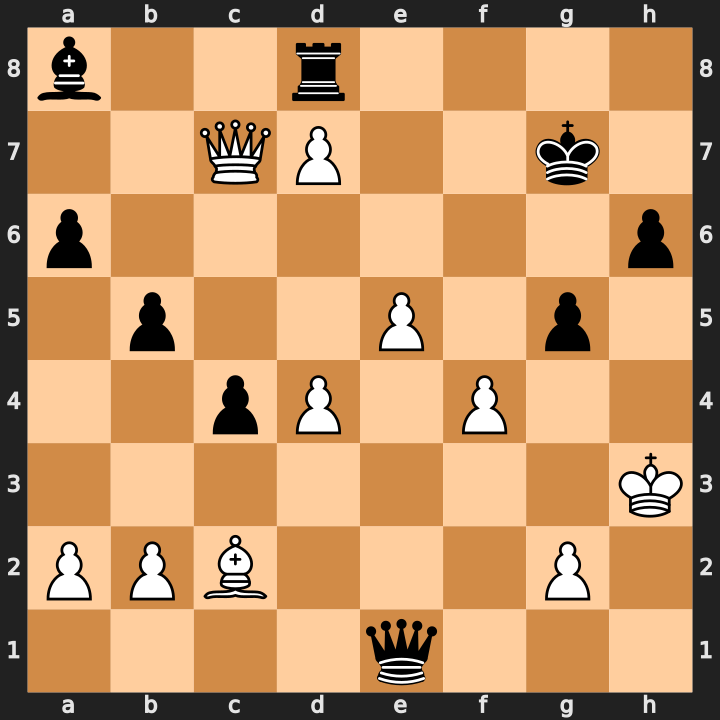
[17,17,17];儲存為 result_depth=17.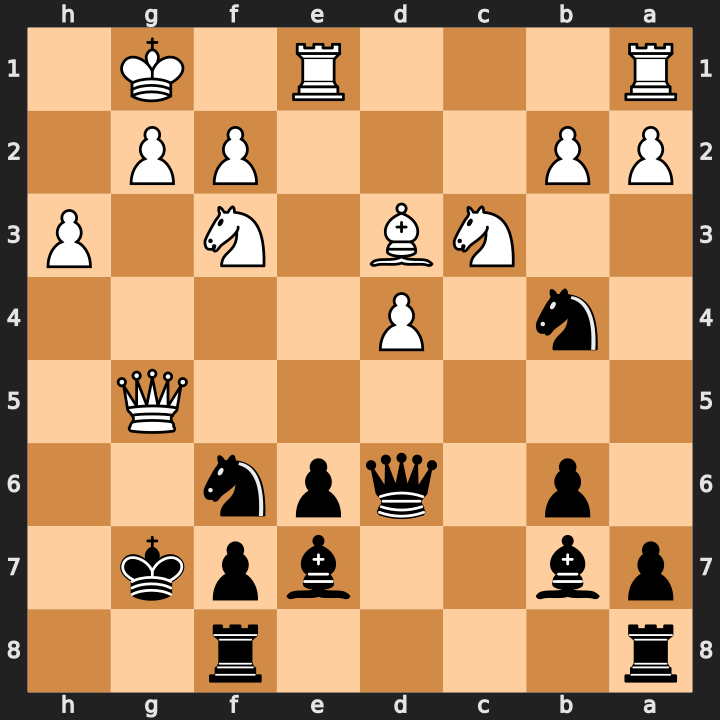
[17];儲存為 result_multipv=0/3.- MultiPV 長尾。
把失敗批次以
32 -> 8 -> 1重試,隔離出這個六子的后兵殘局。Stockfish 回傳的深度為[18, 18, 17]:最佳路線達到深度18,而第三條 PV 淺了一著。被接受的列記錄最佳著法f3d5、評估值-8115cp、requested_multipv=3與result_multipv=2。
FEN:8/5p2/3Kp1p1/8/8/5q2/5k2/8 b - -。 - Magnus 真正的病態長尾。
在
120s與180s的嚴格重試仍只回傳深度[15, 15, 14]。最終的非嚴格備援儲存了result_depth=15、最佳著法b7a7、評估值-933cp,以及明確的低深度來源資訊。
FEN:1r4k1/1q3pb1/3p2p1/2p1p1Pp/2P1N3/1p2B2P/1P1QBP2/K5RR b - -。 - 低深度備援 1。
嚴格執行在
60.013s後停止,深度為[17, 17, 17]。備援列記錄result_depth=17、result_multipv=2/3、最佳著法h3g4、評估值-847cp,以及90,863,715個節點。
FEN:b2r4/2QP2k1/p6p/1p2P1p1/2pP1P2/7K/PPB3P1/4q3 w - -。 - 低深度備援 2。
嚴格執行在
60.010s後停止,深度為[17]。備援列記錄result_depth=17、result_multipv=0/3、最佳著法g7h8、評估值+761cp,以及89,579,084個節點。
FEN:r4r2/pb2bpk1/1p1qpn2/6Q1/1n1P4/2NB1N1P/PP3PP1/R3R1K1 b - -。
第二,至少有一個局面並不糟糕,只是在第一版上限下太慢:
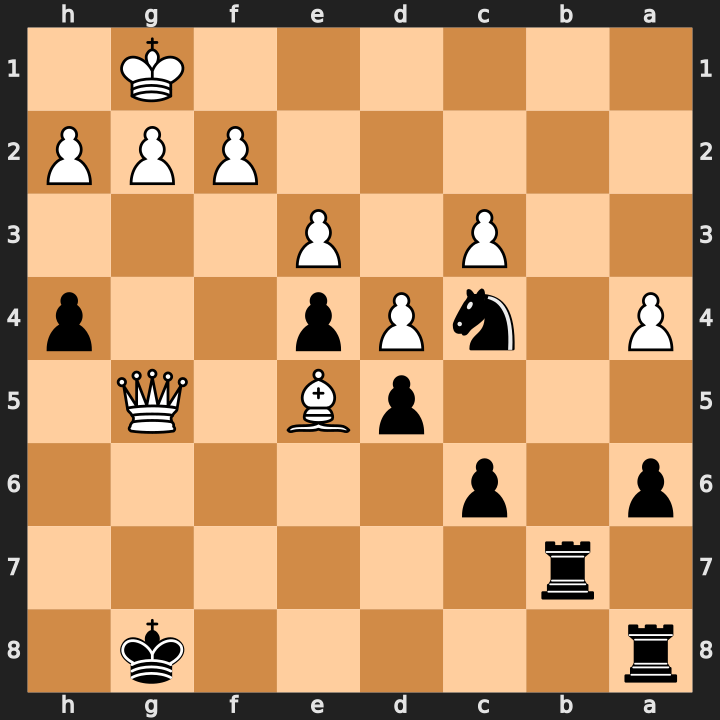
[18,18,18] 下達到 300s.- 真正的
120s長尾。 在120s下,一次單局面重試回傳最佳路線深度[17, 17, 18],而鄰近的31/32次重試都很快完成。在300s上限下,完全相同的局面在140.171s達到[18, 18, 18]。
FEN:r5k1/1r6/p1p5/3pB1Q1/P1nPp2p/2P1P3/5PPP/6K1 b - -。
這些例子說明了為何系統要儲存實際結果深度與實際 MultiPV 數量,而不是假裝每一筆被接受的列都滿足深度 18 與 MultiPV 3。
這次推行也記錄了幾種失敗形態:
| 案例 | 訊號 | 解法 |
|---|---|---|
| 引擎生命週期 | 一個分片撞上 1800s 平台逾時;本機重播 64 個局面只花 91.8s |
給彼此無關的 FEN 不同的 game= 識別,讓 ucinewgame 觸發 |
| MultiPV 深度檢查 | 32 -> 8 -> 1 的重試拆分隔離出一個替代 PV 路線較淺的合法局面 |
驗證實際使用的最佳路線並儲存 result_multipv |
| 真正的慢長尾 | 31/32 次單局面重試很快完成;一個錯過 120s,但在 300s 下於 140.171s 完成 |
對大規模契約保留較高的每局面上限 |
| 低深度備援 | 被隔離出的合法局面在備援上限下仍無法滿足所有深度/MultiPV 目標 | 僅在具備明確 result_depth 與 result_multipv 來源資訊時接受 |
| 深度成本長尾 | 在樣本上,深度 36/MultiPV 1 比深度 18/MultiPV 3 慢 41.44x |
不要把深度重算當成每次快取未命中的預設路徑 |
正確性規則
最終的正確性規則:
- 對每個彼此無關的局面送出新對局邊界;
- 使用每局面時間上限;
- 驗證實際使用的最佳路線達到要求深度;
- 儲存
requested_multipv與result_multipv; - 由批次列推導父層計數器;
- 把已完成的批次列視為最終結果。
主要的非顯而易見教訓: 當引擎在批次工作節點中執行時,引擎協定語意就變成了正式環境的正確性問題。
如果基準測試只量測最終吞吐量而忽略實際達到的深度,它可能看起來很成功,卻悄悄降低了分析品質。
深度與品質的取捨
更高的深度是成本乘數,不是免費的品質旋鈕。
一個僅供剖析、包含 10 個局面的樣本比較了幾種契約:
| 引擎契約 | 工作節點耗時 | 最慢的局面 | 相對於深度 18/MultiPV 3 |
|---|---|---|---|
深度 18、MultiPV 1 |
5.301s |
0.571s |
0.51x |
深度 18、MultiPV 3 |
10.329s |
2.442s |
1.00x |
深度 24、MultiPV 1 |
24.861s |
5.728s |
2.41x |
深度 24、MultiPV 3 |
56.252s |
13.428s |
5.45x |
深度 30、MultiPV 1 |
87.375s |
16.263s |
8.46x |
深度 36、MultiPV 1 |
428.071s |
106.782s |
41.44x |
這讓正式環境的選擇很清楚:快取未命中維持在 Stockfish 18、深度 18、MultiPV 3;當來源資訊符合產品需求時,使用更深的公開快取命中;不要把深度 30+ 或 36 當成每個個人對局長尾局面的預設重算目標。
深度 18 並非放諸四海皆「足夠」。它是在為成本曲線定價之後,為這個工作負載所選的預設運算契約。
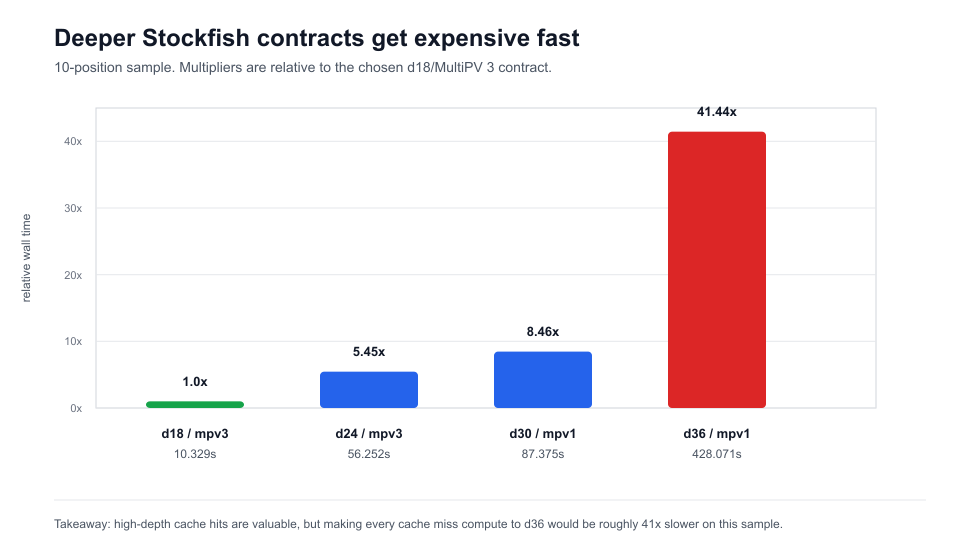 更深的分析也許有用,但它改變成本形狀的幅度是倍數,而不是百分比。
快取行為
本地局面鍵的重複利用很有價值。公開快取探詢還不足以內嵌在大規模準備流程中。
在大規模準備期間,本地快取的讀取穿透在雲端運算之前就具體化了數千筆著法評估。這應該保持啟用。它是確定性的、在本地執行,並且綁定同一套局面/評估契約。
在初期測試中,Lichess/Stockpile 類的公開快取探詢有兩個問題:前 50 個取樣局面命中 0 次,後續的健全性檢查則遇到速率限制行為。這表示公開 API 探詢不能阻塞大規模的正式環境準備流程。
目前政策:
- 使用本地/全域局面快取的讀取穿透;
- 在大規模執行時,把公開快取探詢限制在一定範圍或直接關閉;
- 在再次嘗試之前,加入漸進式、可持久化、具備退避機制的探詢;
- 儲存來源、引擎版本、深度、MultiPV、取得時間狀態與資料集中繼資料;
- 不要把私有的深度 18 列視為可與更深的公開列互換。
當快取的契約吻合時,它是有用的。 它無法取代一條處理快取未命中的受限路徑。
產品規則:快取命中是帶有來源資訊的運算結果。如果來源、引擎、深度、MultiPV 或延遲不符合產品契約,就把快取當成可有可無的加速手段。
本基準測試的限制
這些數字是有用的運作資料,不是通用的 Stockfish 基準。
工作負載是一個人的西洋棋檔案庫。引擎契約固定為 Stockfish 18、深度 18、MultiPV 3。實作以 Railway 加 SQLite 作為控制平面,並在本次推行期間可用的帳號限制下使用 Modal CPU 容器。不同的深度、MultiPV 數量、硬體、局面分佈、快取命中率與供應商限制都會改變結果。
可移轉的部分是量測方法:定義評估契約、記錄工作與批次狀態、保存來源資訊、在提交前設定花費上限,並且一次只改變一個瓶頸。
發現的瓶頸
隨著規模增加,瓶頸也在移動。
| 瓶頸 | 症狀 | 解法 |
|---|---|---|
| 單一網頁 CPU | 約每秒 4 個局面,預估完成時間長達數小時 |
把獨立的局面鍵分散出去 |
| 批次長尾 | 一個慢局面卡住整個分片 | 批次大小 32、重試拆分、每局面上限 |
| 引擎生命週期 | 本機重播很快,卻仍發生平台逾時 | 每個局面都設 ucinewgame 邊界 |
| MultiPV 深度檢查 | 有效的最佳路線被拒絕 | 驗證實際使用的路線,儲存結果 MultiPV |
| SQLite 鍵集合大小 | 500 局的準備撞上 SQL 變數數量上限 | 把查詢分塊並使用暫存表 |
| 重複回呼 | 父層工作被重複計數 | 由標準批次列推導計數器 |
| 遲來的錯誤回呼 | 已完成的批次被標記為錯誤 | 已完成的列即為最終結果 |
| 公開快取延遲 | 準備流程卡住或被限速 | 讓公開探詢受限且漸進 |
| 部署回饋迴圈 | 映像檔推送花了 163s |
把笨重的 ML 套件堆疊移出網頁映像檔 |
| 工作區上限 | 100 容器的執行成為實務上的天花板 | 接受上限,或尋求更高的運算容量 |
映像檔大小的修正不屬於 Stockfish 運算,但它對迭代速度很重要。網頁映像檔從 2.85 GB 降到 189.5 MB,映像檔推送從 163s 降到 8.1s。
反覆出現的模式: 一個瓶頸移動之後,下一個通常在 Stockfish 之外。
實測運作點
目前正式環境設定的預期行為:
| 指標 | 預期範圍 |
|---|---|
| 大規模執行吞吐量 | 每秒 47-60 個局面 |
| 完成後的佇列清理 | 沒有殘留的待處理、執行中或錯誤列 |
| 較大區塊上的寫回 p95 | 在記錄的執行中低於一秒 |
| 每個完成局面的成本 | 在 cpu=0.25 的模型下約 $0.000005 |
這是一個穩定的運作點,不是永久最佳解。當長尾局面主導實際耗時、排空耗時變得顯著、供應商帳單偏離模型、佇列列變得陳舊、快取命中率變高且可靠,或批次供應商提高帳號上限時,就該調整它。
下一個 10 倍的躍升大概不會來自在同一個上限內調整 max_containers。 它會來自以下三種改變之一:
- 批次供應商提高工作區/容器上限。
- 工作負載分散到彼此獨立的運算容量上。
- 更多局面能由來源資訊相容的快取滿足。
在那之前,100 容器的緩衝路徑就是正式環境的預設值。
哪些應該可移轉
經得起時間考驗的部分不是確切的供應商、價格或批次大小。
| 原則 | 實測案例 |
|---|---|
| 先定義評估契約 | Stockfish 18、深度 18、MultiPV 3 |
| 把不可變的工作單位排入佇列 | position_key,而非對局 id |
| 把批次大小視為重試粒度 | 批次大小 32 成為預設值 |
| 區分要求品質與實際達成品質 | 要求深度 vs 達到深度、要求 MultiPV vs 結果 MultiPV |
| 讓寫回具備冪等性 | 父層計數器由批次列推導 |
| 讓快取來源資訊可見 | 來源、引擎、深度、MultiPV、取得時間中繼資料 |
| 在提交前設定花費上限 | 每個工作都記錄成本上限 |
如果另一個系統更換引擎版本、目標深度、硬體、供應商或局面分佈,實測數值就應該改變。原則則不應改變。
重新執行此基準測試
當下列任一項改變時就重新執行:
- 引擎版本或 UCI 選項;
- 要求深度或 MultiPV 數量;
- 每局面時間上限;
- CPU 形狀、工作節點數量或供應商限制;
- 批次大小;
- 寫回路徑;
- 快取來源與命中率;
- 局面分佈。
對快棋檔案庫最快的設定,未必是對開局資料庫、殘局研究集或引擎對引擎語料庫最快的設定。最起碼有用的基準測試迴圈:
- 從真實工作負載取樣局面,而不是只用起始局面或測試 FEN。
- 剖析目標引擎契約,以及至少一個更深的契約。
- 執行一段小型批次階梯:
1、8、16、32、64。 - 在重試與寫回都可靠之後,再執行工作節點數量的階梯。
- 分別量測工作節點實際耗時、提交跨度、寫回時間與殘留的佇列列。
- 追蹤提交前的估計成本與事後實際的供應商花費。
- 驗證達到的深度與持久化的來源資訊,而不只是吞吐量。
- 在更換供應商、深度或工作節點形狀後,對同一份樣本重跑一次。
教訓
- 在擴展運算之前先定義引擎契約。
- 把局面鍵排入佇列,而不是對局。
- 把批次大小視為重試粒度。
- 加上實際耗時上限。深度不是預算。
- 把引擎生命週期邊界視為正確性需求。
- 把冪等性納入效能工作的一部分。
- 讓快取來源資訊可見。
- 在正式環境調校期間最佳化部署回饋迴圈。
不要退步:
- 對彼此無關的局面送出不同的引擎對局識別。
- 分別儲存要求深度與達到深度。
- 分別儲存要求 MultiPV 與達到 MultiPV。
- 以
position_key排入佇列並去重。 - 讓批次寫回具備冪等性。
- 讓失敗的批次能以更小的粒度重試。
- 把低深度備援視為明確的來源資訊,而不是已滿足深度
18。 - 正式環境執行結束時要達到
pending=0、running=0、error=0。