中国語ピンインの内側:79,000以上の文が明かすもの
要点
- Tatoebaの中国語文79,704件のピンインを整理した。異なる音節は1,161で、声調を除くと401にまとまる。
- どの指標でも第4声が首位で、27〜34%を占める。軽声は音節の2.2%にすぎないが使用頻度では8.4%になる。よく使われる助詞(的、了、吗)がすべて軽声だからだ。
- 多音字は教科書が示すほど多くない。コーパスに現れる5,002字のうち199字、3.8%だけが実際に複数の読みを持ち、通常は一つの読みが支配的である。
- 上位10音節が読まれた全文字の18.8%を占め、yi4だけで37字ある。
実際にどのピンイン音節が現れるのかを知るため、Tatoebaの中国語文79,704件を分析した。このコーパスには1,161の異なる音節が含まれる(ここに含まれないより稀な音節もおそらく存在する)。Trie(トライ木)というデータ構造であらゆる音節を対応づけたところ、声調の分布、文字の複雑さ、多音字の発音について、教科書の記述とは異なる傾向が見えてきた。
データが示す内容は次のとおりだ。
Trie構造
Trie(接頭辞木)は、根から葉までの各経路が一つの完全な文字列を表すデータ構造である。ピンインの場合、各ノードは1文字のアルファベットで、h → a → n → 4 という経路をたどると音節「han4」が得られる。
ピンイン音節は各文字をノードとする木を形成する。以下は、根から終端ノードまで音節がどう構成されるかを示す完全なhの枝である。
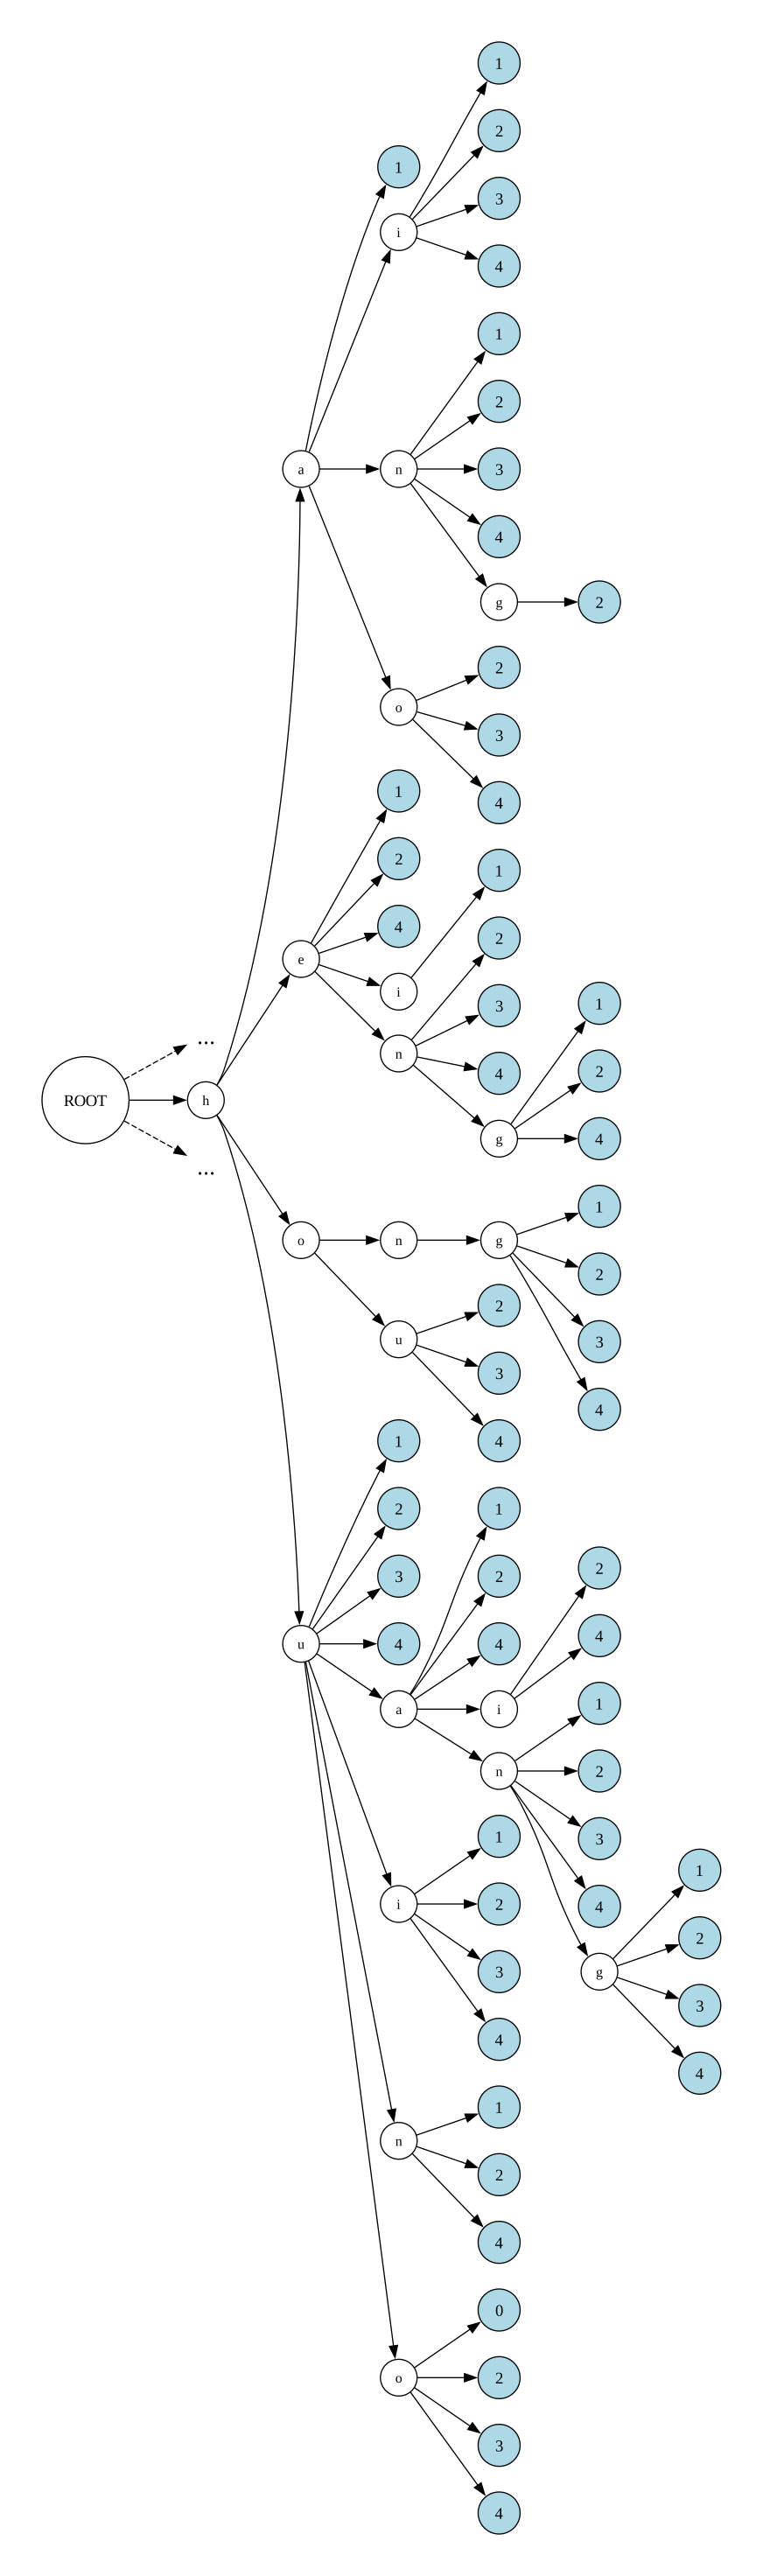
根からすべての完全な音節(ha、hao、heなど)までのhの枝。破線は他の枝を示す。
さらに見る:
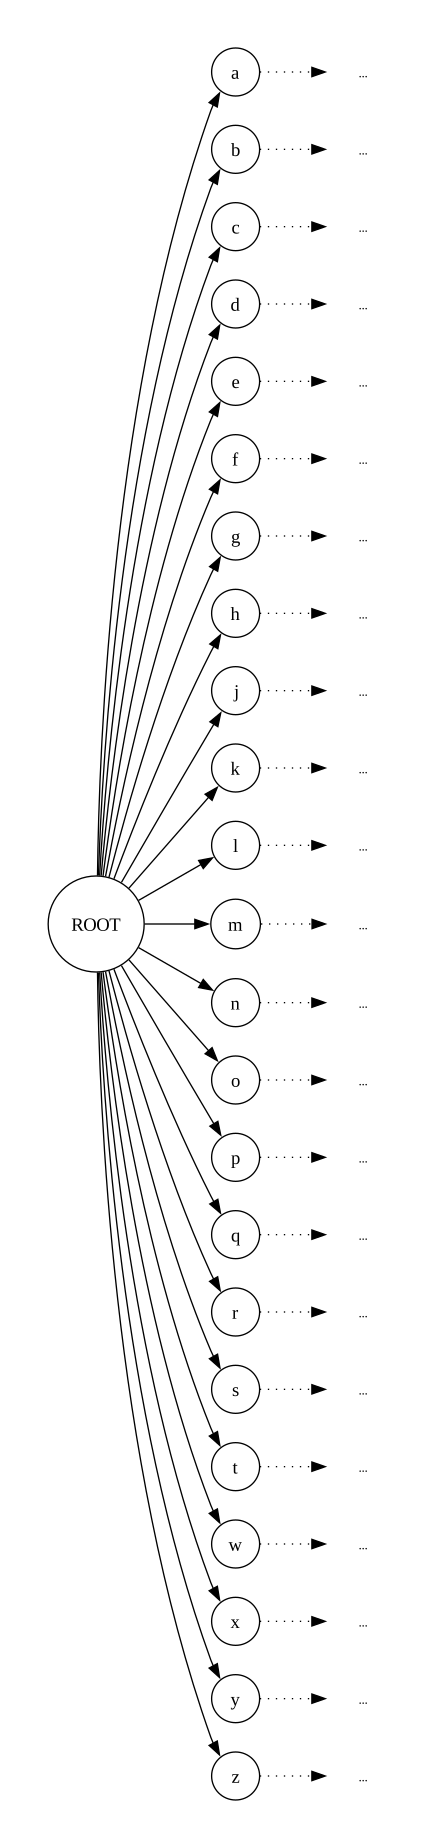
レベル1 →
レベル2 →
レベル3 →
Trie全体 → (ノードにカーソルを合わせると詳細が表示される)



声調のパラドックス
軽声は異なる音節のうち2.2%にすぎないが、実際の文字使用では8.4%を占める。なぜか。極めて頻度の高い文法助詞(的、了、吗、么)がすべて軽声だからだ。
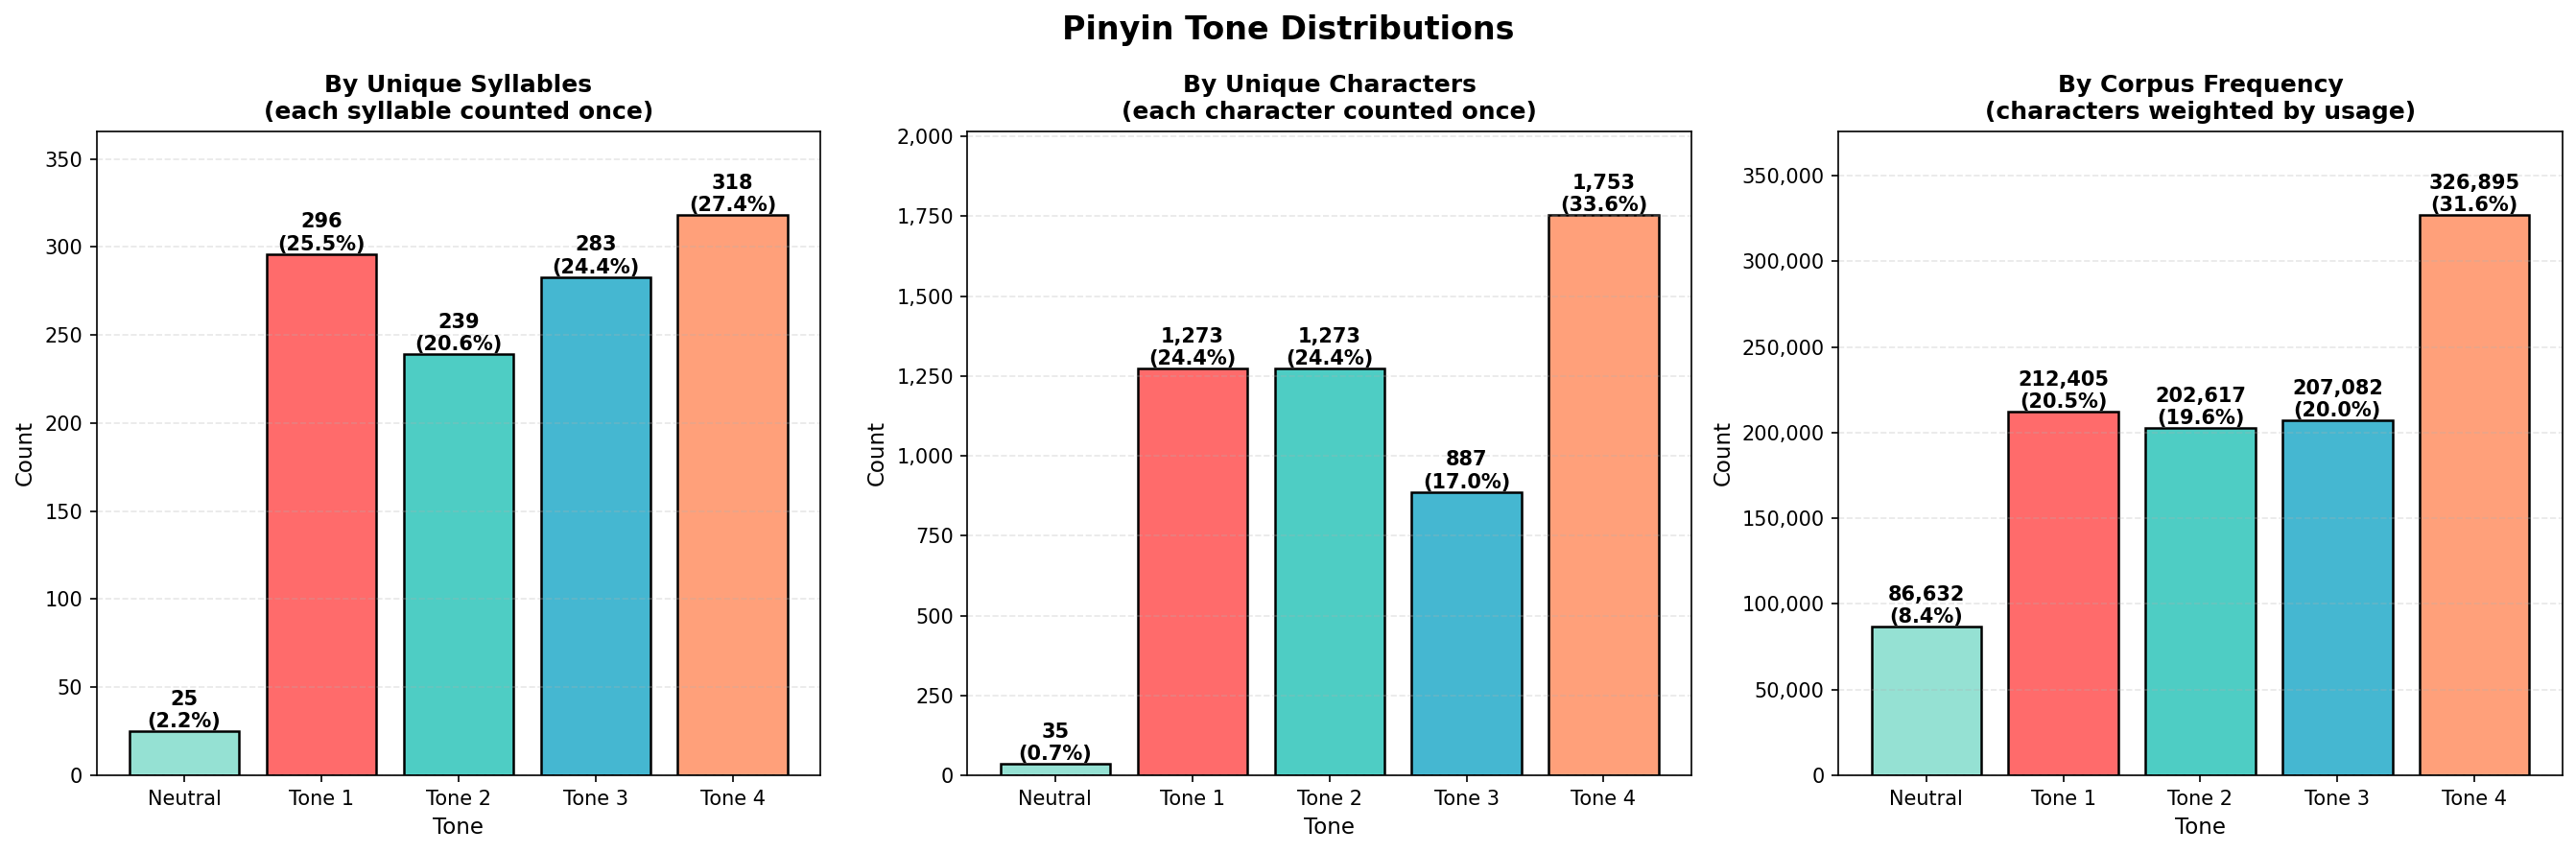 声調を見る三つの視点:音節別、文字別、頻度別
重要な点:第4声がすべての指標で支配的(27〜34%)である一方、軽声は助詞の頻度によって本来の比率を大きく上回る影響力を持つ。
音節の混雑
ほとんどのピンイン音節は数個の文字に対応する。しかし一部は極端に混雑している。
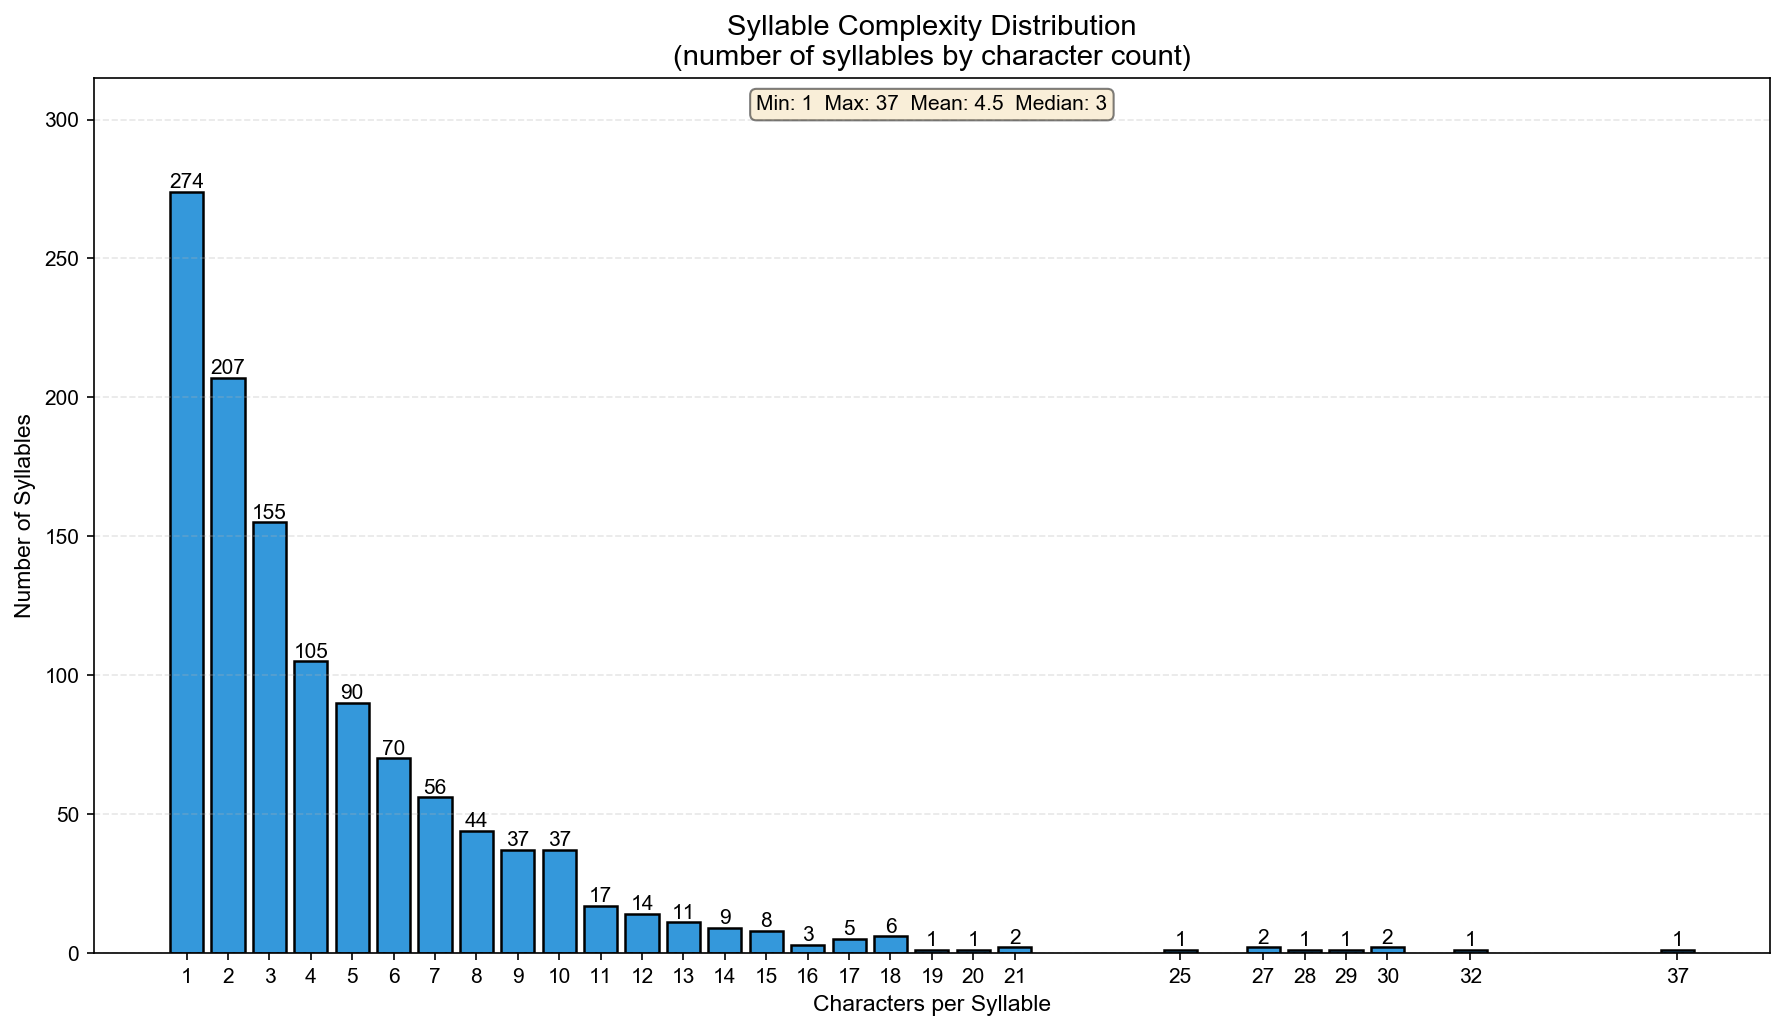 音節あたりの文字数。多くは3〜4字だが、
30+のものもある
最も混雑した音節:
- yi4:37字(意、义、议、异、易、亿、艺、益…)
- shi4:32字(是、事、市、式、试、视、世、士…)
- ji4:30字(记、际、计、技、季、继、既、寄…)
一方、単一の文字にしか対応しない音節もある。wo3(我)、le0(了)、ni3(你)である。
多音字という神話
教科書は多くの漢字に複数の発音があることを強調する。しかしこのコーパスに現れる5,002字のうち、実際に多音なのは3.8%(199字)にすぎない。Unicodeは80,000字以上の漢字を定義しているが、この分析は学習者が実際の使用で出会うものに焦点を当てている。
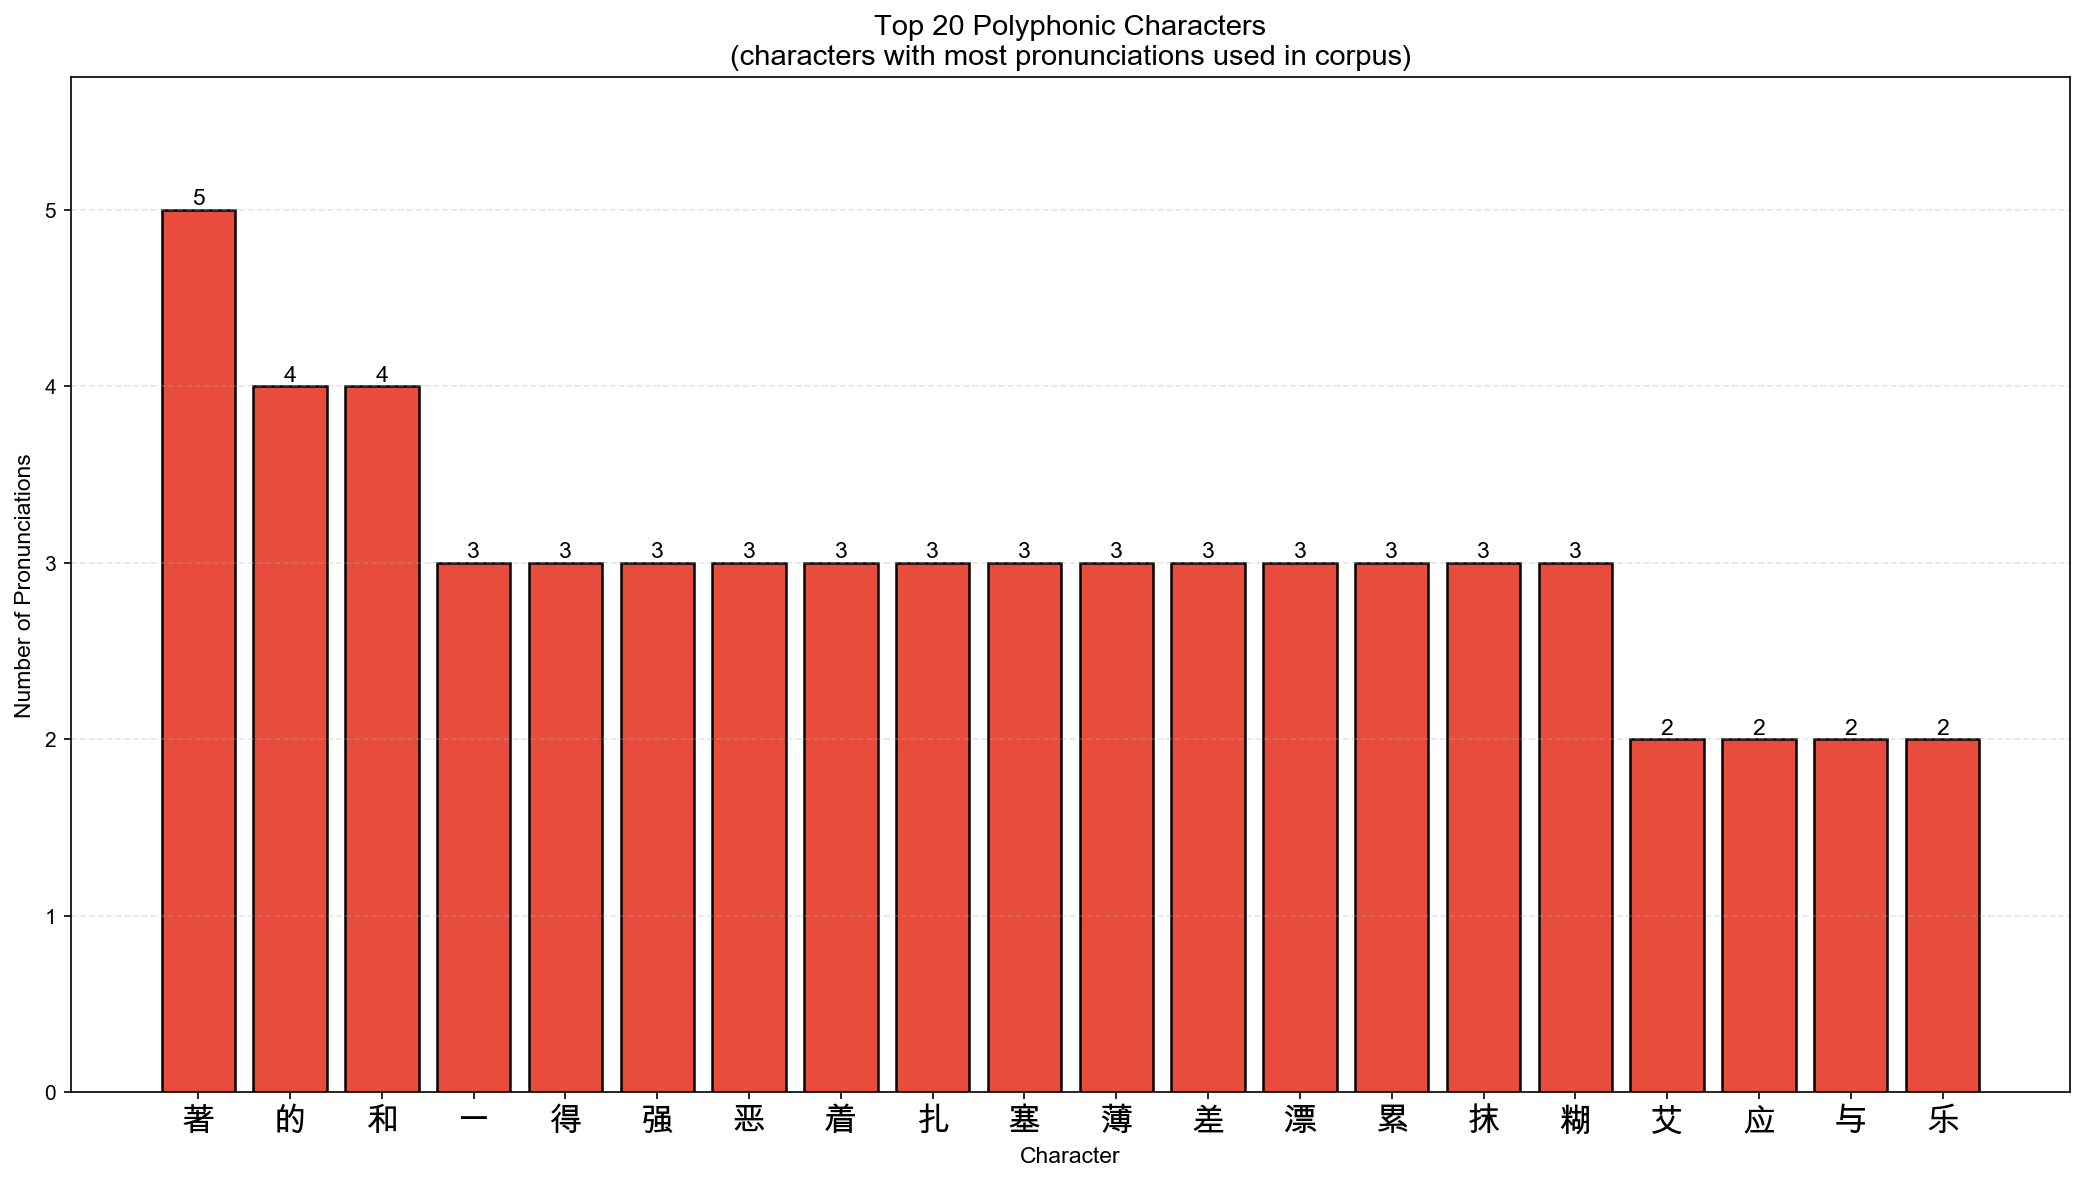 複数の発音を持つ文字の上位20
複数の発音を持つ場合でも、通常は一つが支配的である。
- 的:発音は4種類だが、99.8%は
de0として使われる - 一:発音は3種類だが、
yi1が主要な形である - 著:発音は5種類(コーパス中で最も多音な文字)
音節の構造
中国語の音節の多くは深さ4で完成する(ban1やmao2のように3文字+声調)。
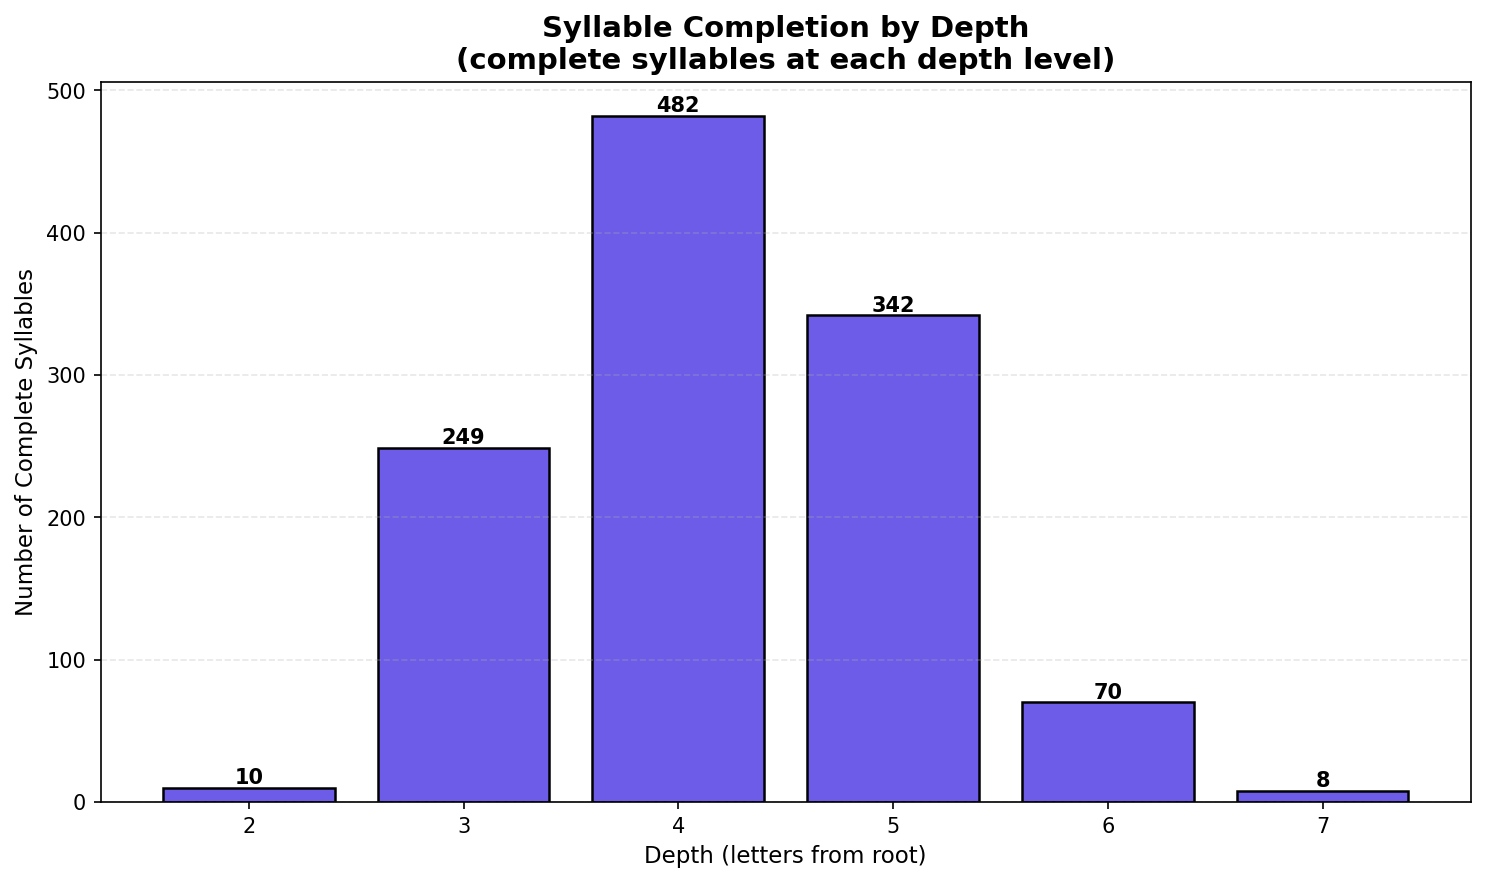 深さ別の音節完成。音節の41.5%が深さ4で完成する(1,161のうち482)
最も長い音節(深さ7:6文字+声調)はすべて-uangの組み合わせである。
- chuang1, chuang2, chuang3, chuang4
- shuang1, shuang3
- zhuang1, zhuang4
音節×声調のカバレッジ
声調を取り除くと、1,161の音節は401の基本形にまとまる。次のヒートマップは、どの基本音節が5つの声調すべてにわたって存在するかを示す。
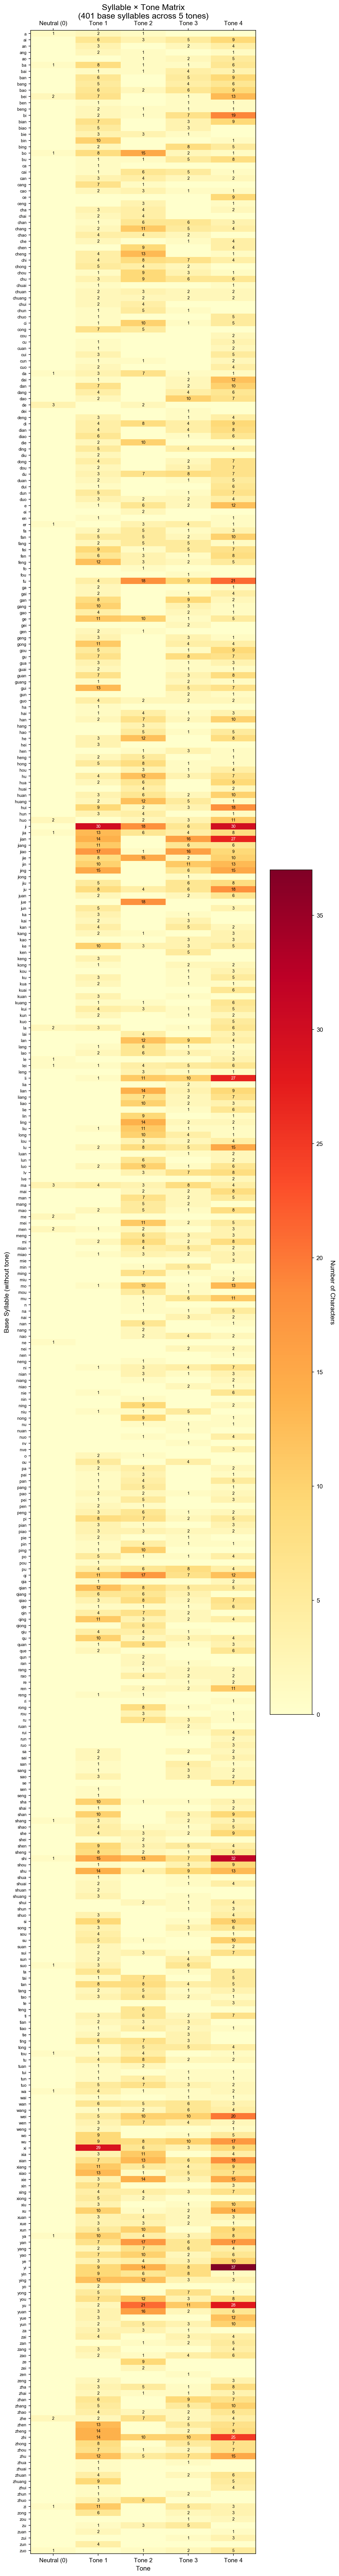 401の基本音節×5声調。セルの値は文字数を示す。すべての声調に存在する基本音節もあれば、1つか2つにしか存在しないものもある。
観察:
- ほとんどの基本音節は5つの声調すべての変種を持たない
- 軽声(列0)は疎で、これを持つ基本音節は25だけである
- 一部の基本音節は特定の声調に限られる(1〜2の声調列にしか現れない)
主な知見
- 79,704文にわたる1,161の異なる音節。声調を除くと401の基本音節(基本音節あたり平均2.9声調)
- 文字の91.8%は実際には発音が一つだけであり、教科書の多音字の扱いは実際の使用に対して過大である
- 軽声:音節の2.2%だが使用の8.4%。その差は文法助詞(的、了、吗、么)にある
- 第4声が支配的で、音節、文字、使用のいずれでも27〜34%を占める
- 上位10音節が全文字出現数の18.8%を占める。同音文字数は1音節あたり平均4.5で、yi4は37
実践的な意味はこうだ。上位1割の音節とその支配的な発音を習得した学習者は、読解の負荷の大部分をカバーできる。多音字の問題は少数の文字に集中しており、コーパス全体に広がってはいない。
技術的な補足
この分析はTatoebaコーパスの中国語文79,704件に基づく。各ノードが1文字のアルファベットまたは声調番号を表す文字単位のTrieデータ構造を構築し、終端ノードに文字のメタデータと頻度データを格納した。
ツール: Python 3.9+、matplotlib(グラフ)、graphviz(木の可視化)
データパイプライン:
- コーパスから文字を抽出する
- jieba + pypinyin および/または GPT-4o-mini でピンインを算出する
- Trie構造を構築する
- 分布、パターン、例外的なケースを分析する
資料
- GitHubのhanzi-flow - 分析コードと可視化の全体
- Tatoeba - 文コーパス