深入中文拼音:79,000 多個句子揭示了什麼
簡而言之
- 我整理了 Tatoeba 上 79,704 個中文句子的拼音:共 1,161 個不同音節,去掉聲調後收斂為 401 個。
- 第四聲在各項指標上都居首,佔 27 到 34%。輕聲只佔音節的 2.2%,但在實際使用中佔 8.4%,因為常見虛詞(的、了、吗)都是輕聲。
- 多音字比教科書所暗示的更少見:語料庫中 5,002 個字裡只有 199 個(3.8%)有多於一種實際使用的讀音,而且通常有一種讀音佔絕對優勢。
- 前 10 個音節涵蓋了所有讀出字次的 18.8%,而 yi4 一個音節就對應 37 個字。
我分析了 Tatoeba 上 79,704 個中文句子,想了解哪些拼音音節在實務中真正出現。這個語料庫包含 1,161 個不同音節(可能還有一些冷僻音節未涵蓋在此)。我用 Trie 資料結構把每個音節都對應起來,發現聲調分佈、字的複雜度與多音讀法上的一些規律,和教科書所說的並不相同。
以下是資料揭示的內容。
Trie 結構
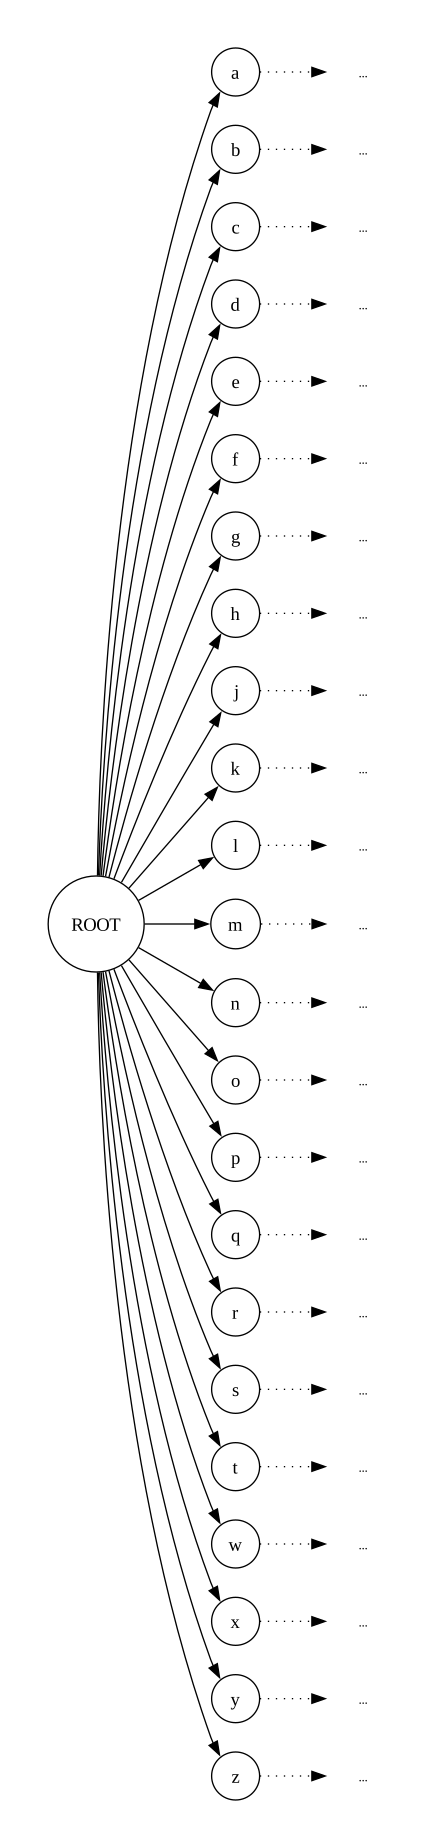
Trie(前綴樹)是一種資料結構,從根節點到葉節點的每條路徑都代表一個完整字串。對拼音來說,每個節點是一個字母,沿著 h → a → n → 4 這樣的路徑走,就得到音節「han4」。
拼音音節構成一棵樹,每個字母都是一個節點。以下是完整的 h 分支,顯示音節如何從根節點形成到終端節點:
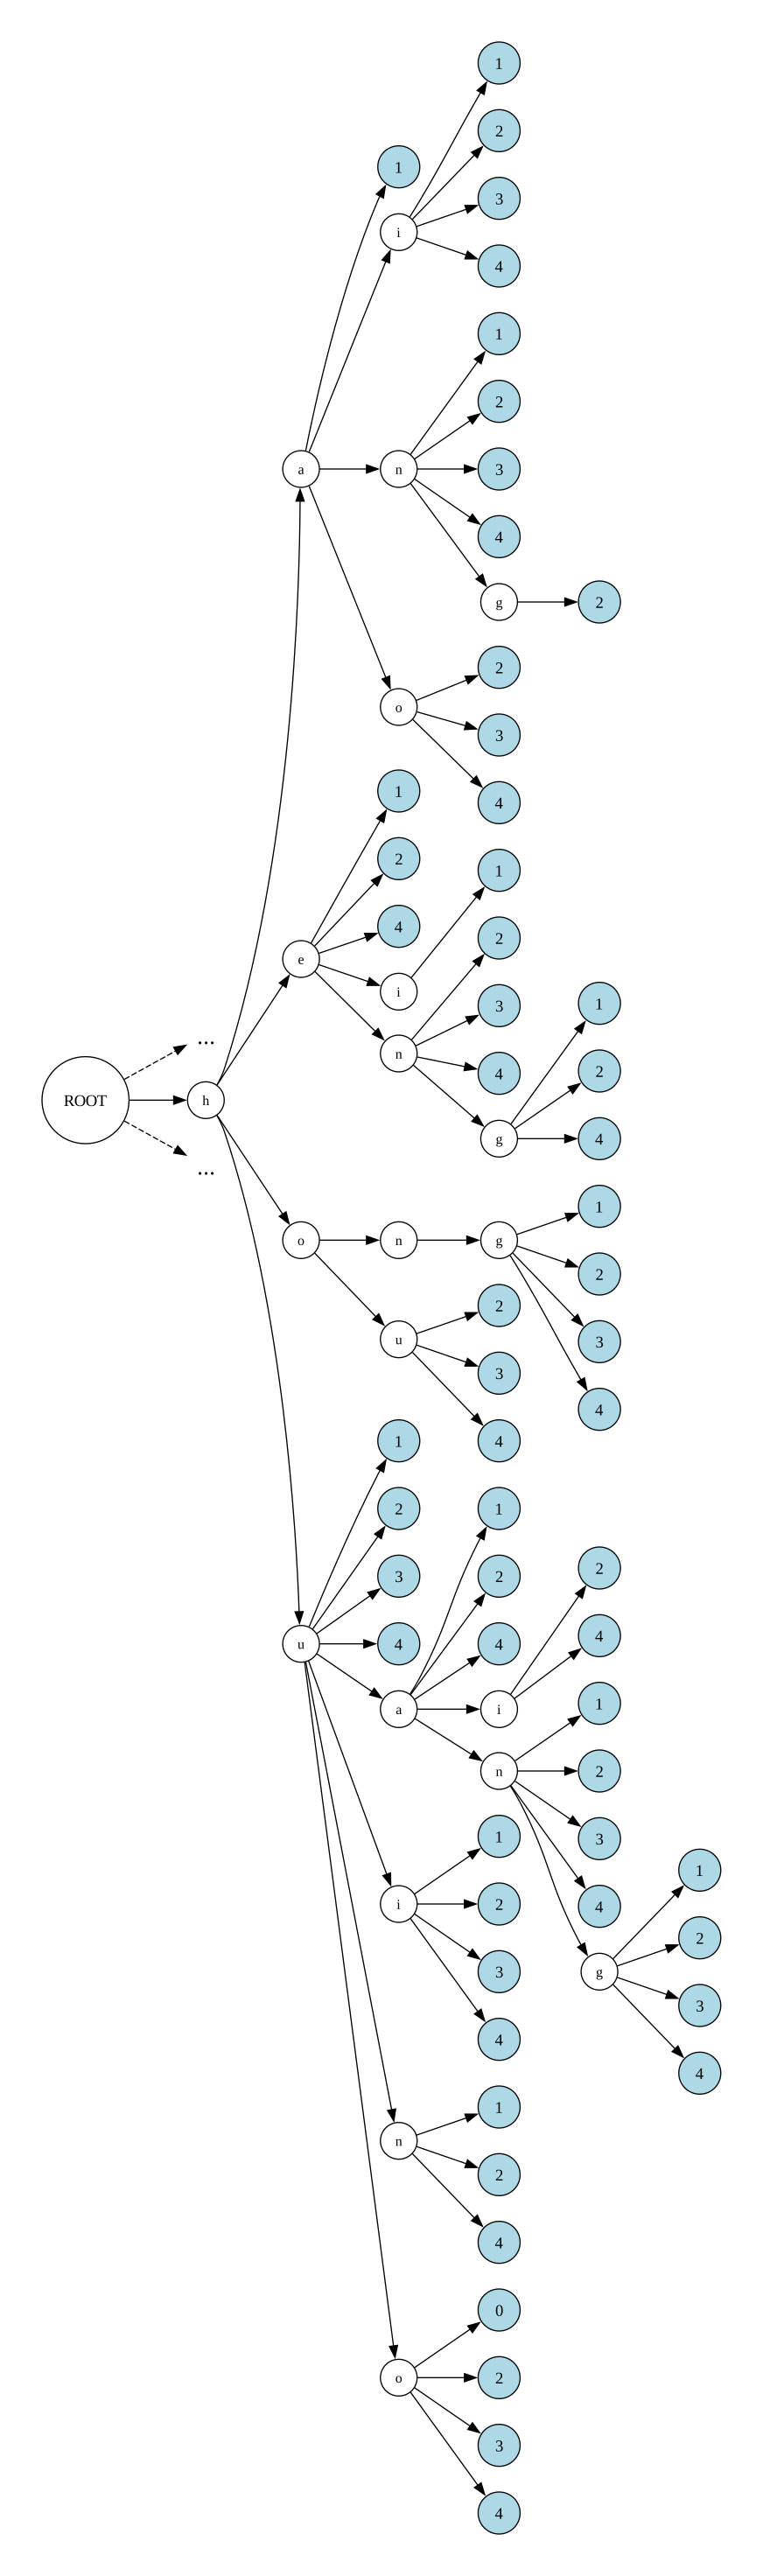
從根節點到所有完整音節(ha、hao、he 等)的 h 分支。虛線表示其他分支。
further 探索:
第 1 層 →
第 2 層 →
第 3 層 →
完整 Trie → (將滑鼠移到節點上可看細節)



聲調的悖論
輕聲只佔不同音節的 2.2%,但在實際用字中佔 8.4%。為什麼?因為極常見的語法虛詞(的、了、吗、么)全都是輕聲:
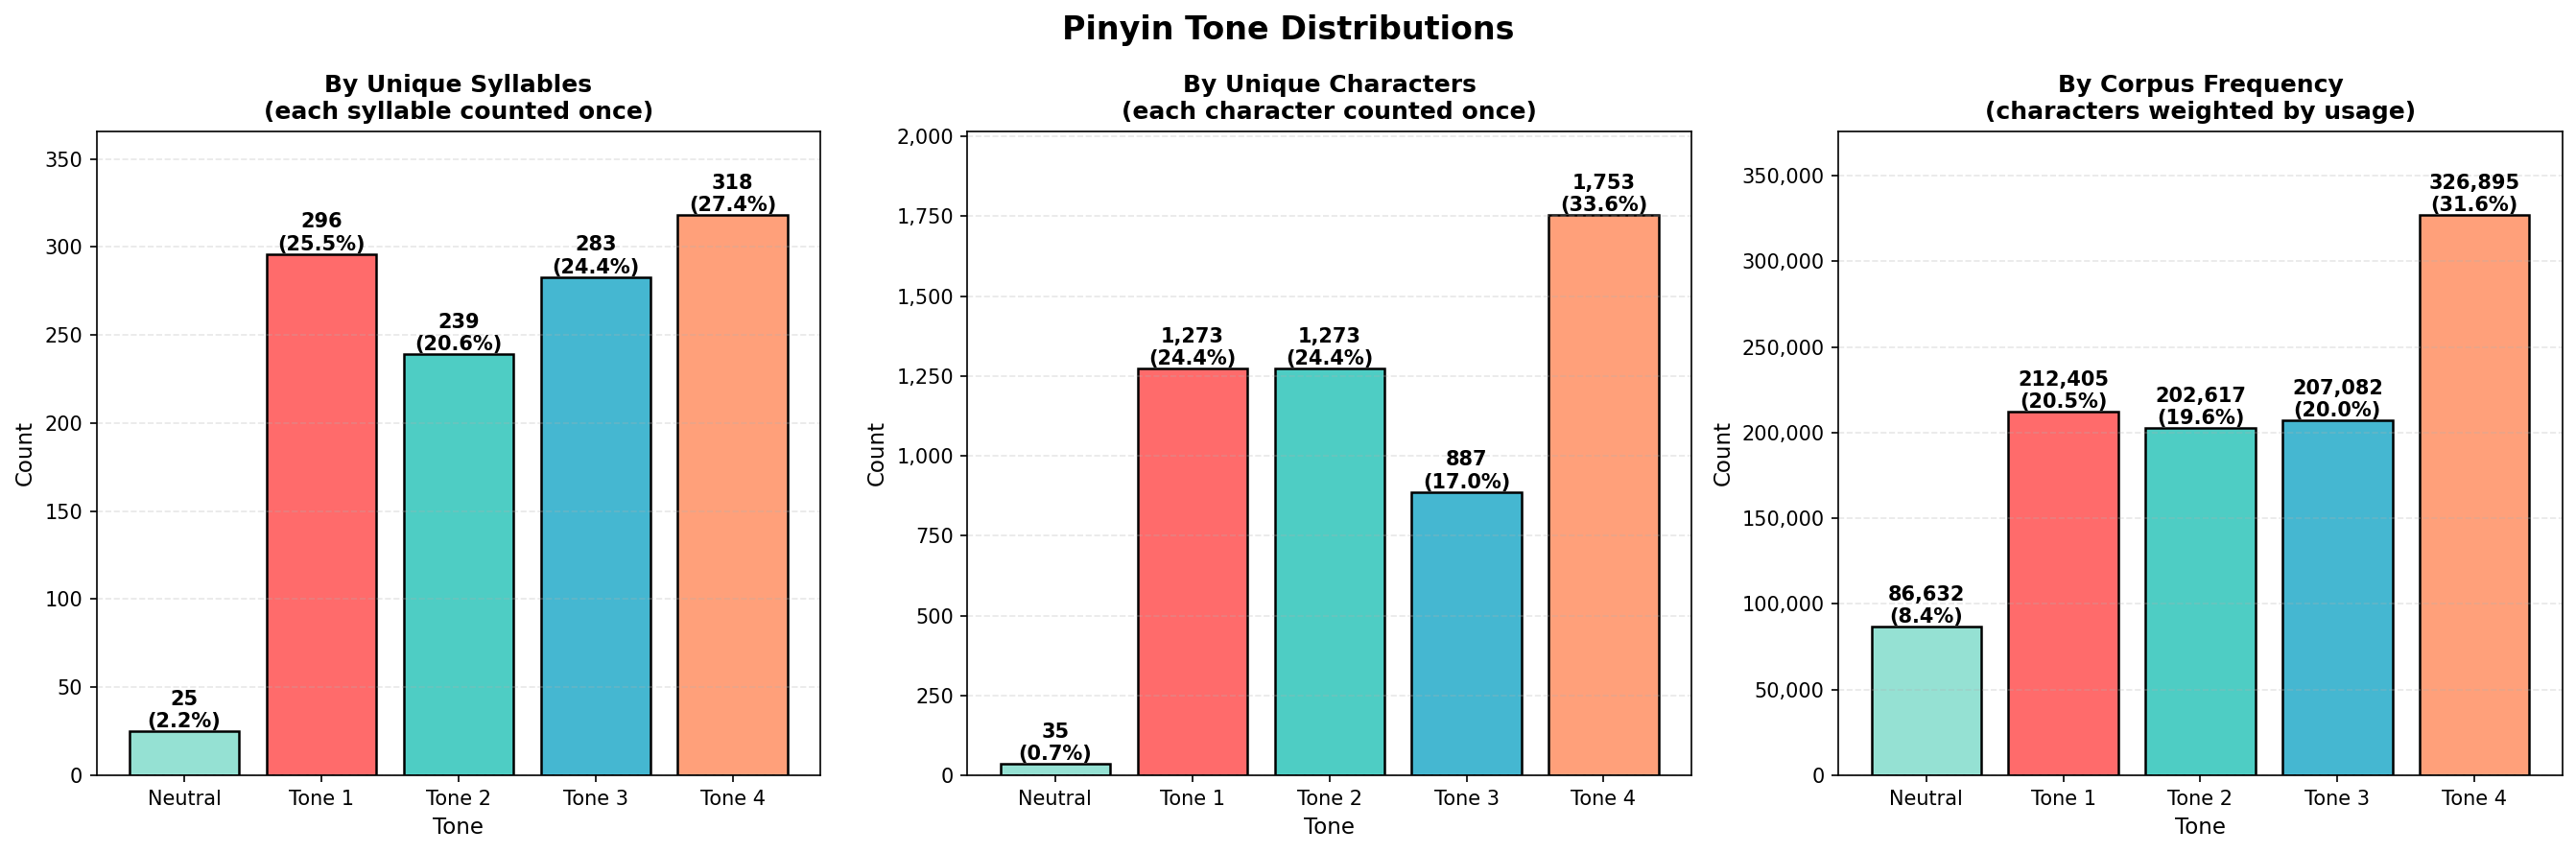 三種看聲調的角度:依音節、依字、依頻率
關鍵發現:第四聲在各項指標上都佔主導(27 到 34%),而輕聲則因虛詞頻率高,影響力遠超其佔比。
音節的擁擠程度
大多數拼音音節只對應少數幾個字。但有少數音節極為擁擠:
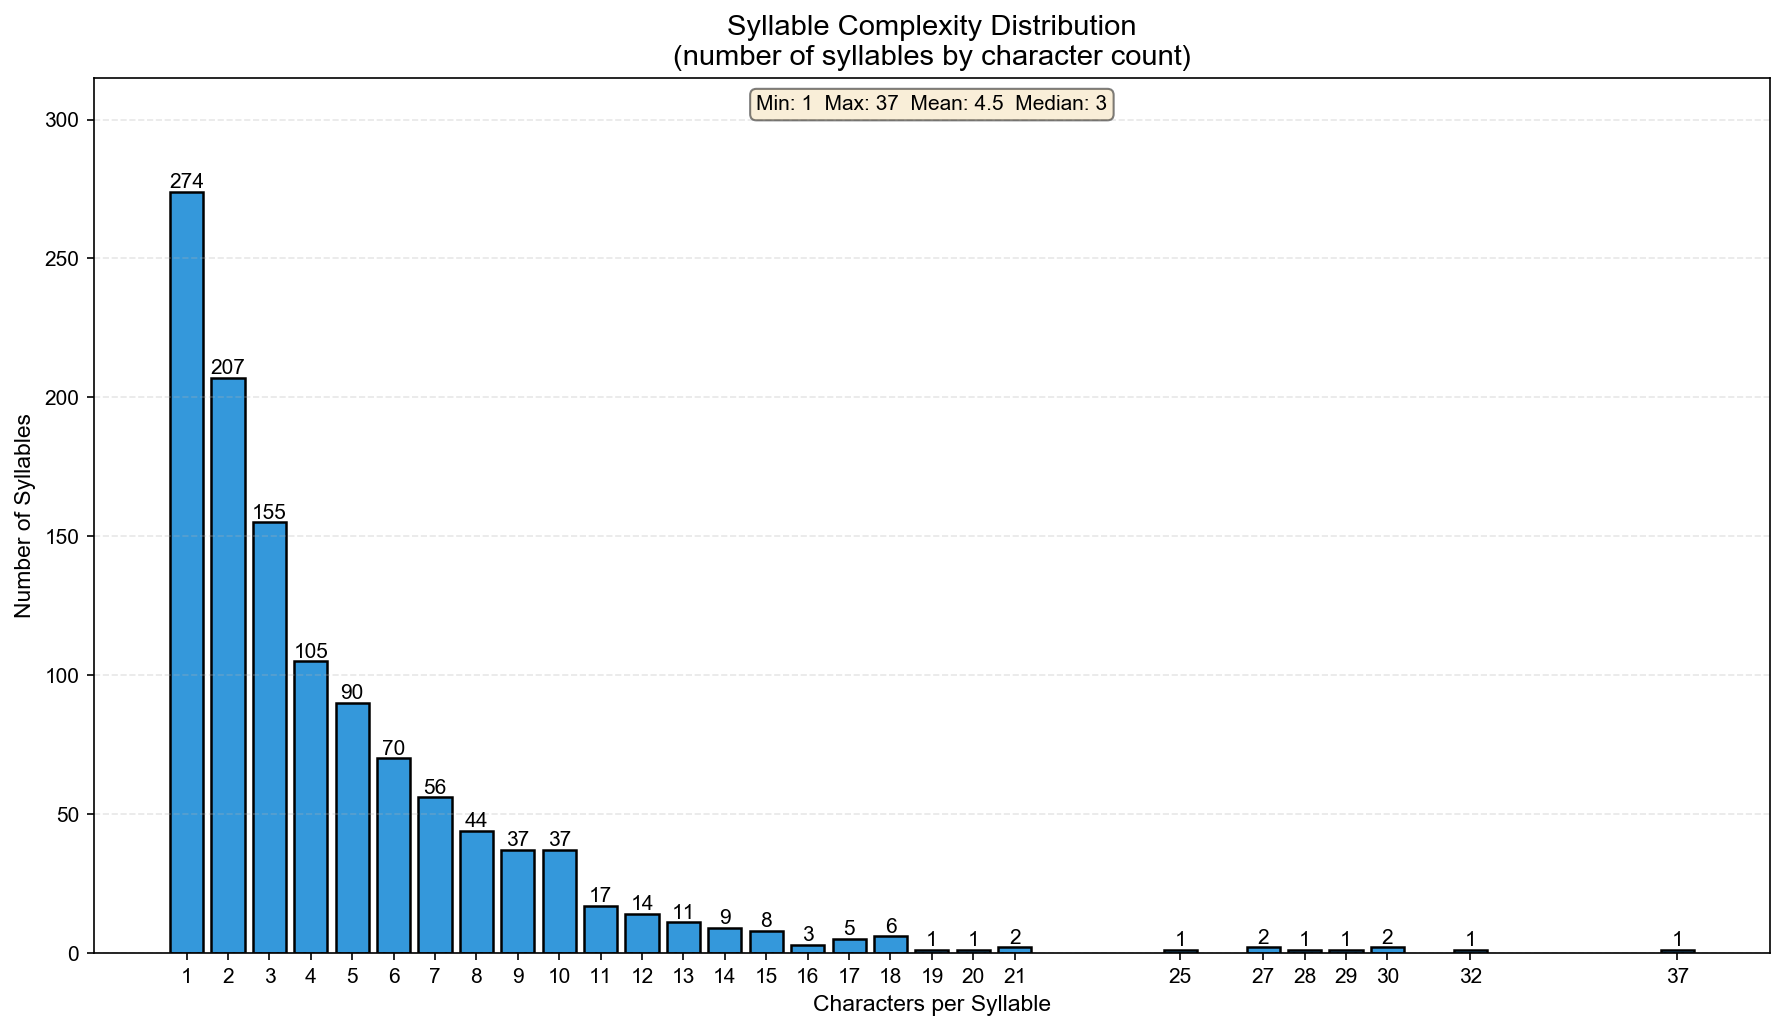 每個音節對應的字數:多數為 3 至 4 個,但有些達
30+
最擁擠的音節:
- yi4:37 個字(意、义、议、异、易、亿、艺、益……)
- shi4:32 個字(是、事、市、式、试、视、世、士……)
- ji4:30 個字(记、际、计、技、季、继、既、寄……)
另一方面,有些音節只對應單一個字:wo3(我)、le0(了)、ni3(你)。
多音字的迷思
教科書強調許多漢字有多種讀音。但在本語料庫出現的 5,002 個字中,實際上只有 3.8%(199 個字)是多音字。雖然 Unicode 定義了 80,000 多個漢字,本分析聚焦於學習者在真實使用中會遇到的部分:
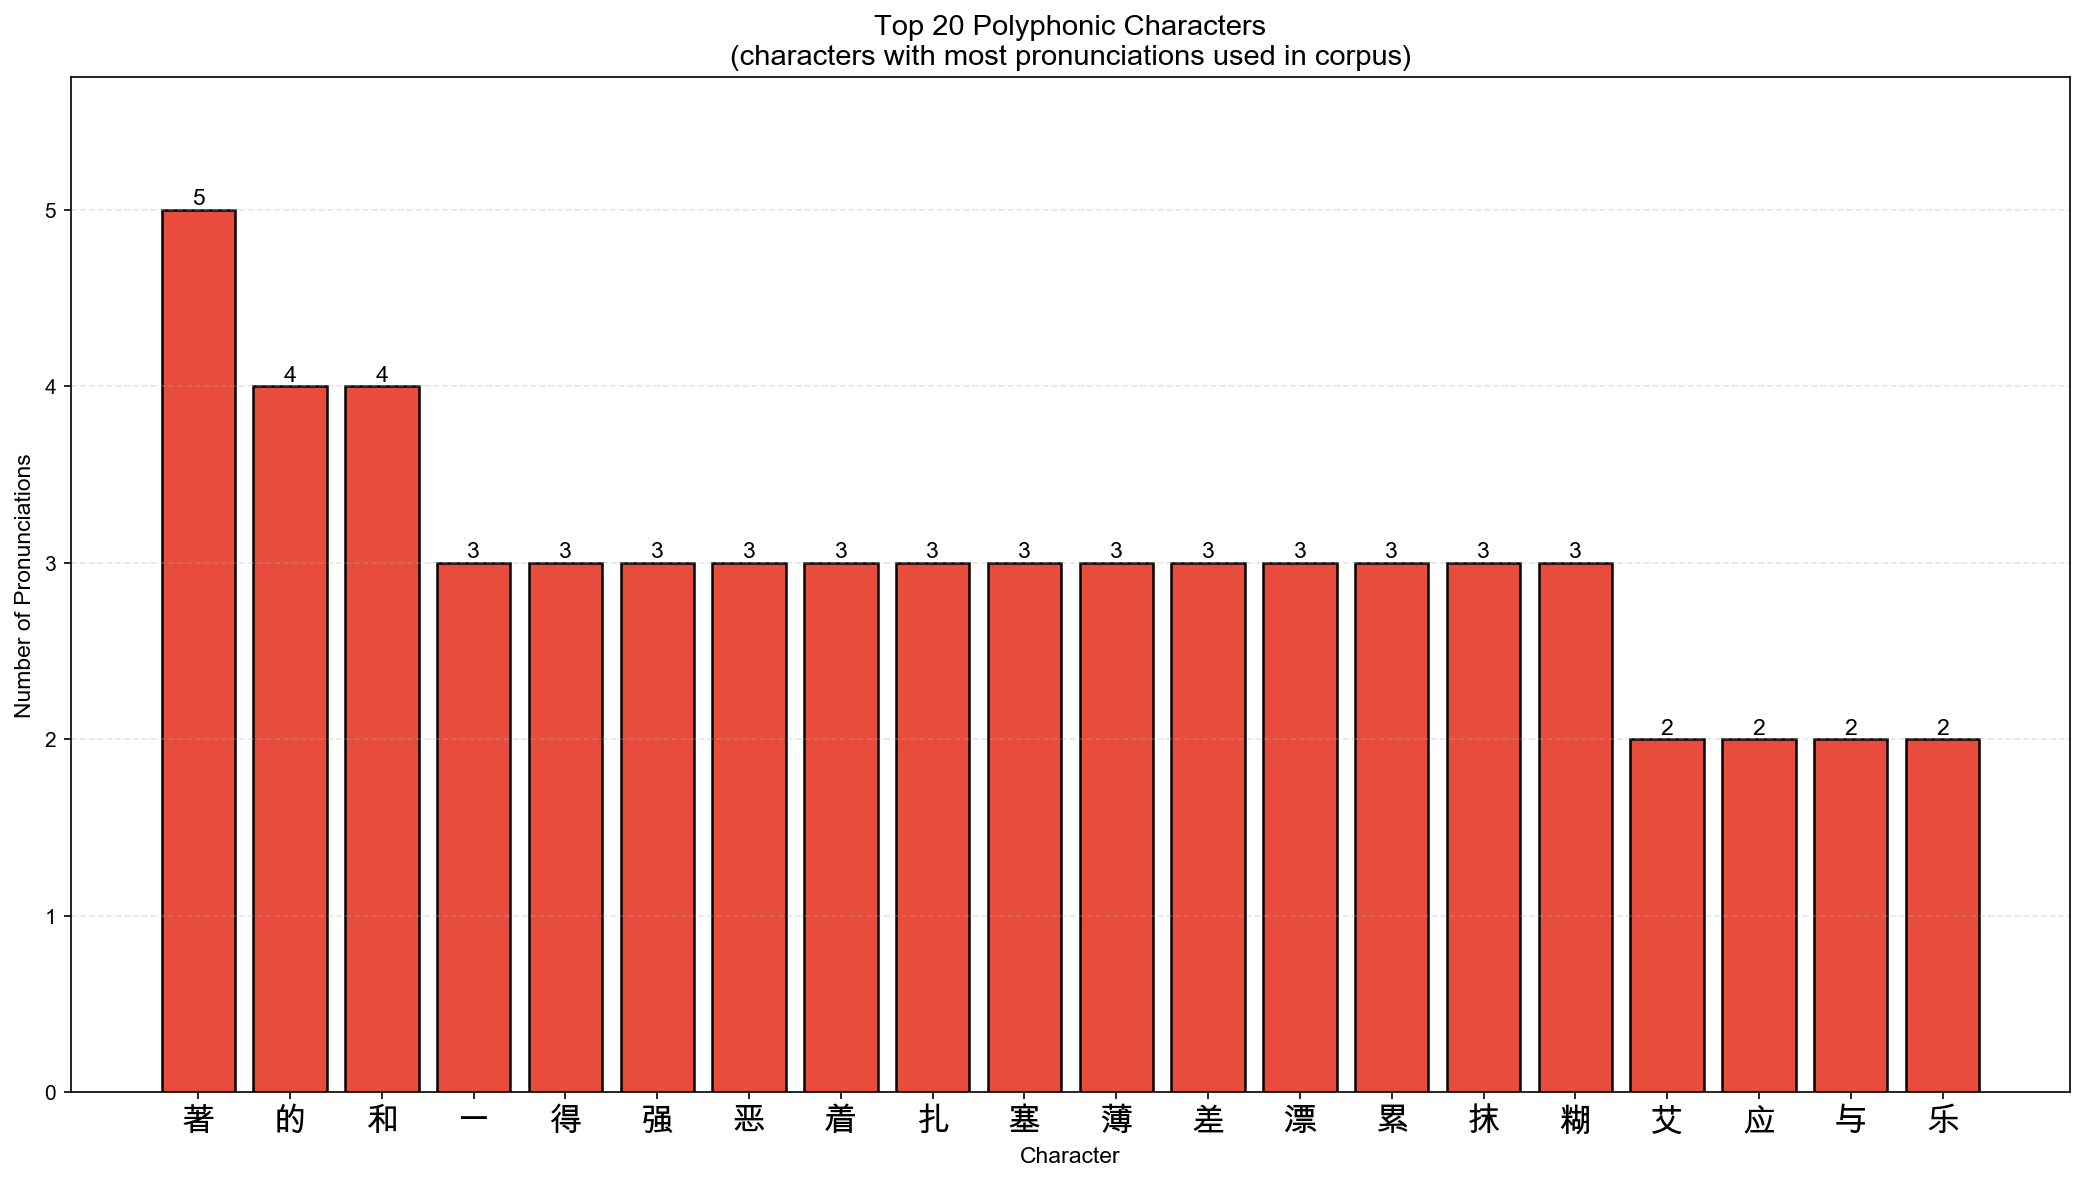 具多種讀音的前 20 個字
就算某些字確實有多種讀音,通常仍有一種佔主導:
- 的:4 種讀音,但 99.8% 的情況用
de0 - 一:3 種讀音,但
yi1是主要形式 - 著:5 種讀音(語料庫中讀音最多的字)
音節結構
大多數中文音節在深度 4 完成(3 個字母加聲調,例如 ban1 或 mao2):
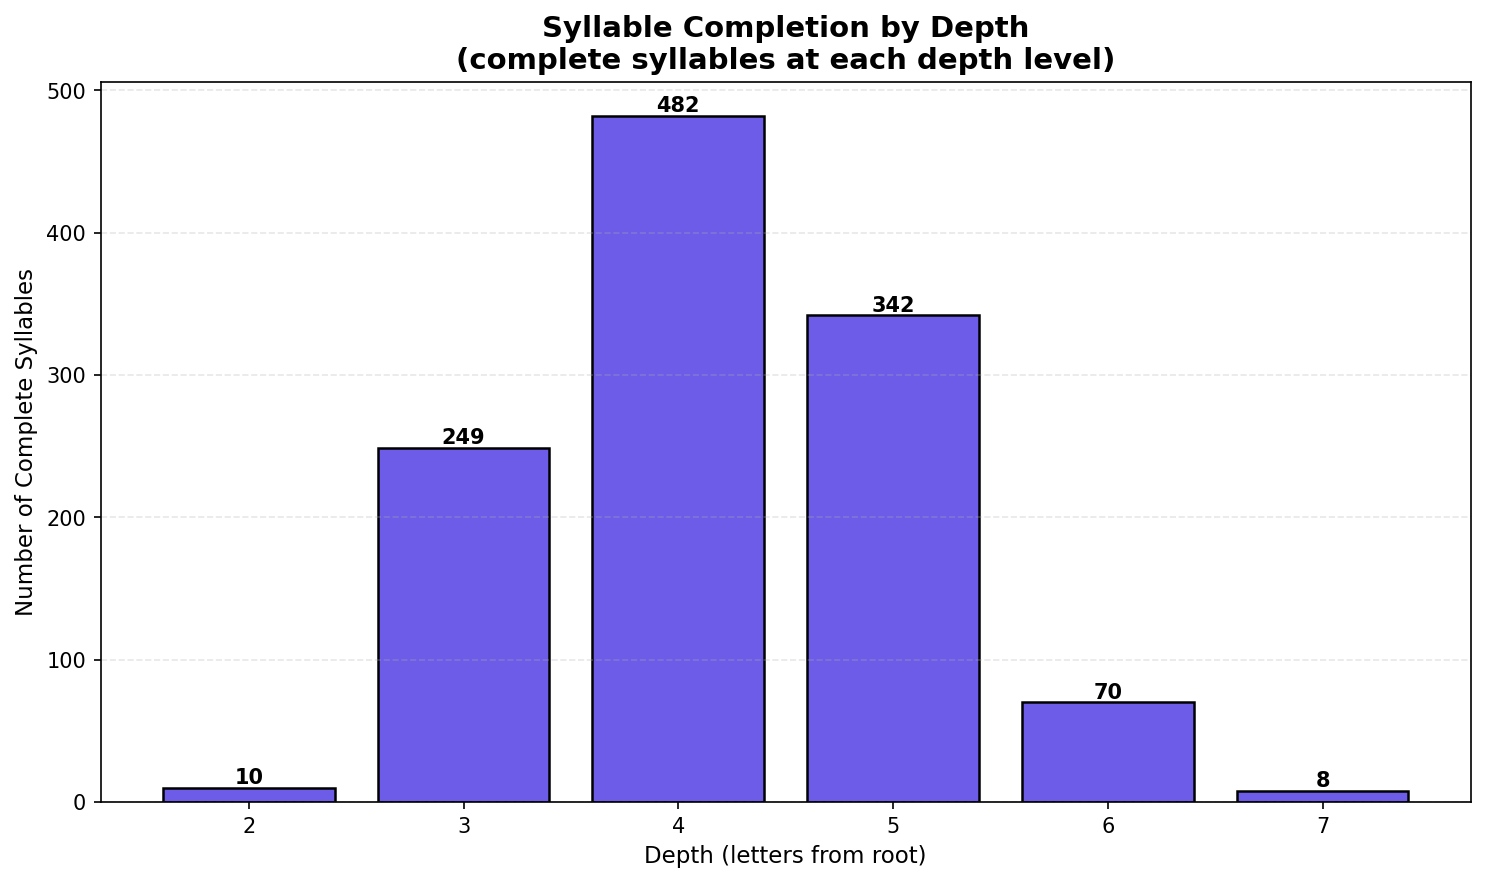 依深度統計的音節完成情況:41.5% 的音節在深度 4 完成(1,161 個中有 482 個)
最長的音節(深度 7:6 個字母加聲調)全都是 -uang 的組合:
- chuang1、chuang2、chuang3、chuang4
- shuang1、shuang3
- zhuang1、zhuang4
音節 × 聲調的覆蓋情況
去掉聲調後,1,161 個音節收斂為 401 個基本形式。這張熱圖顯示哪些基本音節在 5 種聲調中存在:
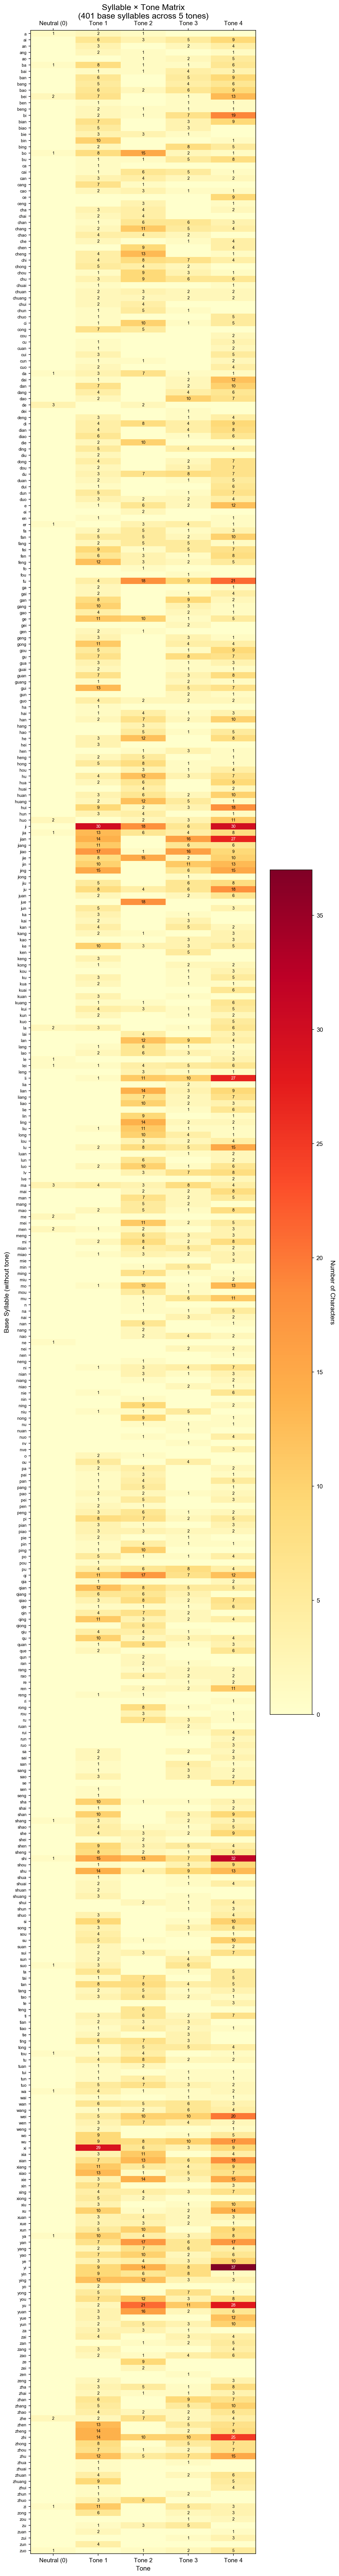 401 個基本音節 × 5 種聲調。格內數值為字數。有些基本音節在所有聲調中都存在,有些只出現在一兩種聲調。
觀察:
- 多數基本音節並不具備全部 5 種聲調變體
- 輕聲(第 0 欄)相當稀疏,只有 25 個基本音節有輕聲
- 有些基本音節只屬於特定聲調(只出現在 1 至 2 個聲調欄)
主要發現
- 79,704 個句子中共有 1,161 個不同音節;去掉聲調後為 401 個基本音節(每個基本音節平均 2.9 個聲調)
- 91.8% 的字在實務中只有一種讀音,教科書對多音字的強調在真實使用上被高估了
- 輕聲:佔音節的 2.2%,卻佔使用量的 8.4%;差距來自語法虛詞(的、了、吗、么)
- 第四聲佔主導,在音節、字與使用量各方面皆然(27 到 34%)
- 前 10 個音節佔所有字次的 18.8%;每個音節平均對應 4.5 個同音字,yi4 則高達 37 個
實務上的意義:學習者若掌握了最高十分位的音節及其主要讀音,就能涵蓋大部分閱讀負擔。多音字問題集中在一小群字上,而非散佈於整個語料庫。
技術說明
本分析基於 Tatoeba 語料庫 中的 79,704 個中文句子。我建立了一個以字元為單位的 Trie 資料結構,每個節點代表一個字母或聲調數字,終端節點則儲存字的中介資料與頻率資料。
工具: Python 3.9+、matplotlib(圖表)、graphviz(樹狀視覺化)
資料流程:
- 從語料庫中提取字
- 以 jieba 搭配 pypinyin 及/或 GPT-4o-mini 計算拼音
- 建立 Trie 結構
- 分析分佈、規律與邊界情況
資源
- GitHub 上的 hanzi-flow:完整分析程式碼與視覺化
- Tatoeba:句子語料庫