汉语拼音全解析:79,000多句语料揭示了什么
简而言之
- 我梳理了Tatoeba中79,704个中文句子的拼音:共1,161个不同音节,去掉声调后合并为401个。
- 第四声在各项指标上都领先,占27%到34%。轻声只占音节总数的2.2%,但在实际使用中占8.4%,因为常用虚词(的、了、吗)全是轻声。
- 多音字比教科书暗示的更少见:语料中5,002个汉字里只有199个(3.8%)在实际使用中有多个读音,而且通常有一个读音占绝对优势。
- 前10个音节覆盖了所有汉字读音的18.8%,其中仅yi4一个音节就对应37个汉字。
我分析了Tatoeba中79,704个中文句子,想弄清哪些拼音音节真正会在实践中出现。这份语料包含1,161个不同音节(可能还有一些更生僻的未被涵盖)。我用Trie(字典树)数据结构映射了每个音节,发现声调分布、汉字复杂度和多音字读音上的一些规律,与教科书的说法有所不同。
以下是数据揭示的内容。
Trie结构
Trie(前缀树)是一种数据结构,从根到叶的每条路径代表一个完整字符串。对拼音来说,每个节点是一个字母,沿着h → a → n → 4这样的路径走下去,就得到音节「han4」。
拼音音节构成一棵树,每个字母都是一个节点。下面是完整的h分支,展示音节如何从根节点延伸到终端节点:
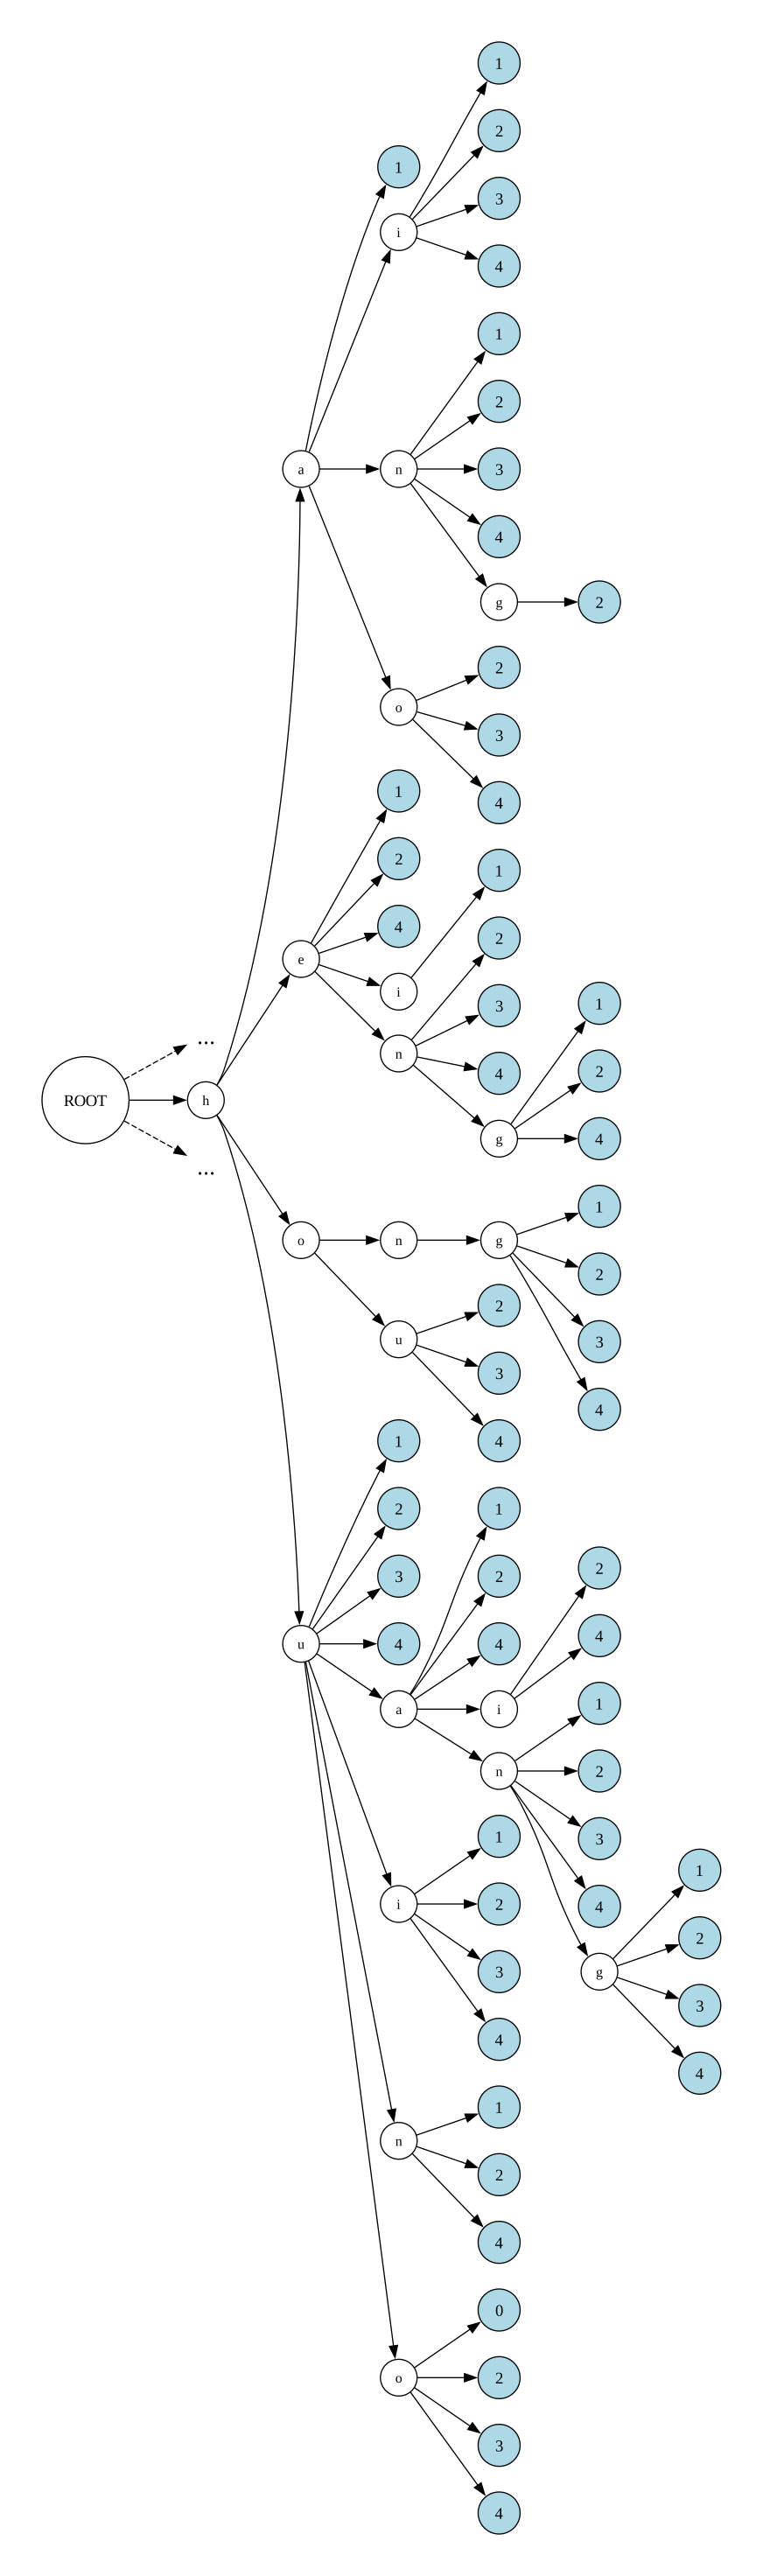
从根节点到所有完整音节(ha、hao、he等)的h分支。虚线表示其他分支。
了解更多:
第1层 →
第2层 →
第3层 →
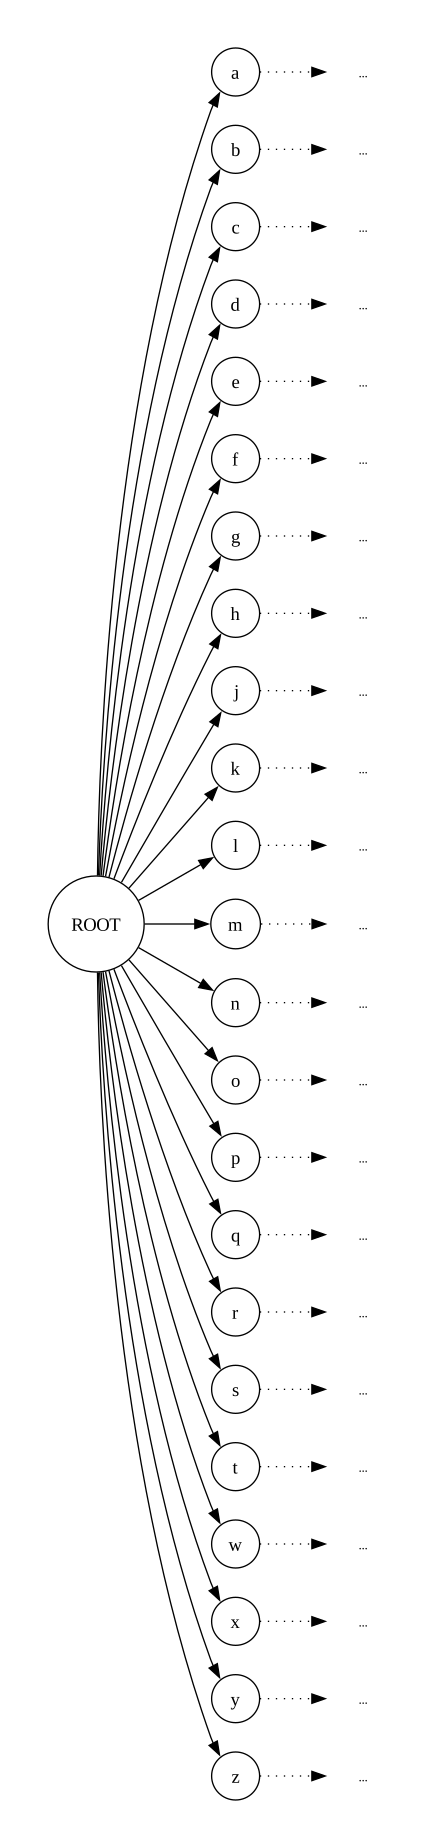
完整字典树 → (鼠标悬停在节点上可查看详情)



声调悖论
轻声只占不同音节的2.2%,但在实际汉字使用中占8.4%。为什么?因为极其常见的语法虚词(的、了、吗、么)全都是轻声:
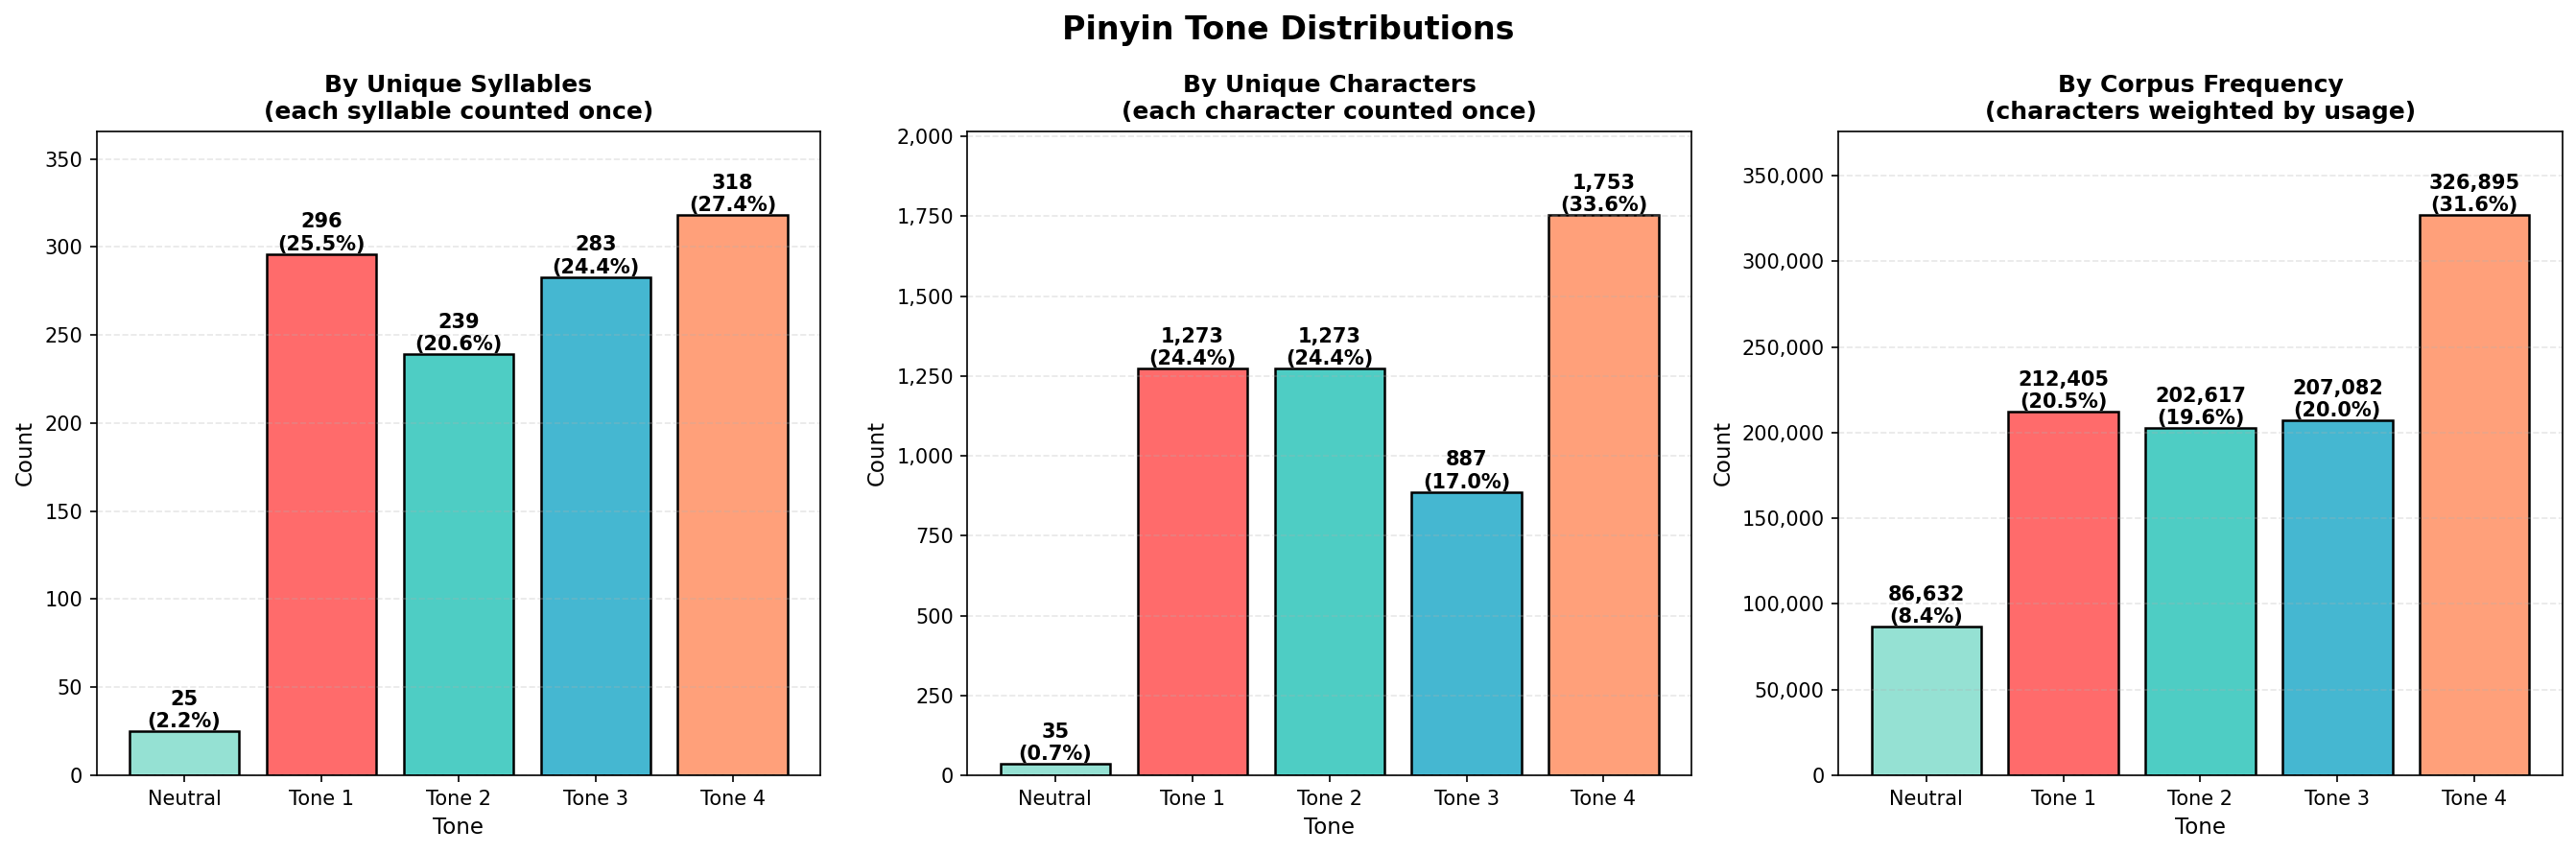 从三个角度看声调:按音节、按汉字、按频率
核心发现:第四声占主导,在所有指标上都是如此(27%到34%),而轻声因虚词频率极高,影响力远超其占比。
音节拥挤度
多数拼音音节只对应少数几个汉字。但有几个音节极为拥挤:
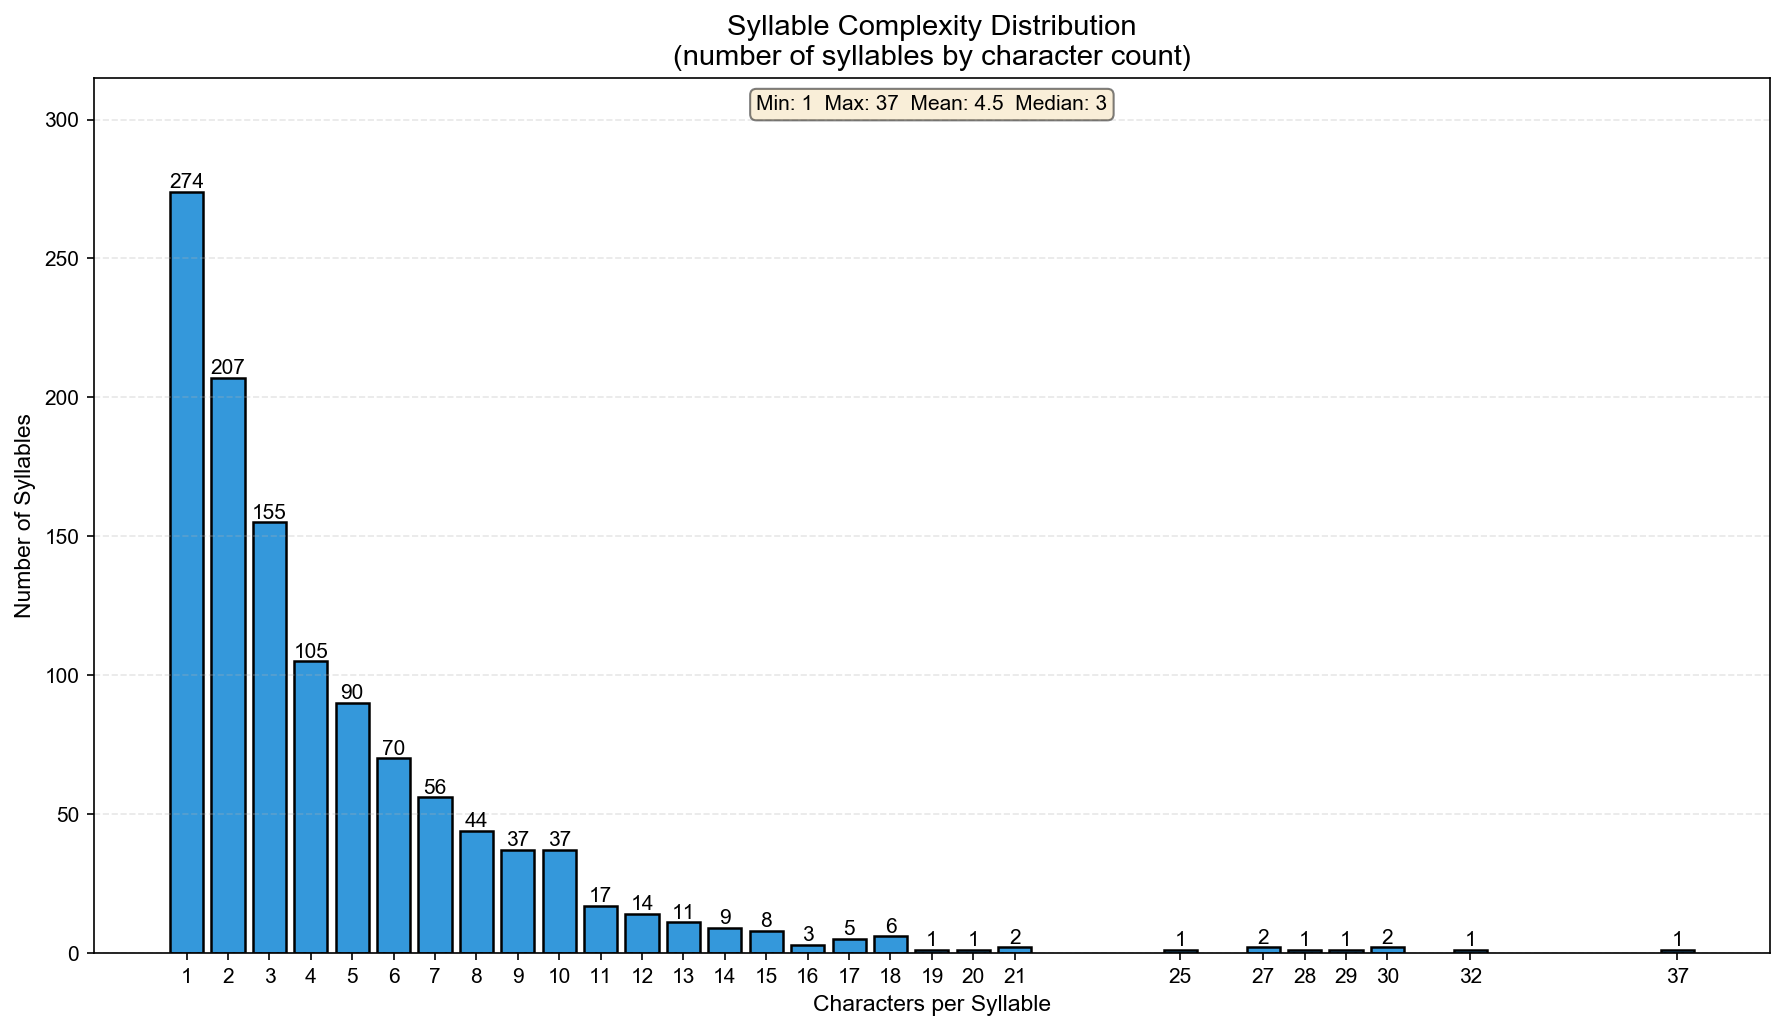 每个音节对应的汉字数量,多数为3到4个,但有些超过
30+
最拥挤的音节:
- yi4:37个汉字(意、义、议、异、易、亿、艺、益……)
- shi4:32个汉字(是、事、市、式、试、视、世、士……)
- ji4:30个汉字(记、际、计、技、季、继、既、寄……)
与此同时,有些音节只对应唯一一个汉字:wo3(我)、le0(了)、ni3(你)。
多音字的迷思
教科书强调许多汉字有多个读音。但在这份语料出现的5,002个汉字中,只有3.8%(199个字)确实是多音字。虽然Unicode定义了80,000多个汉字,本分析关注的是学习者在真实使用中会遇到的部分:
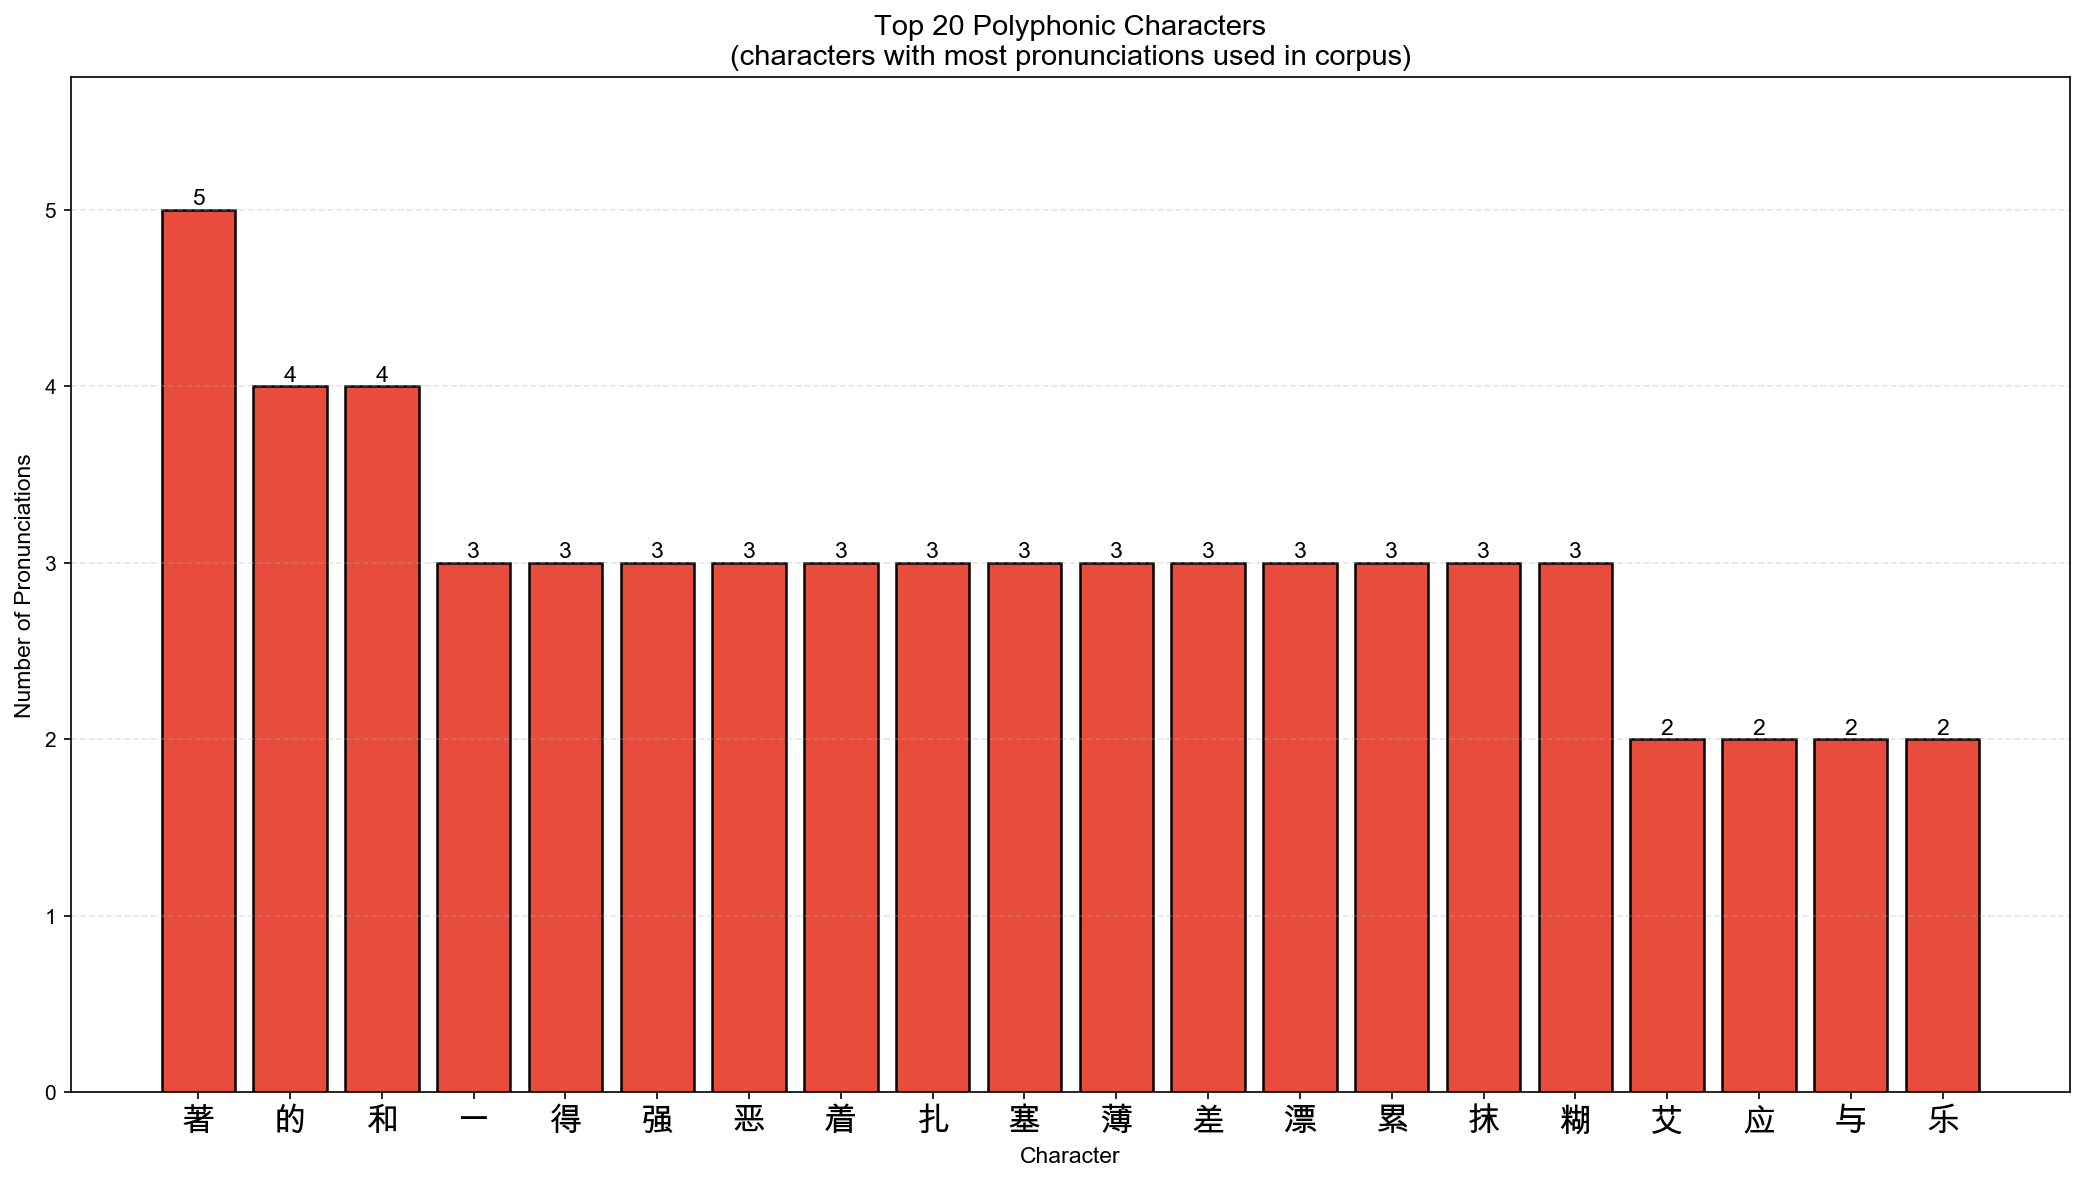 读音最多的前20个汉字
即便汉字确实有多个读音,通常也有一个读音占主导:
- 的:4个读音,但99.8%的情况下读
de0 - 一:3个读音,但
yi1是主要形式 - 著:5个读音(语料中读音最多的汉字)
音节结构
多数汉语音节在深度4处结束(3个字母加声调,如ban1或mao2):
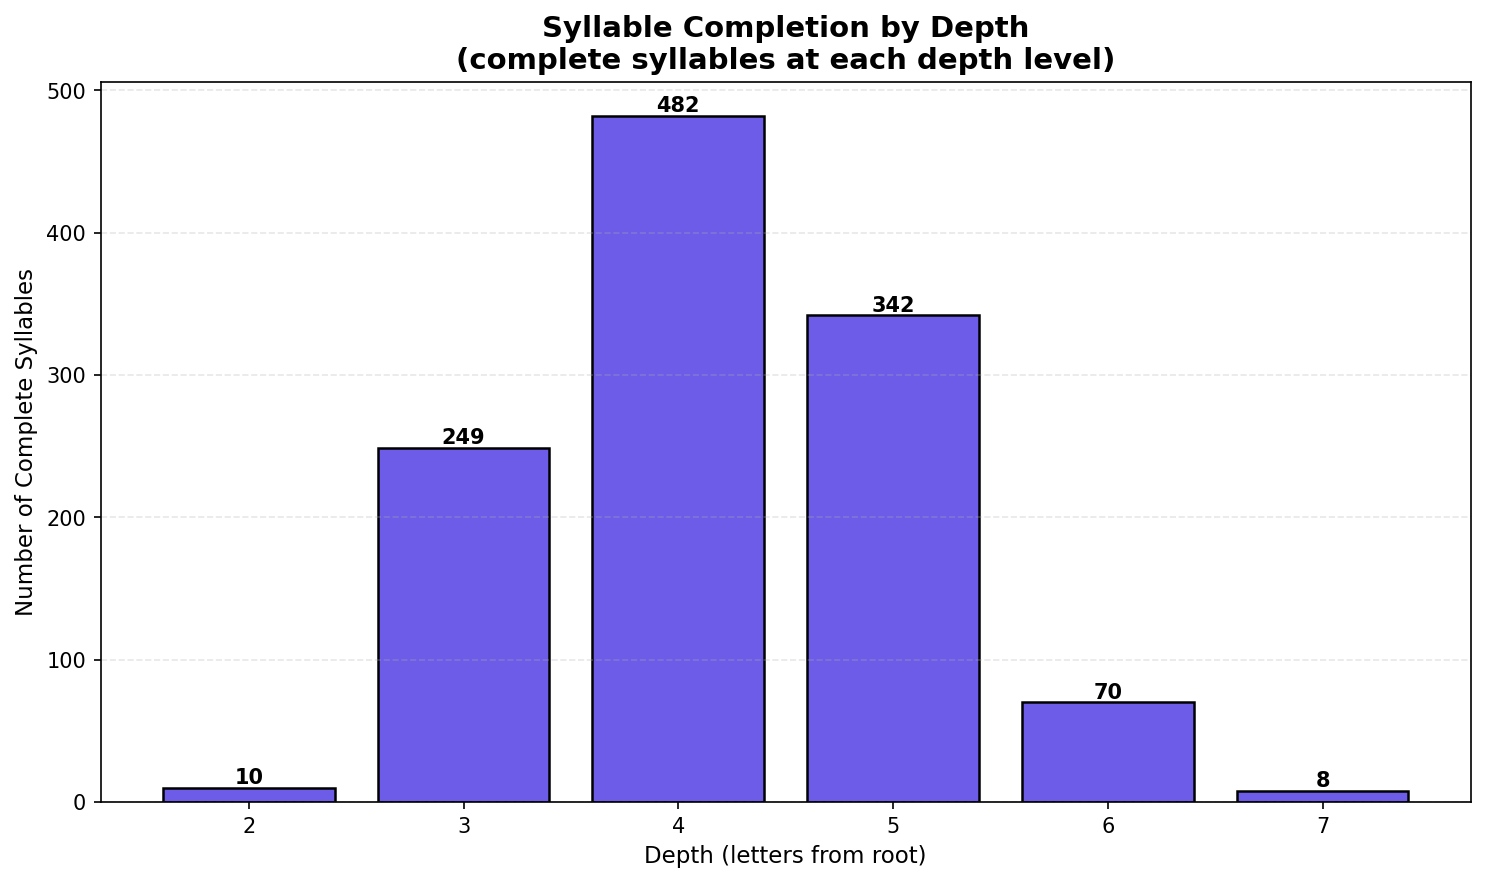 按深度统计的音节完成情况,41.5%的音节在深度4处结束(1,161个中有482个)
最长的音节(深度7:6个字母加声调)全都是-uang组合:
- chuang1, chuang2, chuang3, chuang4
- shuang1, shuang3
- zhuang1, zhuang4
音节 × 声调覆盖
去掉声调后,1,161个音节合并为401个基本形式。下面这张热力图展示了哪些基本音节在5个声调上分别存在:
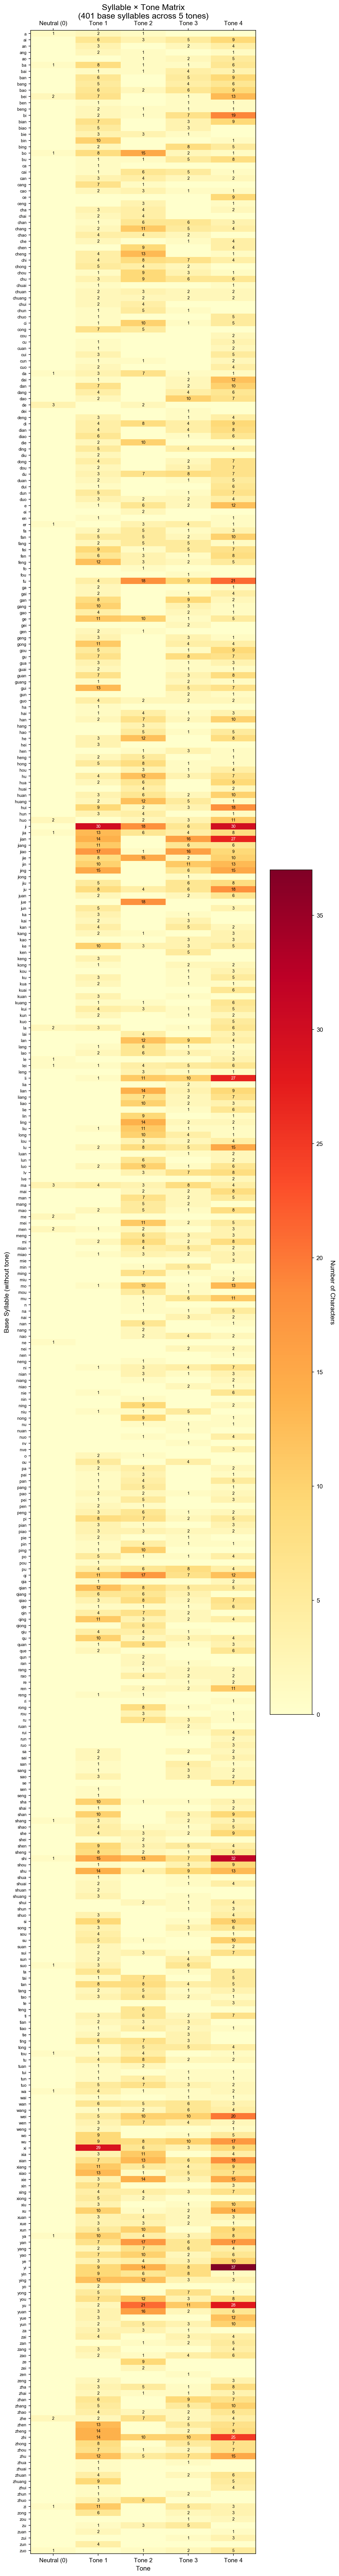 401个基本音节 × 5个声调。单元格数值表示汉字数量。有些基本音节在所有声调上都存在,有些只出现在一两个声调上。
观察结果:
- 多数基本音节并不具备全部5个声调变体
- 轻声(第0列)很稀疏,只有25个基本音节有轻声形式
- 有些基本音节只属于特定声调(仅出现在1到2个声调列中)
主要发现
- 79,704个句子中有1,161个不同音节;去掉声调后为401个基本音节(平均每个基本音节有2.9个声调)
- 91.8%的汉字在实际使用中只有一个读音,教科书对多音现象的强调在真实语料中被夸大了
- 轻声:占音节的2.2%,但占实际使用的8.4%,差距来自语法虚词(的、了、吗、么)
- 第四声占主导,在音节、汉字和使用频率上都是如此(27%到34%)
- 前10个音节占所有汉字出现次数的18.8%;每个音节平均对应4.5个同音字,yi4则高达37个
实际意义在于:学习者只要掌握排名前10%的音节及其主要读音,就能覆盖大部分阅读量。多音字问题集中在一小批汉字上,并非散布于整个语料。
技术说明
本分析基于Tatoeba语料库中79,704个中文句子。我构建了一个字符级Trie数据结构,每个节点代表一个字母或声调数字,终端节点存储汉字元数据和频率数据。
工具:Python 3.9+、matplotlib(图表)、graphviz(树形可视化)
数据流程:
- 从语料中提取汉字
- 用jieba加pypinyin和/或GPT-4o-mini计算拼音
- 构建Trie结构
- 分析分布、规律和边缘情况
资源
- GitHub上的hanzi-flow - 完整分析代码与可视化
- Tatoeba - 句子语料库