Hanzi Flow:自适应中文阅读器
简述
- Hanzi Flow 是一款中文阅读应用:你输入真实句子的拼音,它会挑选下一句,使其中包含 2 到 5 个你还不认识的汉字。
- 它取材于 79,000+ 条 Tatoeba 句子。用 GPT-4o-mini 对基于规则生成的拼音做了一遍校验,修正了 10,336 处错误,比如把 著 读成 zhu4 而实际应为 zhe。
- 每个字的掌握度是一个移动平均值,间隔复习从一小时起步,因此新字会在同一次练习中反复出现多次。
- 它是本地优先的:无需账号,进度保存在网页浏览器中,可离线使用。
Hanzi Flow 是一款围绕一个想法构建的汉字练习应用:自适应句子挑选。它会根据你当前的掌握程度(从 79,000+ 条真实例句中)挑出含 2 到 5 个生字的句子,让你稳定处于 90% 到 95% 的理解区间。无需管理卡组,只需输入拼音开始练习。
源码: github.com/brianhliou/hanzi-flow
现有工具的问题
中文学习应用基本上分为三类,而它们都有缺点。
像 Anki 这样的闪卡应用 让你背孤立的汉字。你花在整理卡组上的时间比真正学习的时间还多。等你终于在真实文本里见到某个字时,却认不出来,因为你学它时脱离了任何语境。
像 Pleco 这样的词典应用 查词很好用,但完全是被动的。你读了,你懂了,却什么也记不住。没有主动回忆,没有输入练习。
阅读应用和家教 给你的要么是儿童读物(枯燥),要么是母语者内容(难度过高)。你要么无聊,要么被压垮,两者都无法培养流利度。
缺失的一环是保持心流。也就是 90% 到 95% 理解率的那个区间,有挑战但不至于受挫。你需要难度恰当的句子,自动挑选,并通过输入实现主动回忆。
我做了什么
Hanzi Flow 是带自适应难度的句子练习。你读中文、输入拼音,应用会根据你对每个字的熟悉程度挑选下一句。它有 Anki 的间隔重复但不必管理卡组;有 Duolingo 的练习循环,但用的是真实句子而非短语手册里的例句。
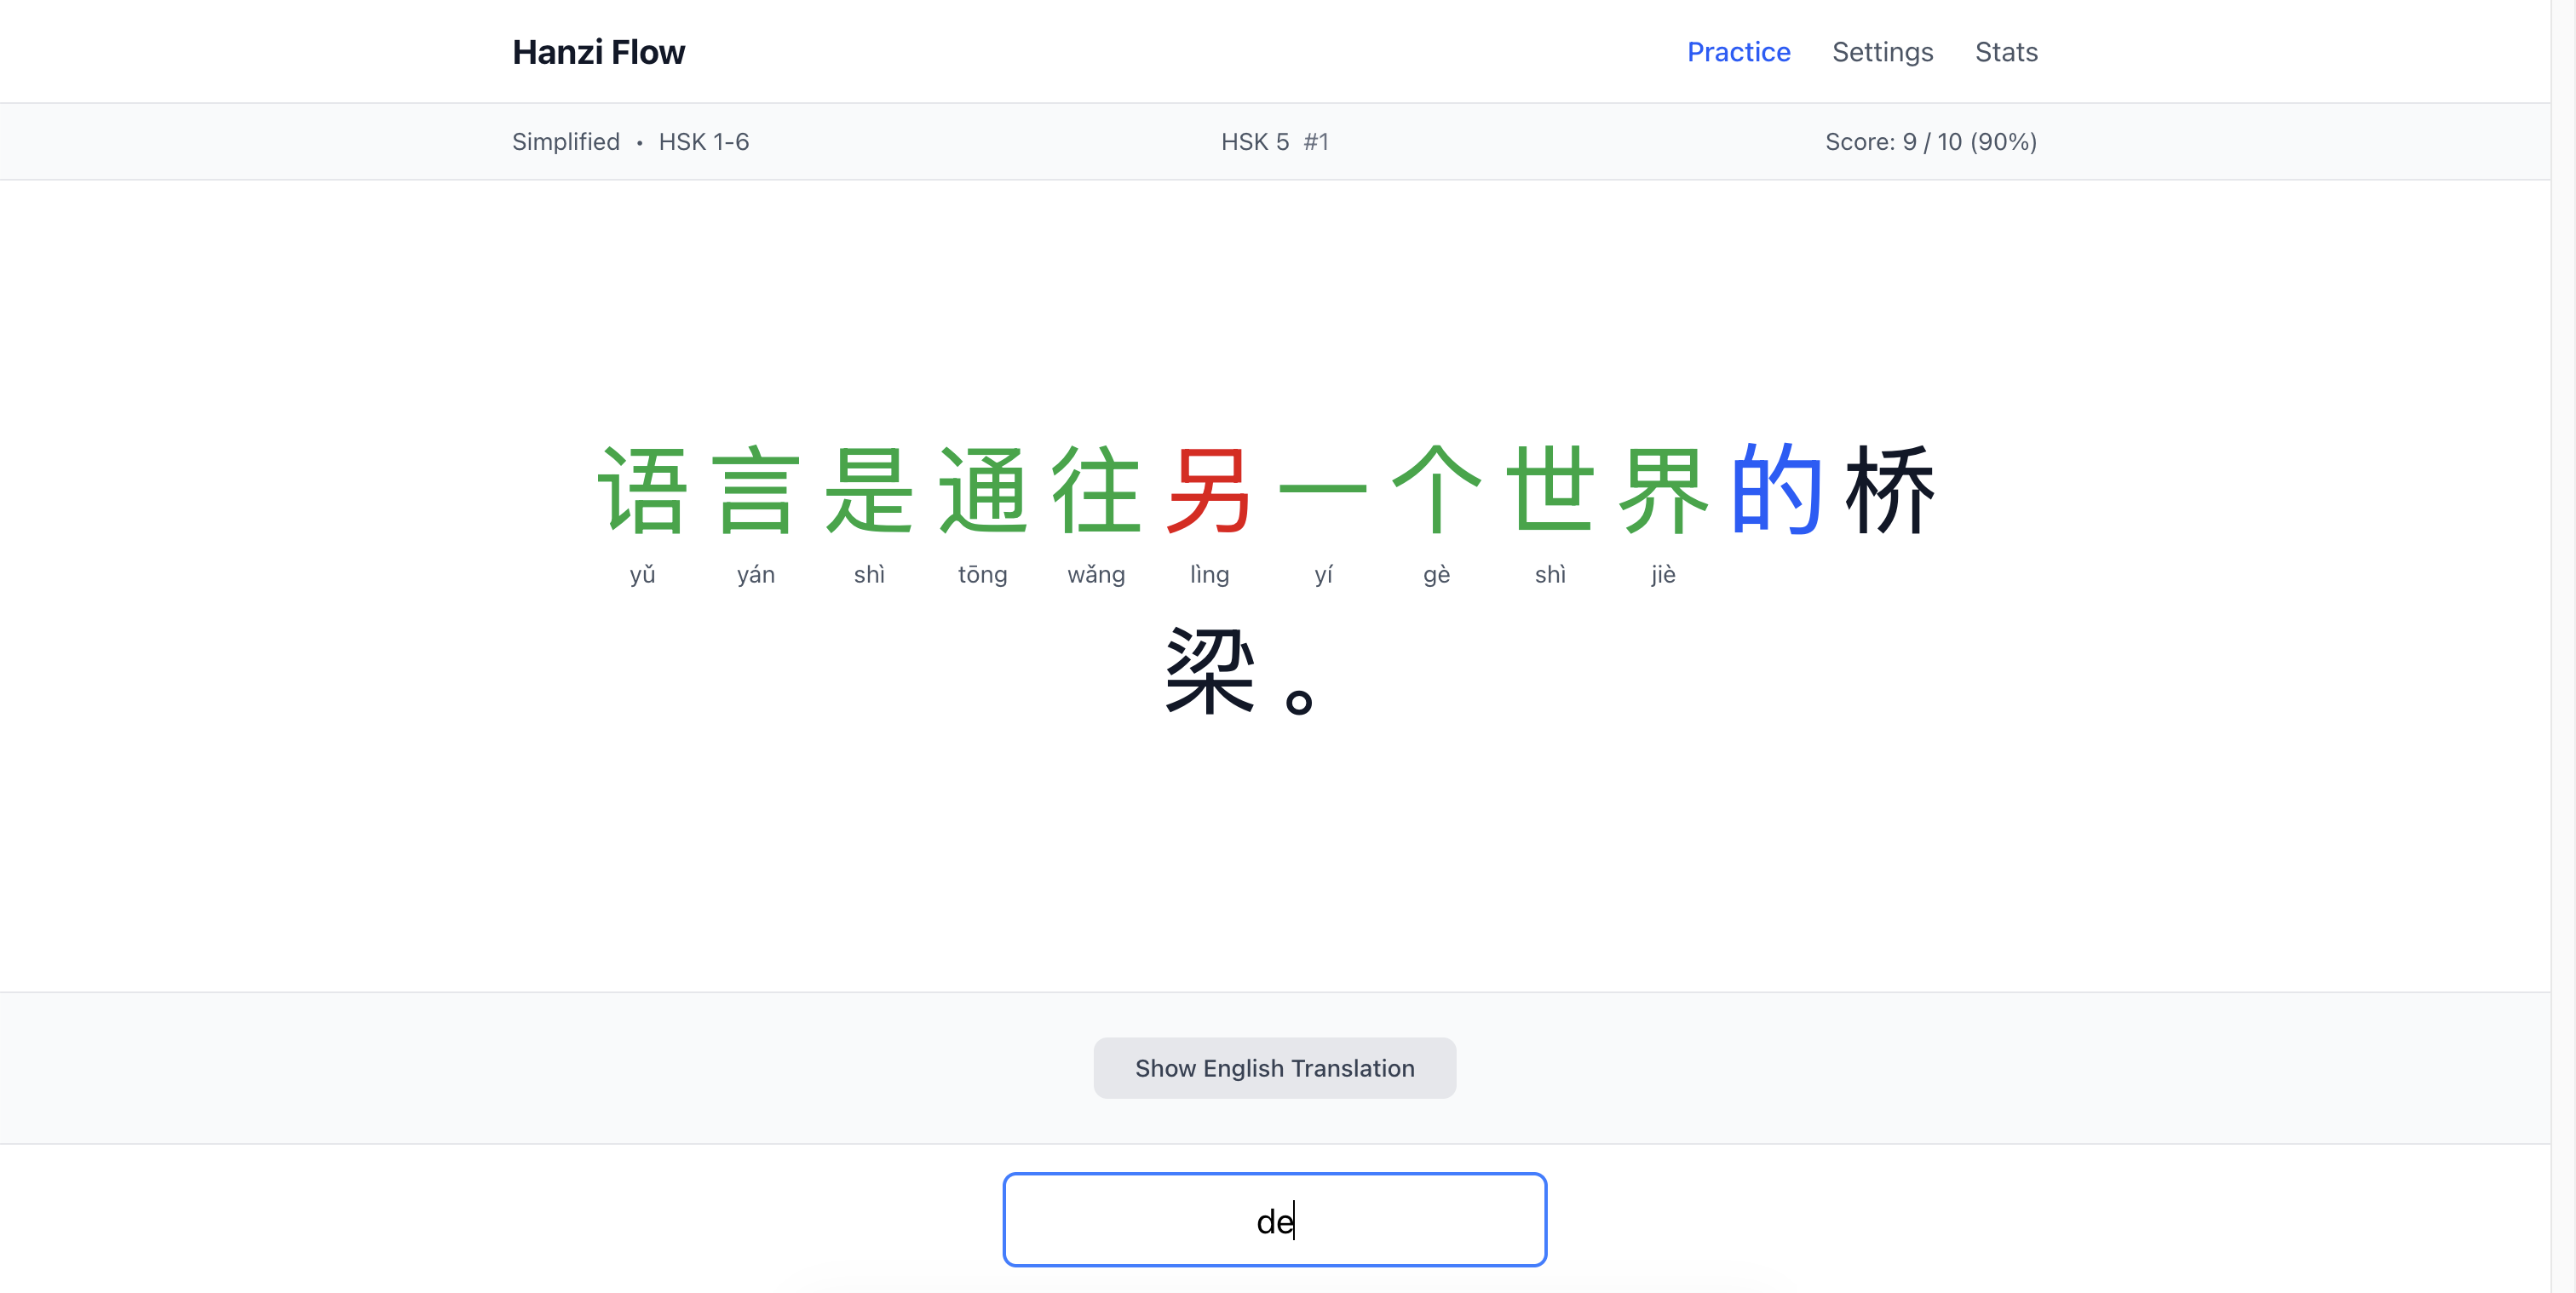
这款应用:
- 来自 Tatoeba 的 79,000+ 条句子(真实用法,而非教材例句)
- 4,000+ 个汉字 —— HSK 1-9 级,另加约 1,000 个 HSK 之外的字
- 自适应算法 —— 根据你的掌握程度挑选含 2 到 5 个生字的句子
- 掌握度追踪 —— 单字级别的分数,配合间隔重复(EWMA + SRS)
- 对齐 HSK 3.0 —— 按官方大纲等级筛选(1-9 级或超纲)
- 字形支持 —— 简体、繁体或混合
- 实时反馈 —— 彩色视觉提示,另有 1,598 个音频文件(涵盖全部拼音音节)
- 100% 本地优先 —— 无账号、无追踪、可离线使用
你练习符合自己水平的真实句子,通过拼音输入培养输入流利度,系统会随着你的进步而调整。无需手动管理卡组。
使用体验
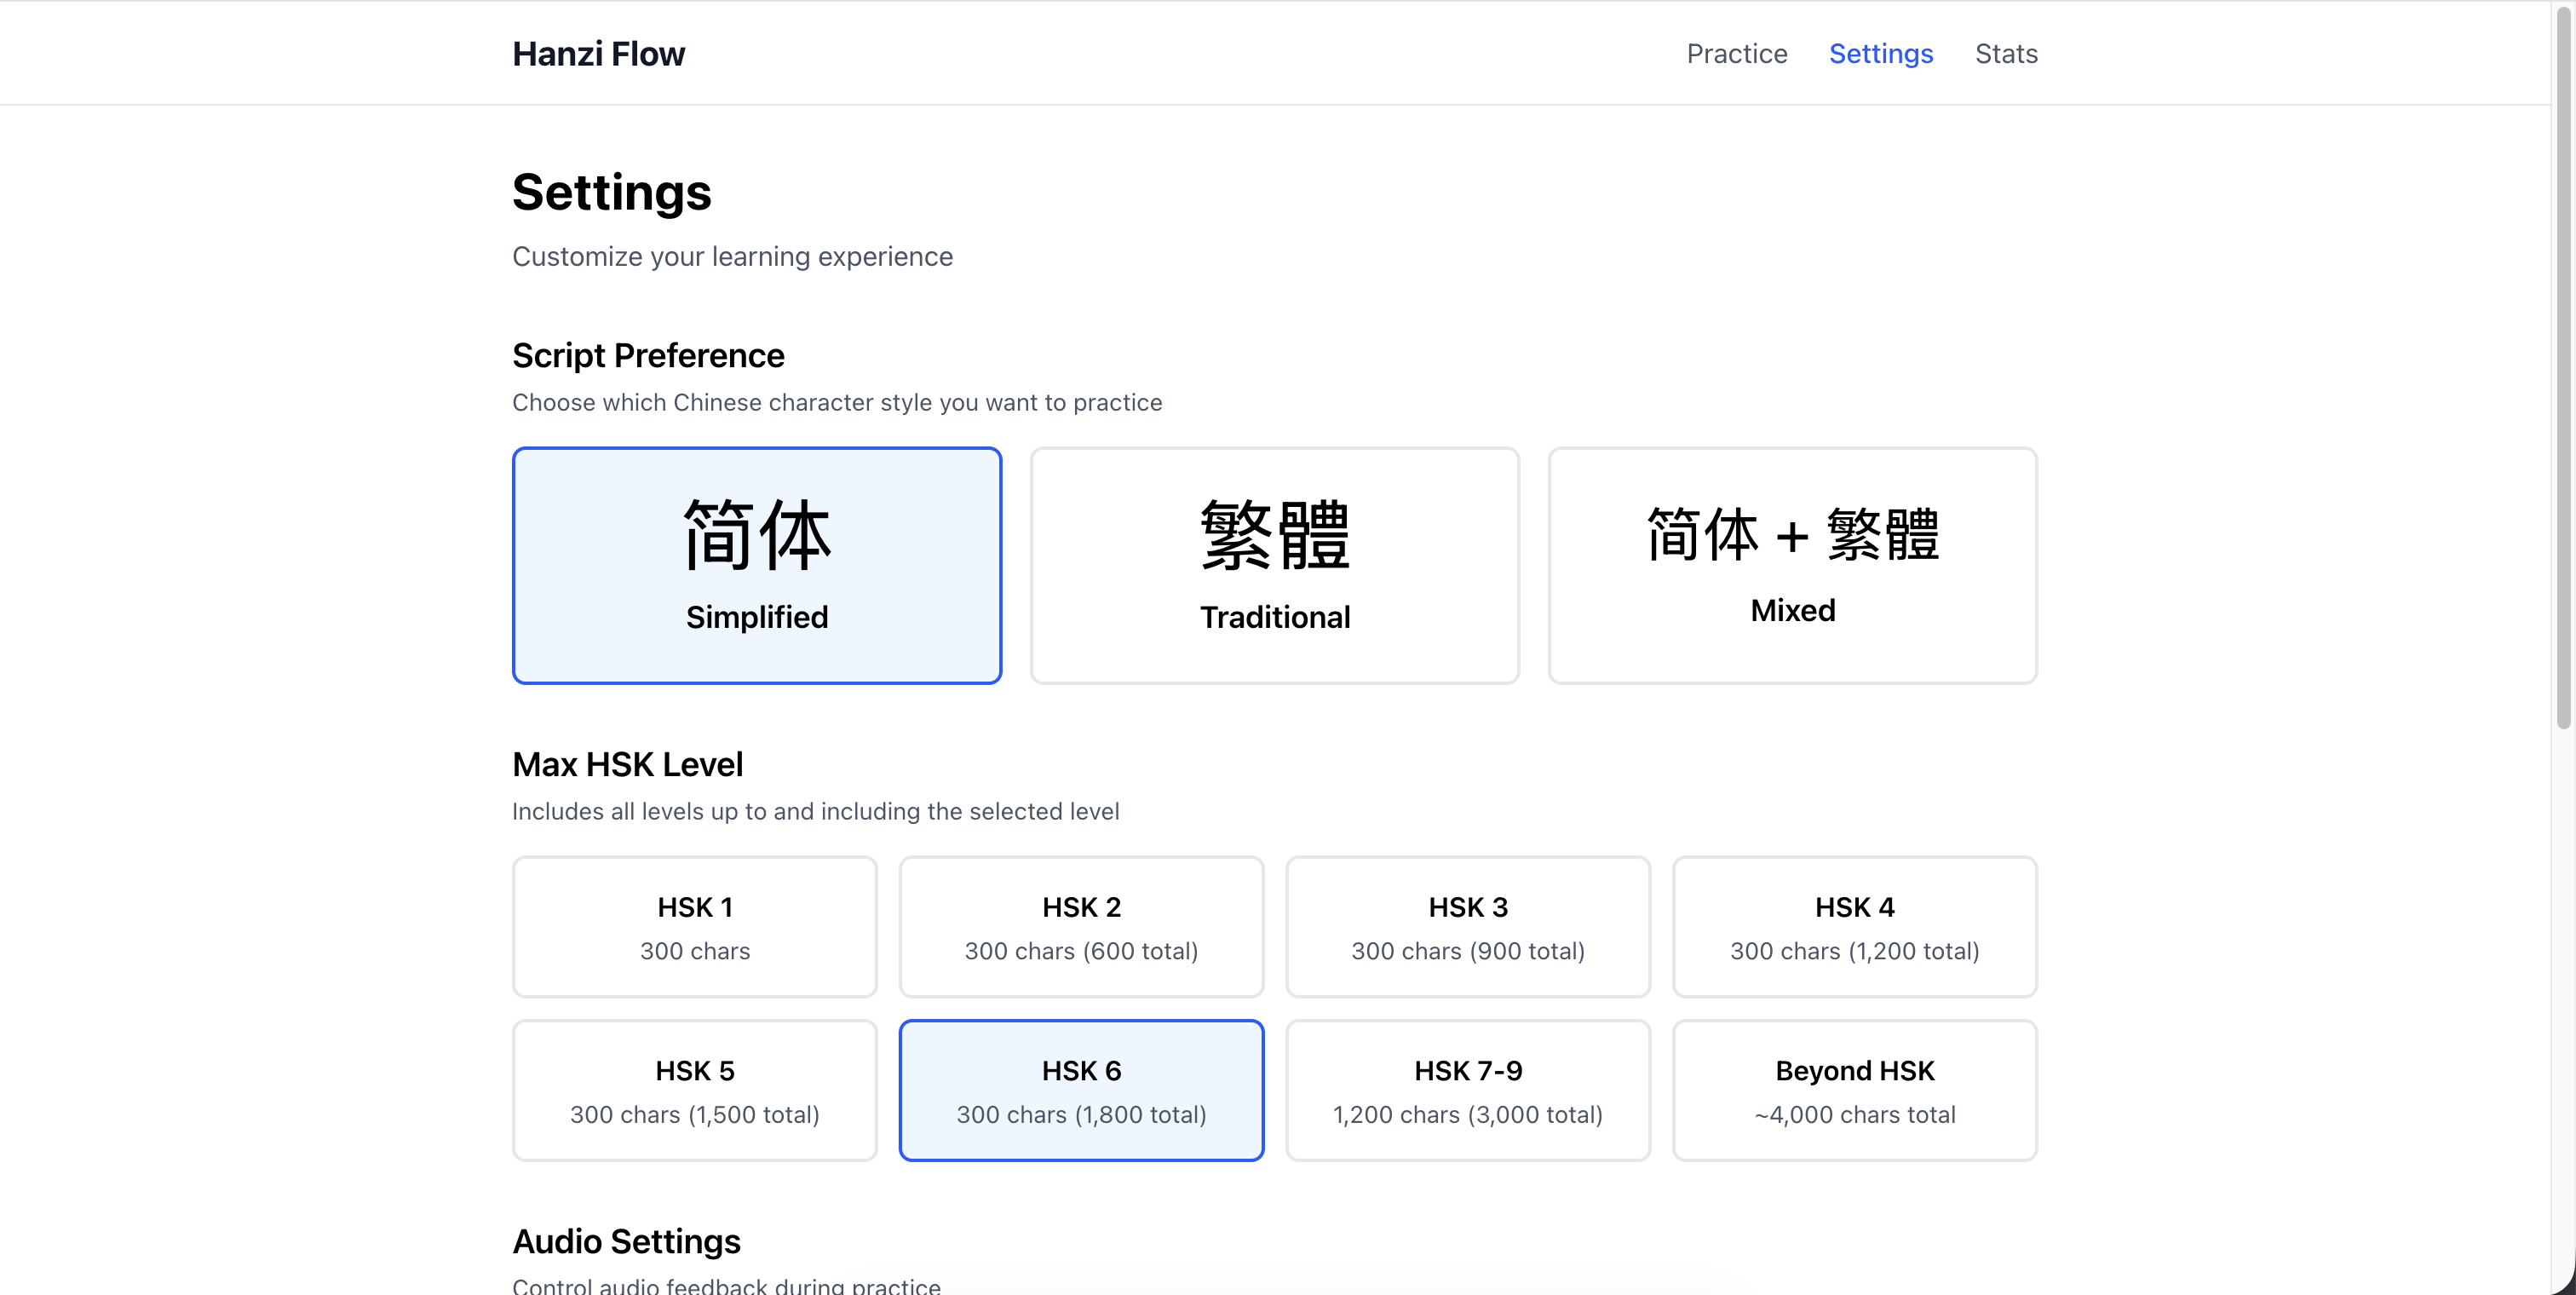
首次运行:设置偏好
第一次打开应用时,你要选两样东西:
字形类型:简体、繁体或混合。这会筛选语料库以匹配你的目标。
HSK 等级:筛选是累积的。选择「HSK 1-3」,你得到的句子只使用 1、2、3 级的汉字。选择「超出 HSK」则包含官方大纲之外约 1,000 个高级汉字。
这些设置随时可以在设置页更改。更改后,应用会清空当前的句子队列,并按新的筛选条件重新生成。
练习循环
练习很直接:
- 读句子 —— 汉字大字号显示
- 输入拼音 —— 逐字输入,声调可选(
wo3或wo都可以) - 获得反馈 —— 当前字高亮为蓝色,错误则红色闪烁并可重试(最多 4 次)
- 查看拼音 —— 每个字下方显示带声调的正确答案
- 揭示翻译 —— 完成后底部可选显示英文
- 下一句 —— 按空格键或点击按钮
反馈即时且直观。你的注意力始终在当前字上(蓝色高亮)。答错会红色闪烁,并播放正确读音的音频。系统给你 4 次机会,之后就会跳过,并把该字标为紫色(放弃)。系统接受多音读法(地 既接受 de 也接受 di),但会告诉你符合语境的那一个。
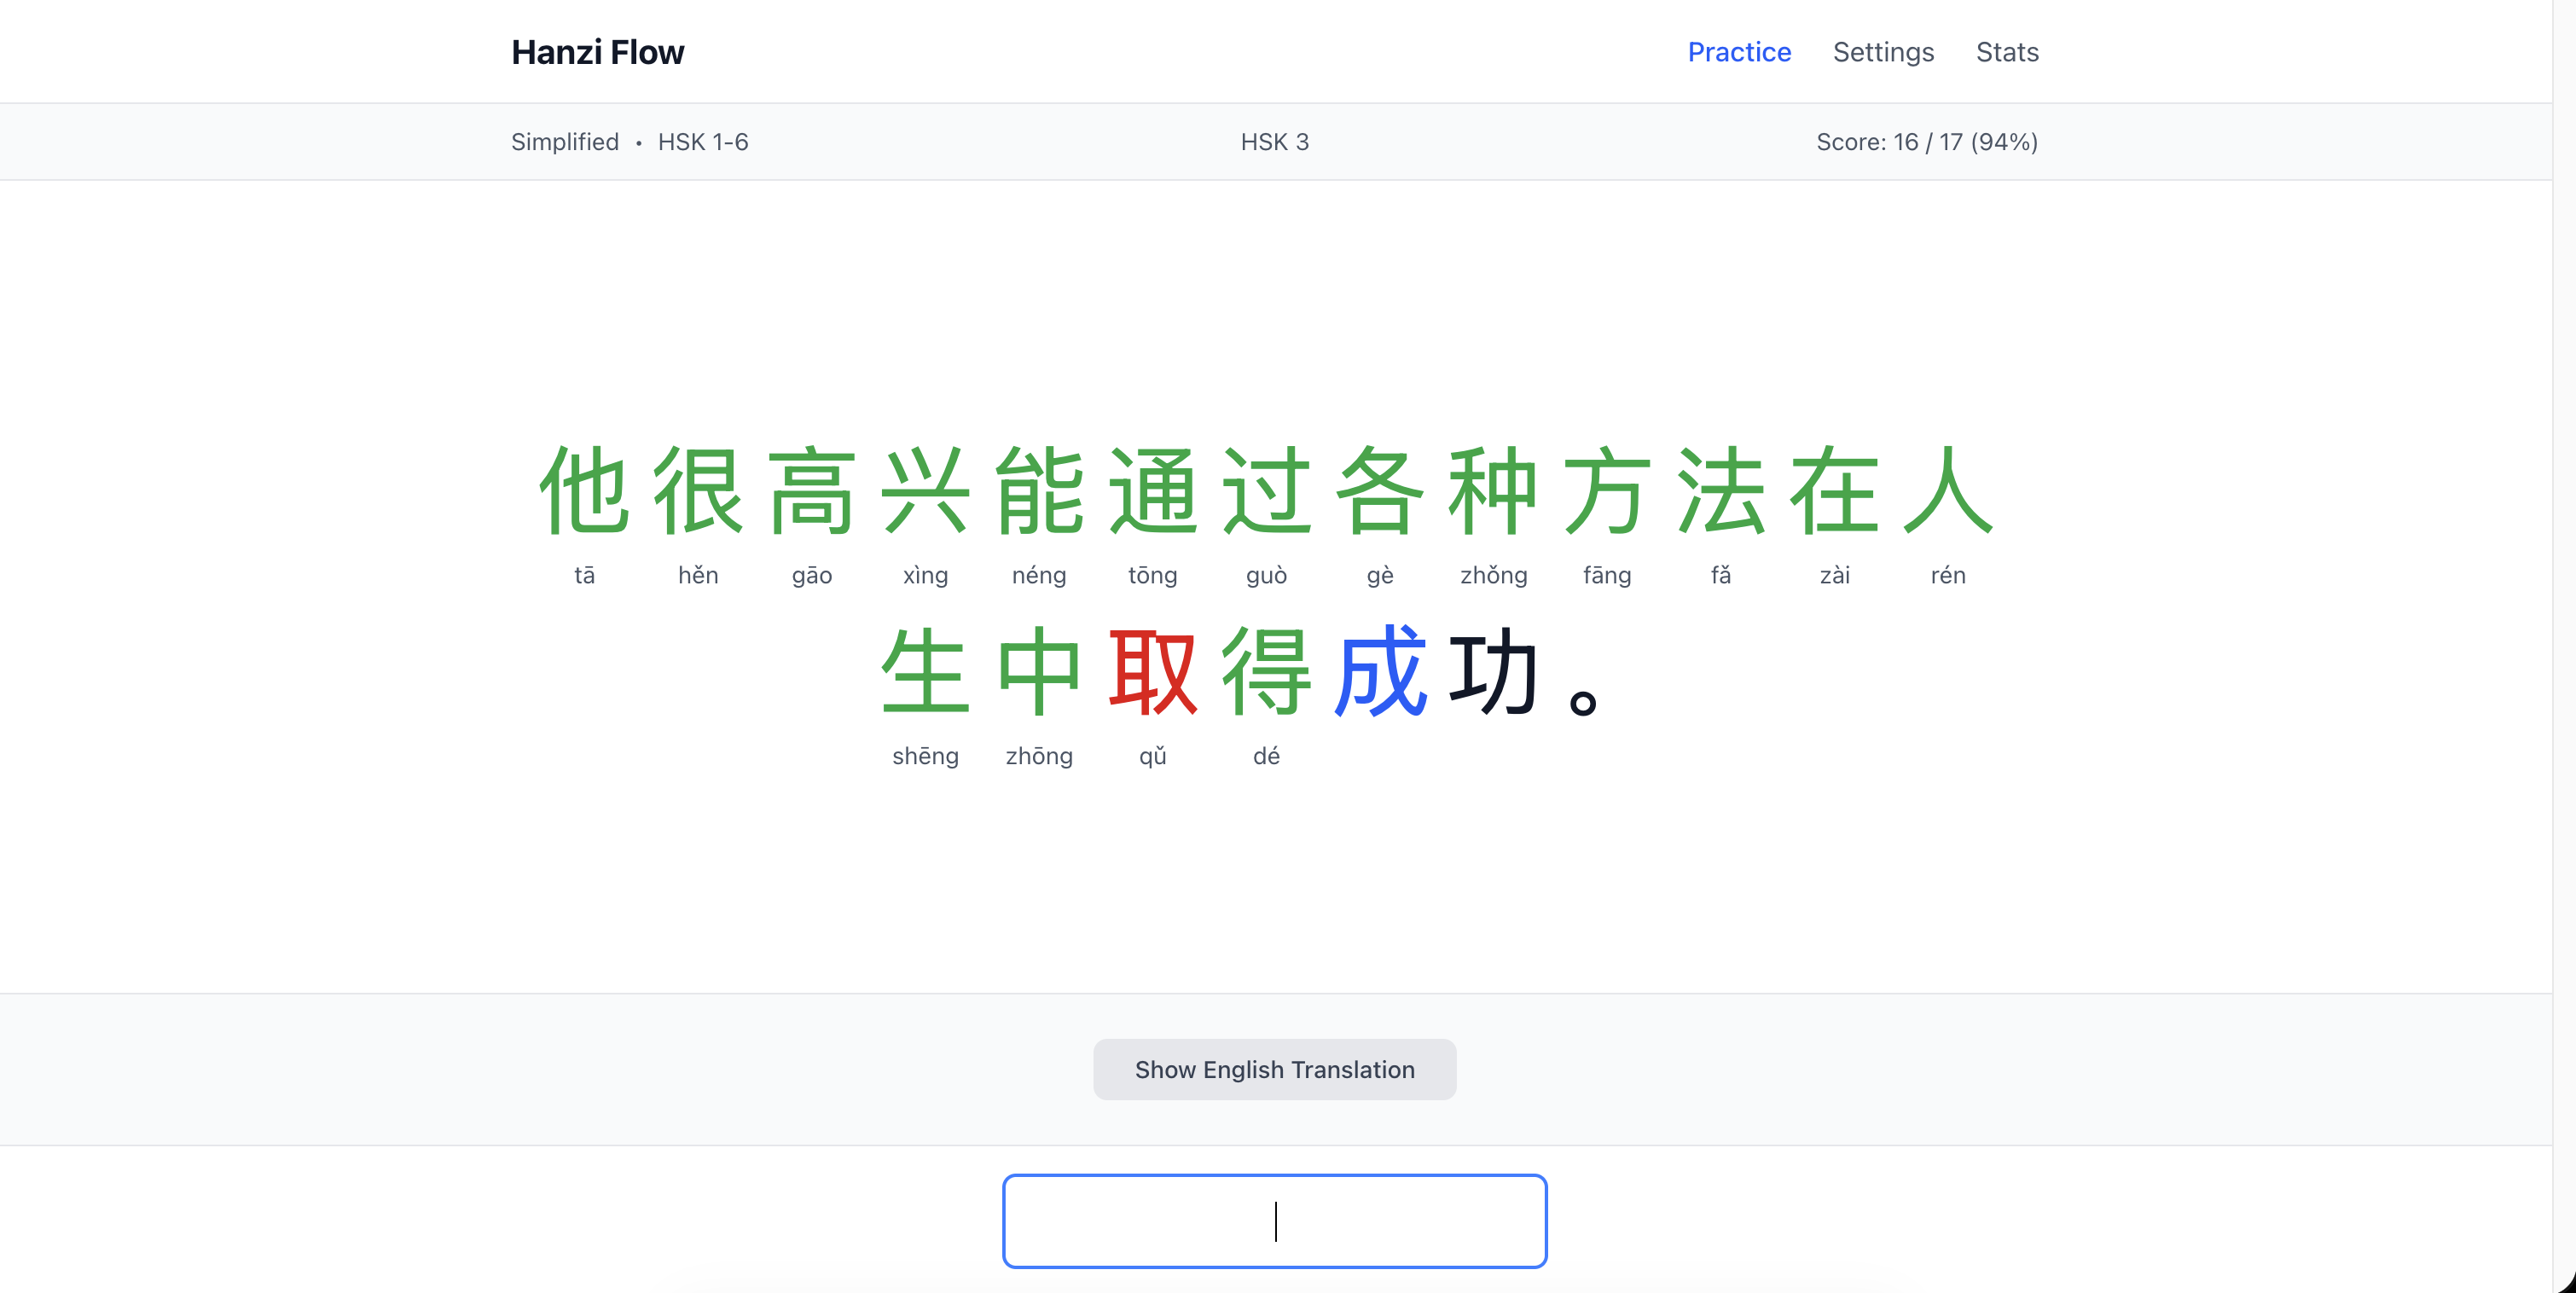
其中的机制在于反馈回路。现实生活里,你可能在书上看到一个字,猜错了,却永远不知道。或者看电视时完全漏掉了读音。这样的学习周期很慢。休闲学习者可能要花好几个月才能获得足够的接触量,把一个字真正学会。
这款应用压缩了这个周期。你看到一个字、输入它、立刻得到带音频的纠正、马上重试、然后继续。整个过程十秒。一次练习做 100 个字,你就跑了 100 个学习周期。主动回忆(输入)、即时纠正(音频加视觉)、高密度(句子源源不断)叠加在一起,产生的效果是被动接触无法给你的。
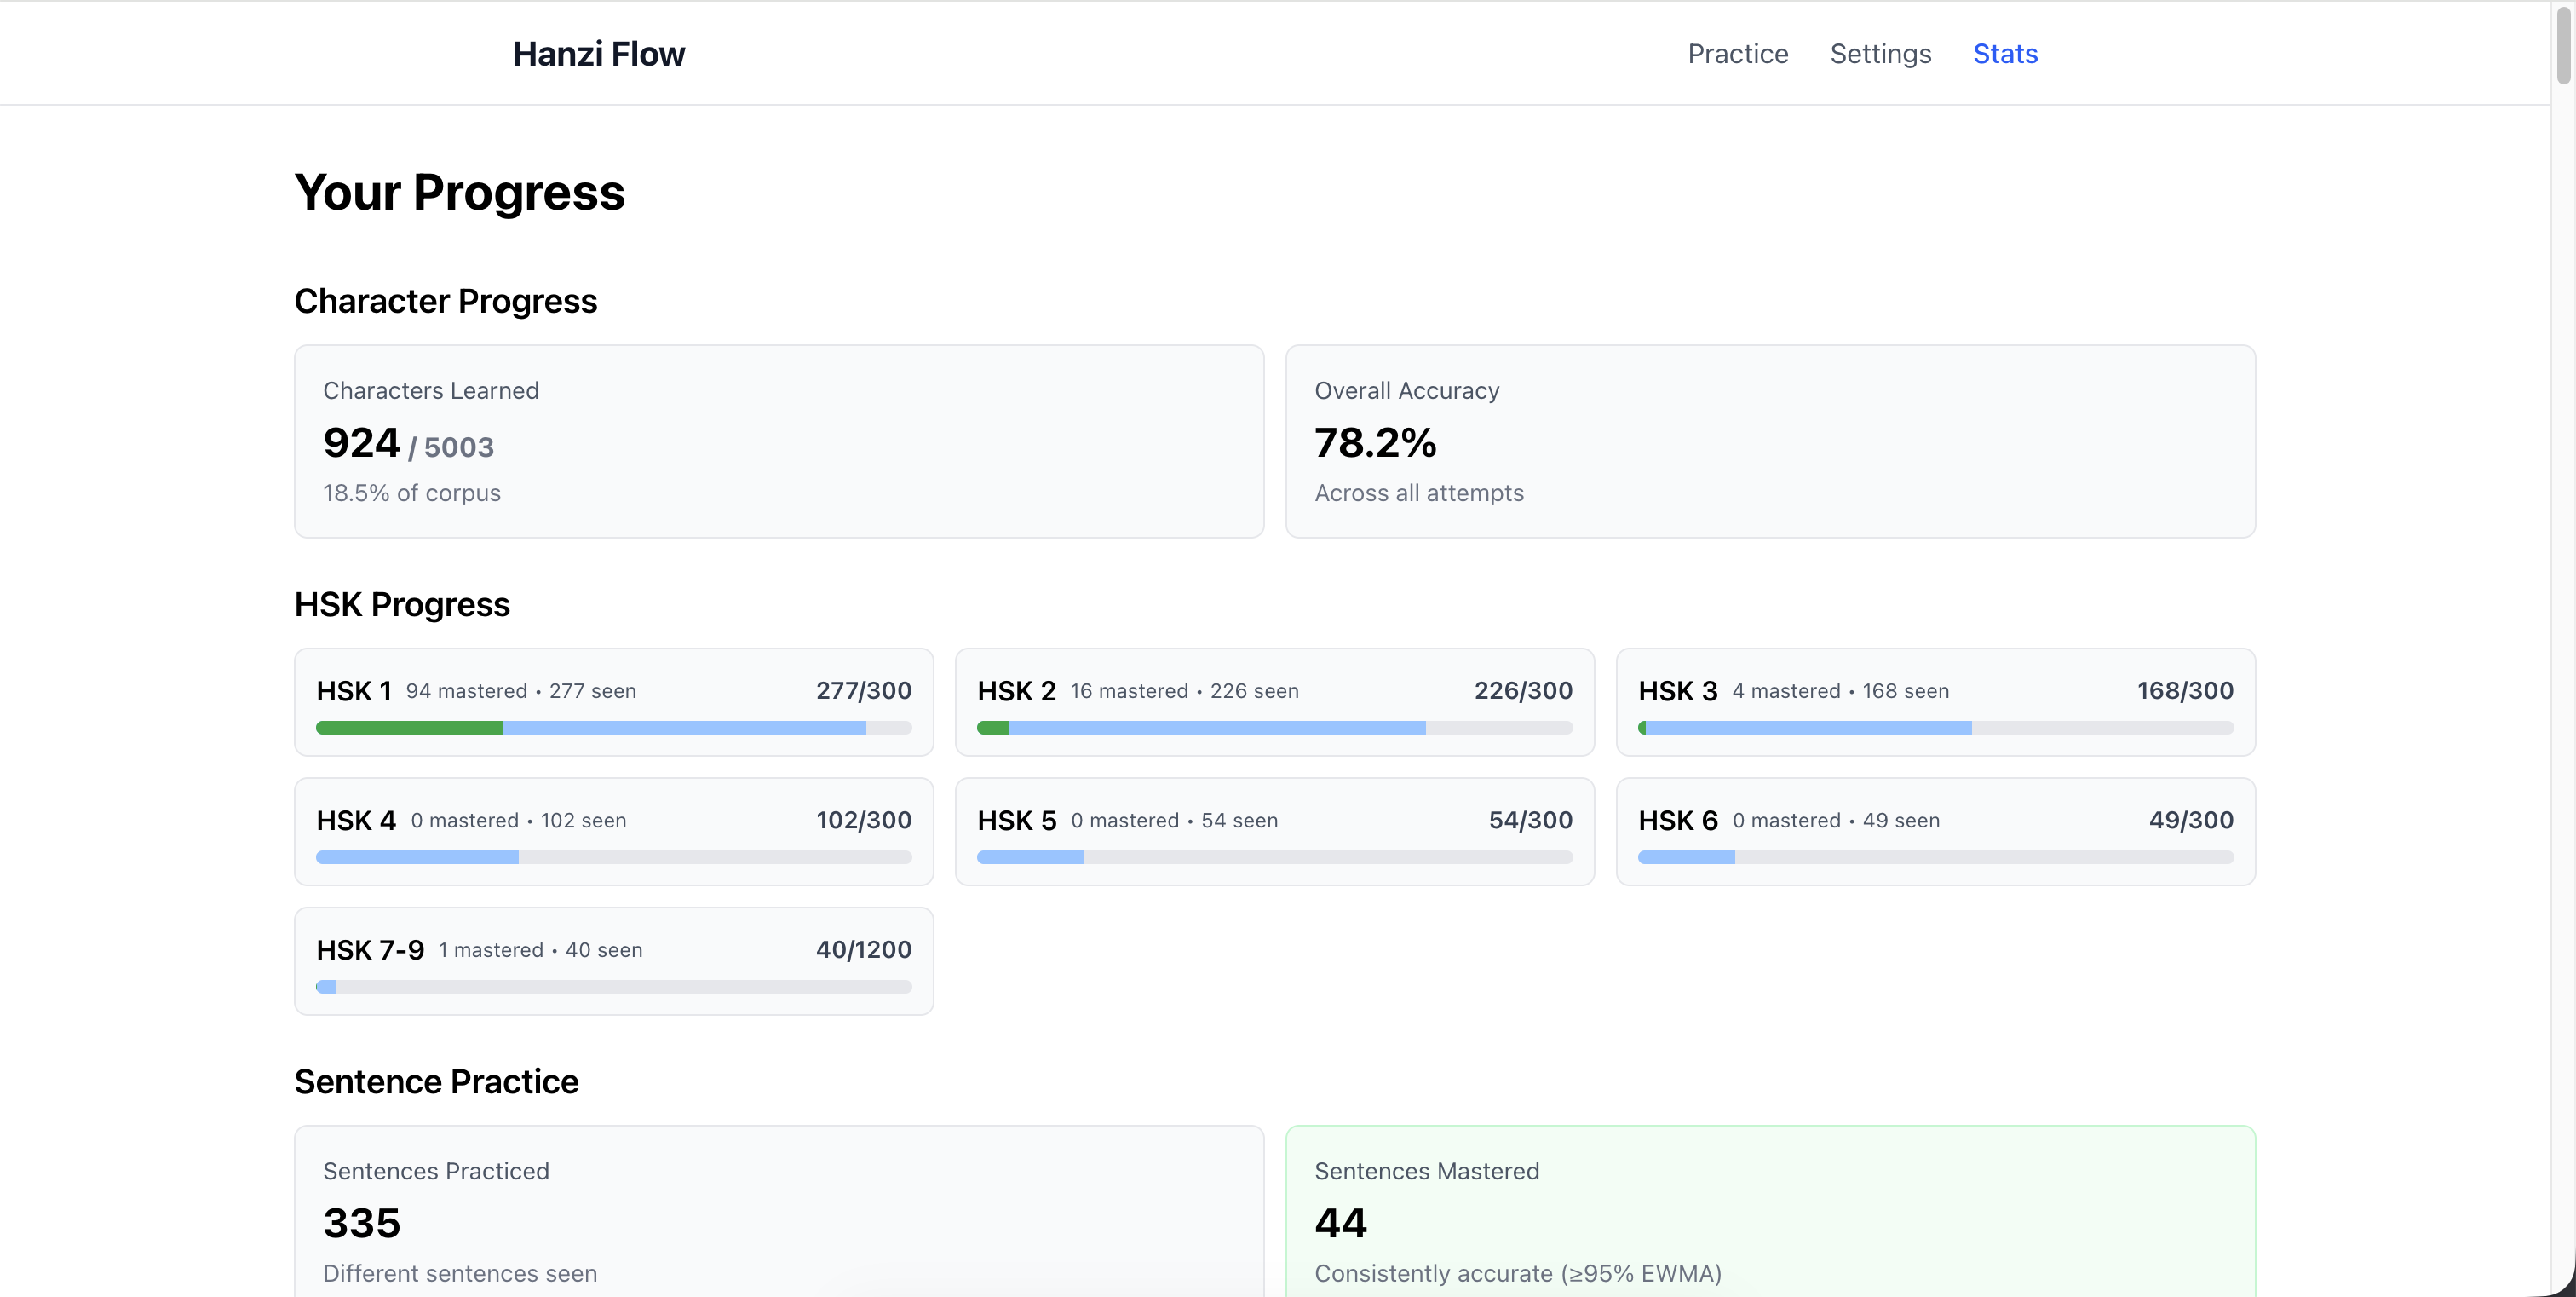
进度追踪
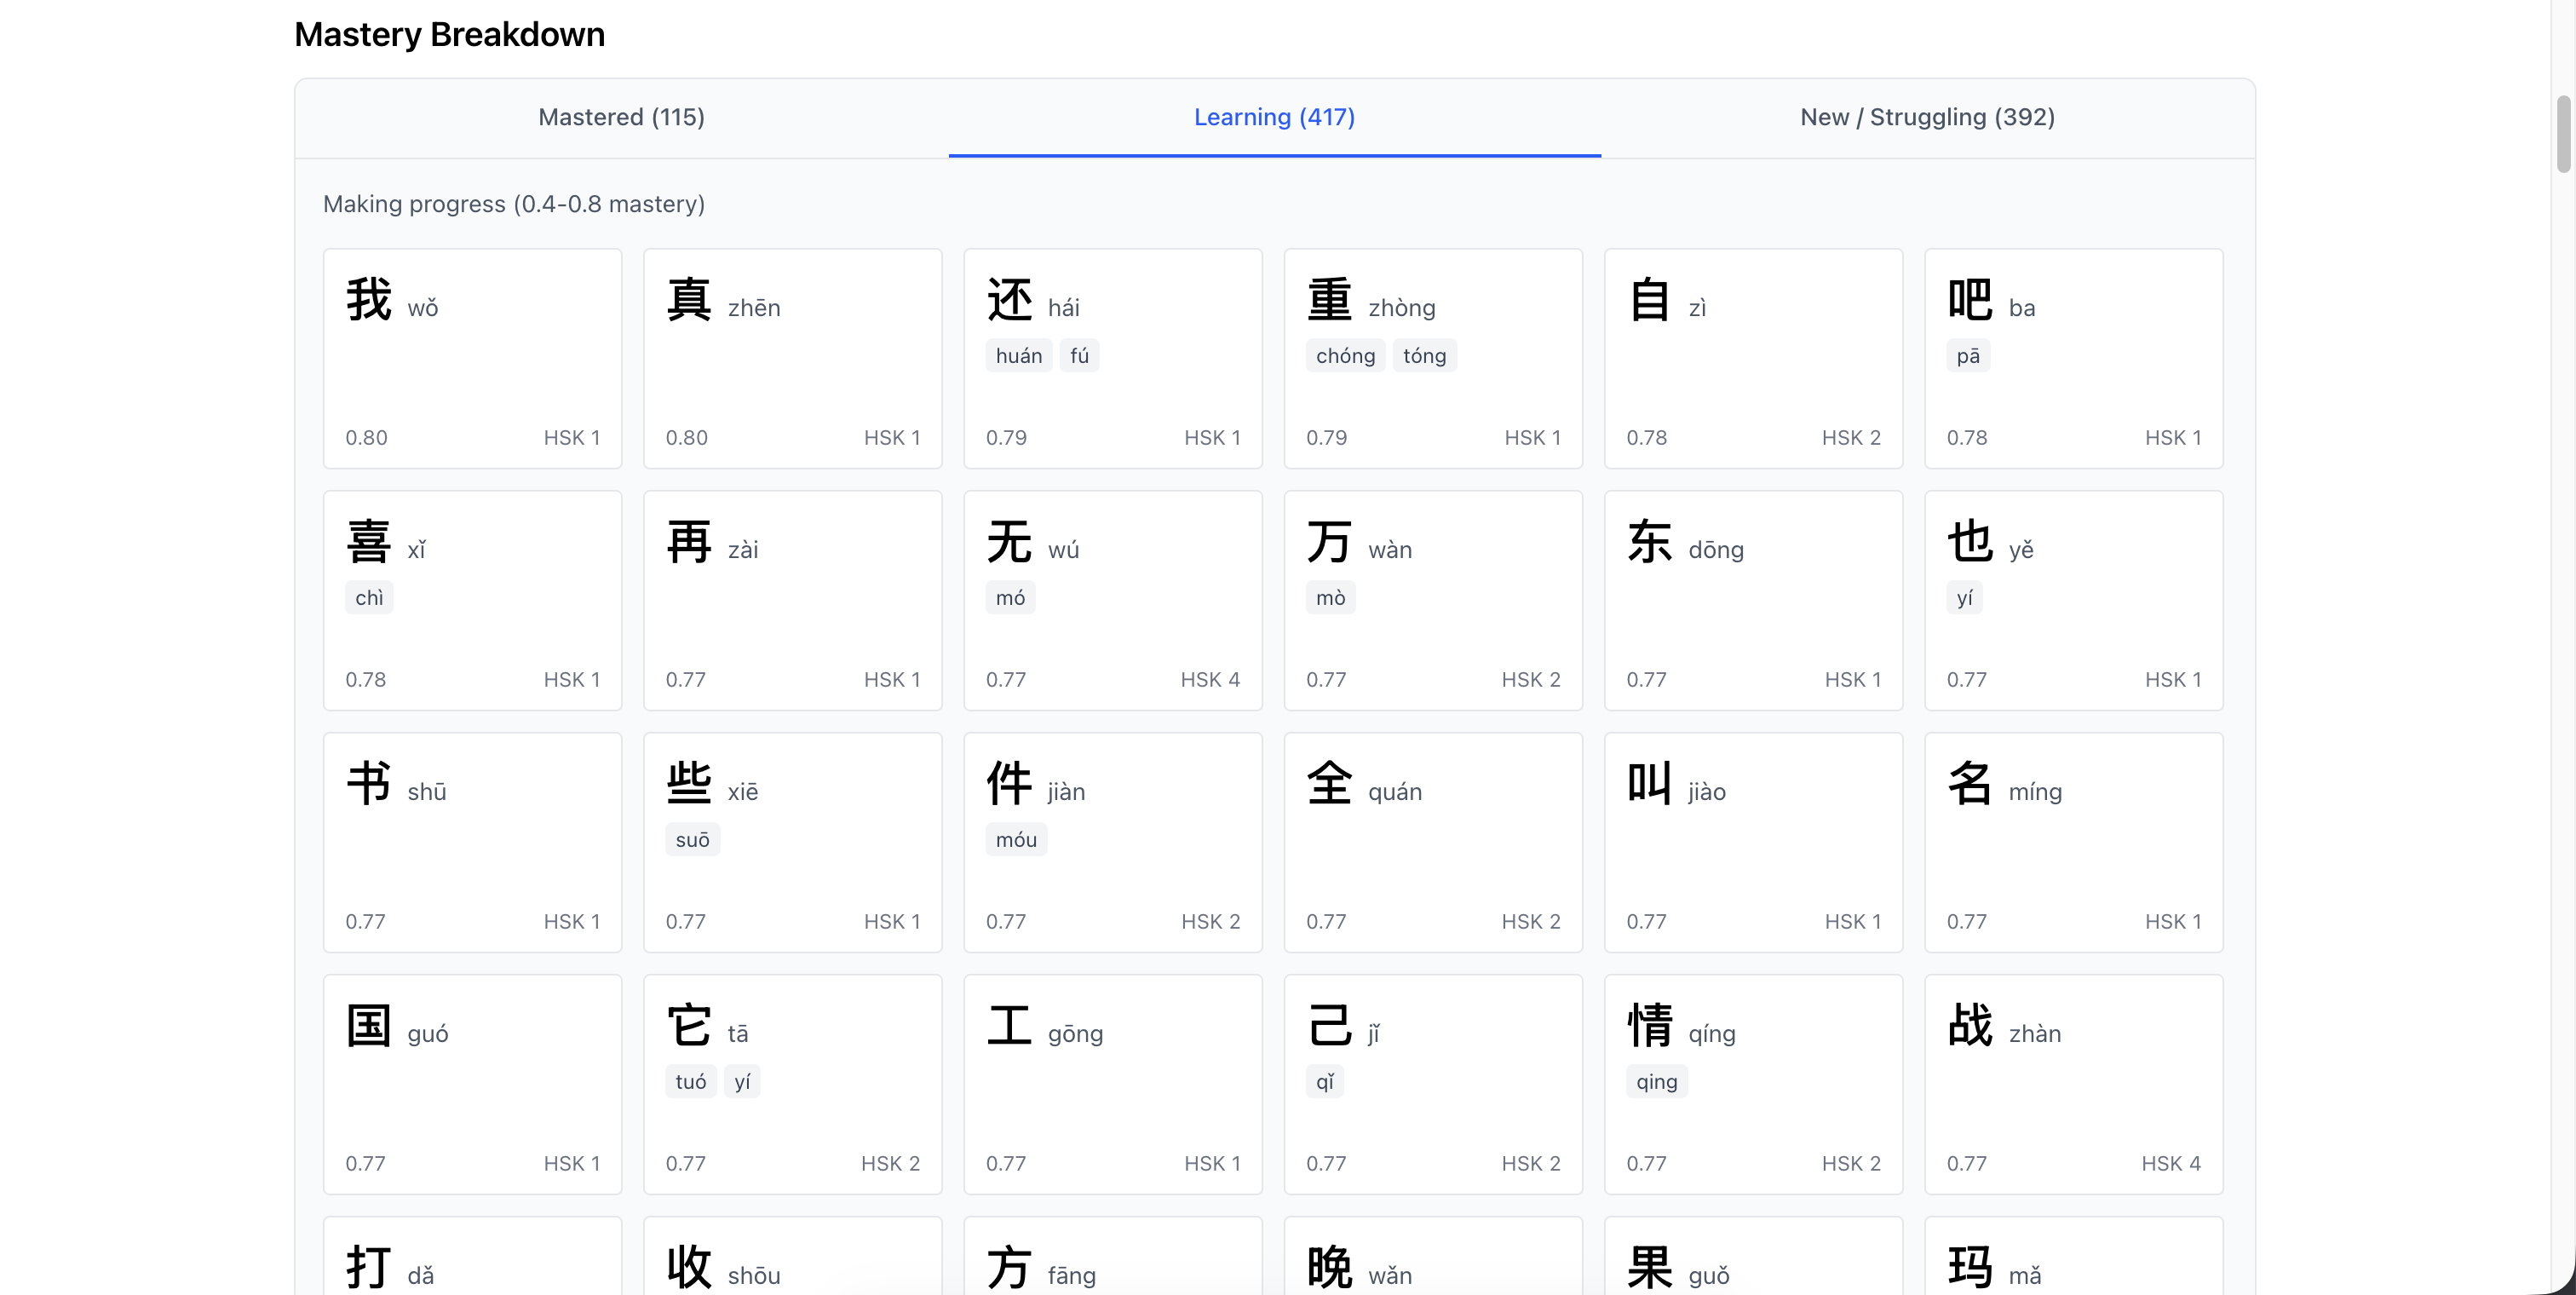
统计页面展示四个主要指标:
- 练习汉字总数 —— 你见过的不重复汉字
- 已掌握汉字 —— 掌握度 ≥ 0.8 的字
- 练习句子数 —— 完成的不重复句子
- 总体正确率 —— 首次尝试即正确的百分比
掌握度明细把汉字分成几组:
- 学习中(s < 0.6)—— 仍在建立熟悉度
- 较熟练(0.6 ≤ s < 0.8)—— 快了
- 已掌握(s ≥ 0.8)—— 稳了
每个字都会根据间隔重复记录它下次该复习的时间。
自适应算法(NSS)
随机挑选会很糟。你会太频繁地看到同样的句子,把时间浪费在已经掌握的内容上,或者被含 10 个以上生字的句子压垮。
下一句挑选(Next Sentence Selection,NSS) 就是挑选下一句的算法。它在新知识、间隔重复、新鲜度和难度之间取得平衡。
核心想法
最佳区间:每句 2 到 5 个生字。
- 0 到 1 个生字 —— 太简单,只算复习
- 2 到 5 个生字 —— 正合适,挑战够,语境也够
- 6 个及以上生字 —— 太难,你只能瞎猜
算法还会平衡:
- 新知识(你从未见过的字)
- 间隔重复(复习到期的字)
- 新鲜度(不要反复刷同样的句子)
- 多样性(混合不同难度)
工作原理
NSS 按批运行。你开始练习时,它会生成 10 个句子。当你做完 8 个时,它会在后台预取下一批。你永远不用等。
四个步骤:
1. 筛选符合条件的句子
从完整语料库(79K)开始。套用你的筛选条件:
- 字形(简体/繁体/混合)
- HSK 等级(你选定的范围)
- 冷却(排除最近 20 分钟内见过的句子)
这样得到候选池,通常是 20K 到 40K 条句子。
2. 随机抽取 300 个候选
从池中随机取 300 条。数量足够保证多样性,也足够小以便快速打分(100ms 以内)。随机抽样确保你每次练习看到的句子都不一样。
3. 给每个候选打分
对这 300 条中的每一条,按四个因素计算得分:
- 基础收益 —— 每个字的 (1 - 掌握度) 之和。掌握度低的字得分更高。若已过复习期,收益翻倍。
- 新鲜度 —— 根据距上次出现的时间给加分。鼓励多样性,避免反复刷同样内容。
- 通过惩罚 —— 如果你已经多次完美通过这句,就降低分数。避免过度练习。
- k 惩罚 —— 对生字数不在 2 到 5 区间内的句子扣分。强制控制难度。
把它们加起来:score = base_gain + novelty - pass_penalty - k_penalty
4. 取前 10 名,打乱,入队
按分数排序,取前 10 条,打乱顺序以混合难度。加入队列。
你练习这 10 条。剩下 2 条时,算法会在后台再跑一次,预取下一批。
掌握度追踪
每个字都有一个 掌握度分数(s),范围从 0.0 到 1.0。
- s = 0.3(新字的默认值)
- s → 1.0(持续答对)
- s → 0.0(一直答错)
更新使用 指数加权移动平均(EWMA),α=0.15。近期表现权重更大,但变化是渐进的。一次失误不会让你崩盘,一次成功也不会虚高。
当你答对一个字时,它的 稳定度(SRS 间隔)会乘以 1.2。起始为 1 小时。然后 1.2 小时。然后 1.44 小时。相比 Anki 激进的跳跃(1 天 → 3 天 → 7 天),这让汉字在轮转中停留更久。
为什么要更慢?当天复习很重要。你需要在一次练习中看到某个字 3 到 5 次,才能把它从短期记忆转入长期记忆。跳跃太快就会错过这个窗口。
当一个字到期(超过它的 next_review_ts)时,它在打分中权重加倍。算法会优先选含过期字的句子。这就是经典的间隔重复。
数据管线
做这件事需要全面的数据:带读音的汉字、带翻译的句子、难度标签、质量筛选。下面是我构建语料库的过程。
字符集
从 Unicode CJK 统一汉字区(U+4E00 到 U+9FFF)开始,共 20,992 个字。涵盖现代汉语中的每个字,加上生僻异体字和历史字形。
然后用三个来源的数据为每个字补充信息:
- Unihan 数据库 —— 拼音读音、异体字、部件拆分
- CC-CEDICT —— 英文释义和例词(学 → “study; learn”,学生 → “student”)
- OpenCC —— 简繁对应关系,用于字形分类
结果:99.7% 的字有拼音,67% 有英文释义,35% 有异体对应。我知道哪些字真正出现在 Tatoeba 中(5,000+),哪些只是理论上存在(生僻的文言用字)。
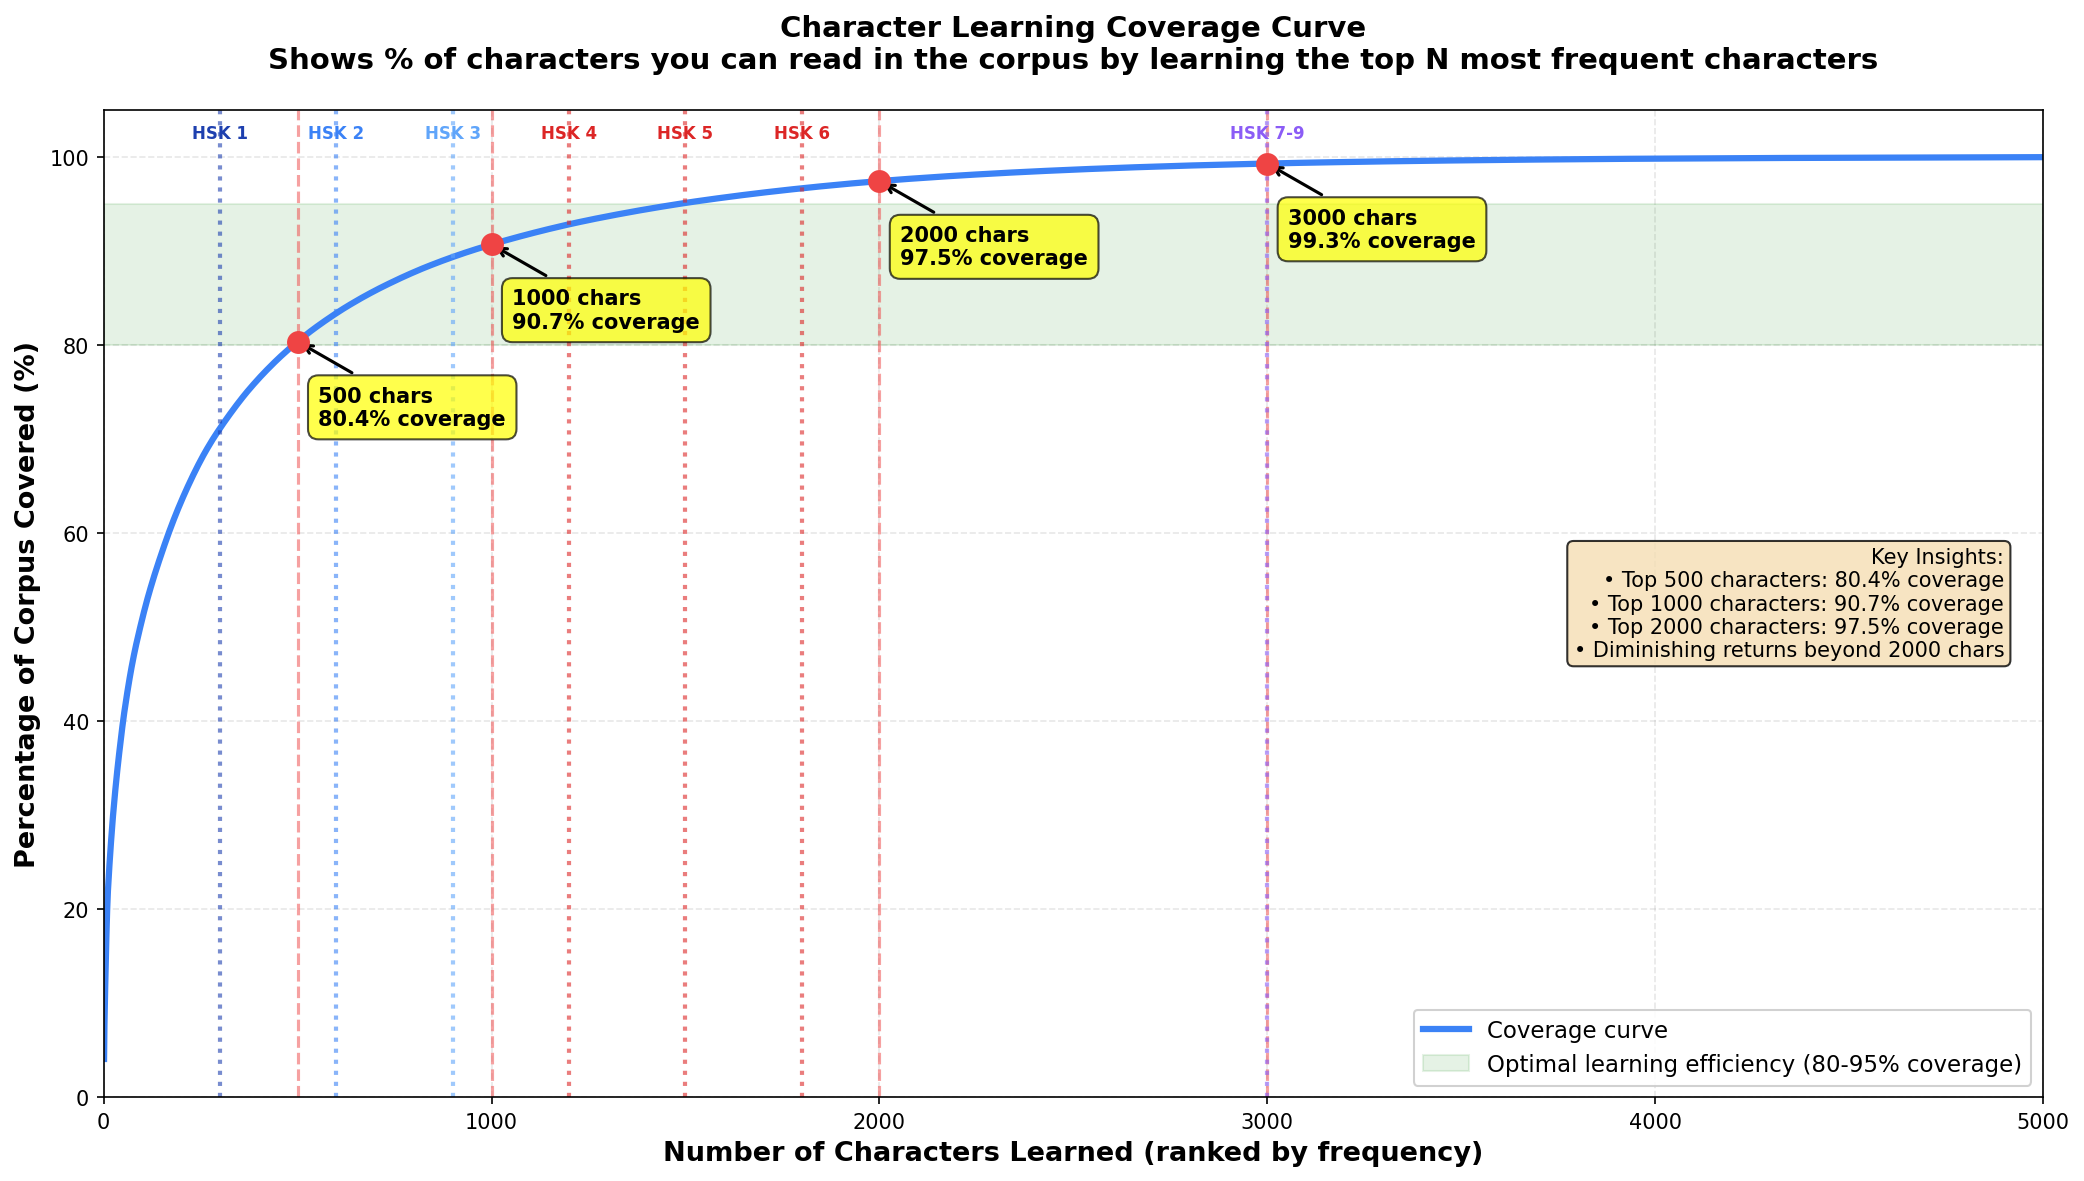
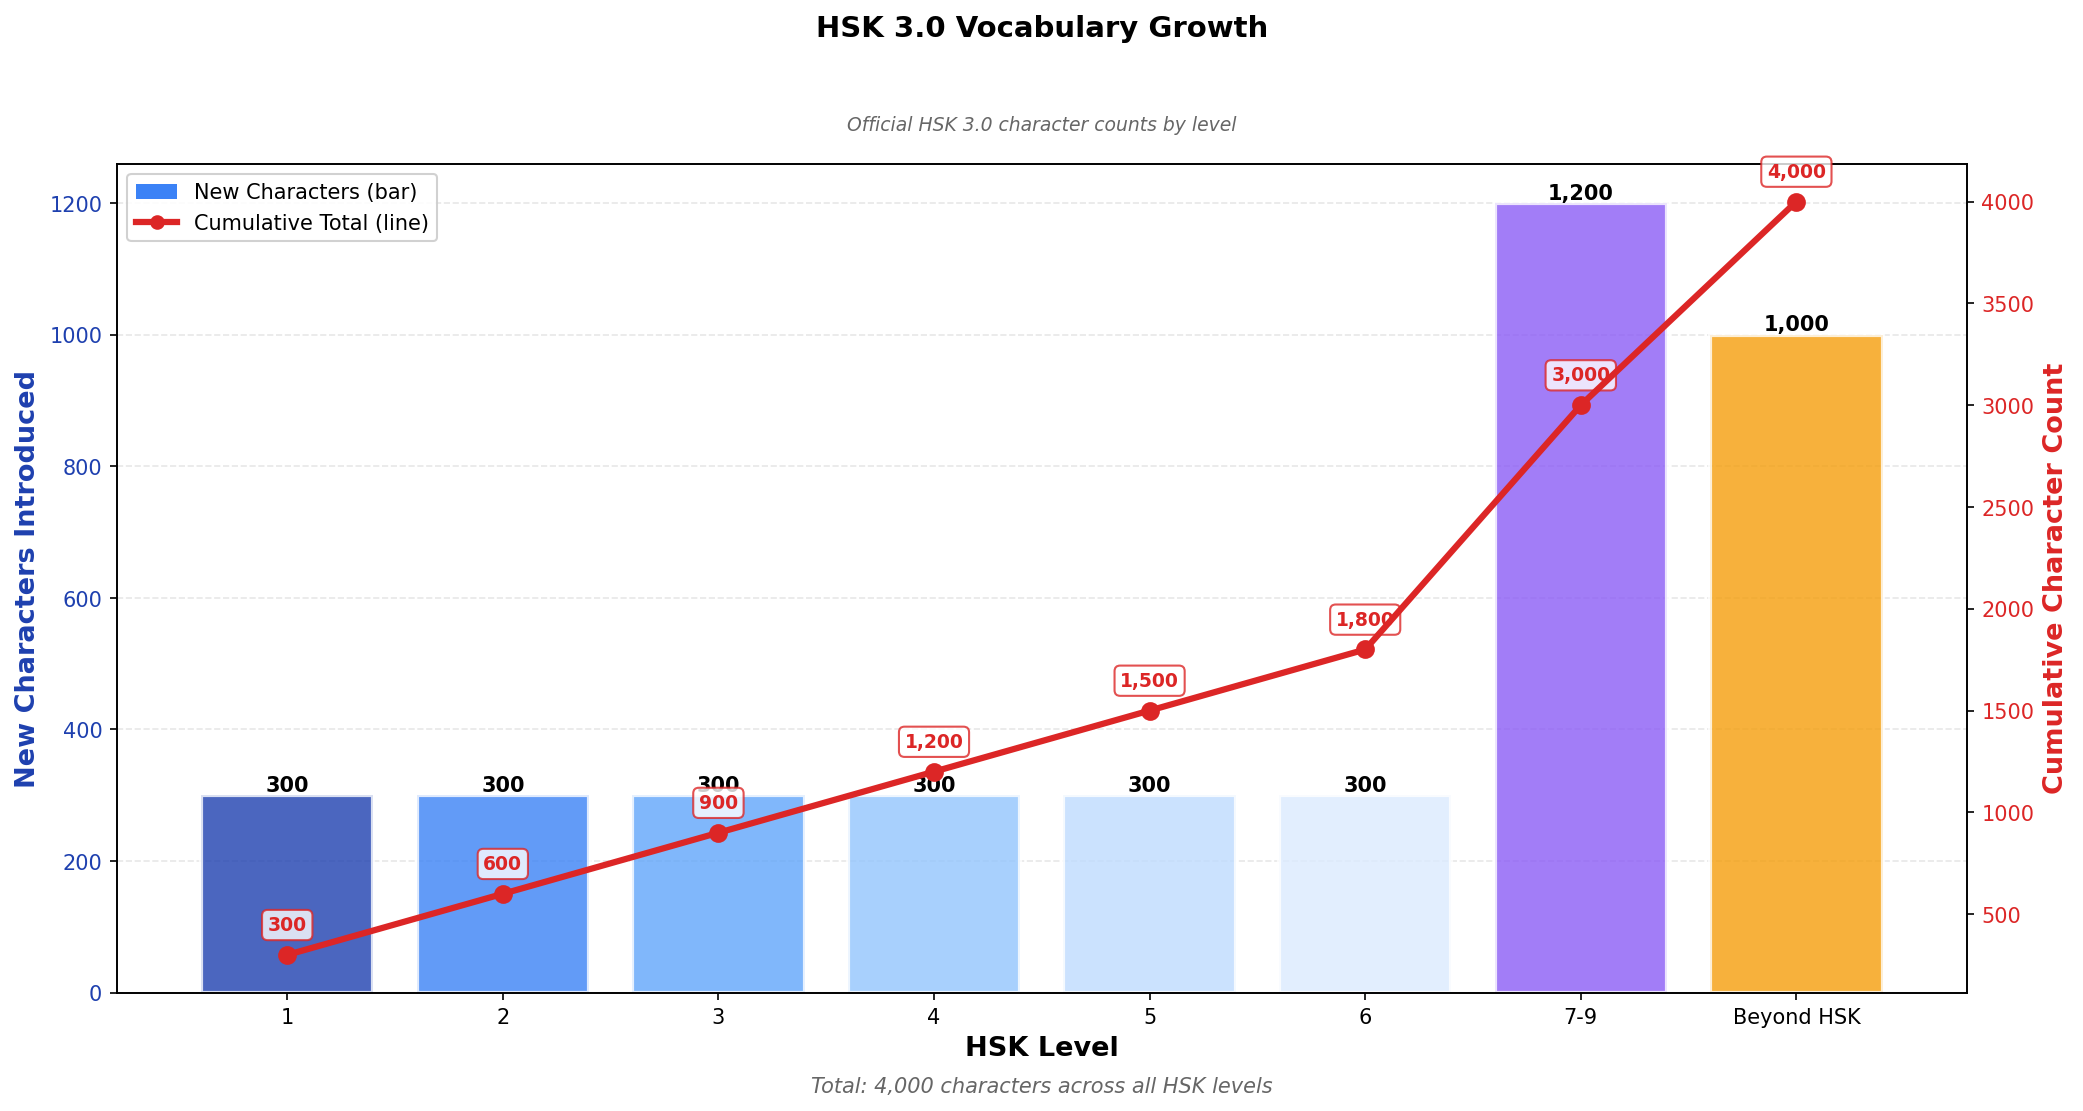
曲线显示了汉字如何在各 HSK 等级上累积。HSK 1 有约 300 字,HSK 2 又加 300,以此类推。在接近约 3,000 字的识字门槛时,高等级的曲线趋于平缓。超过这个数,收益递减。
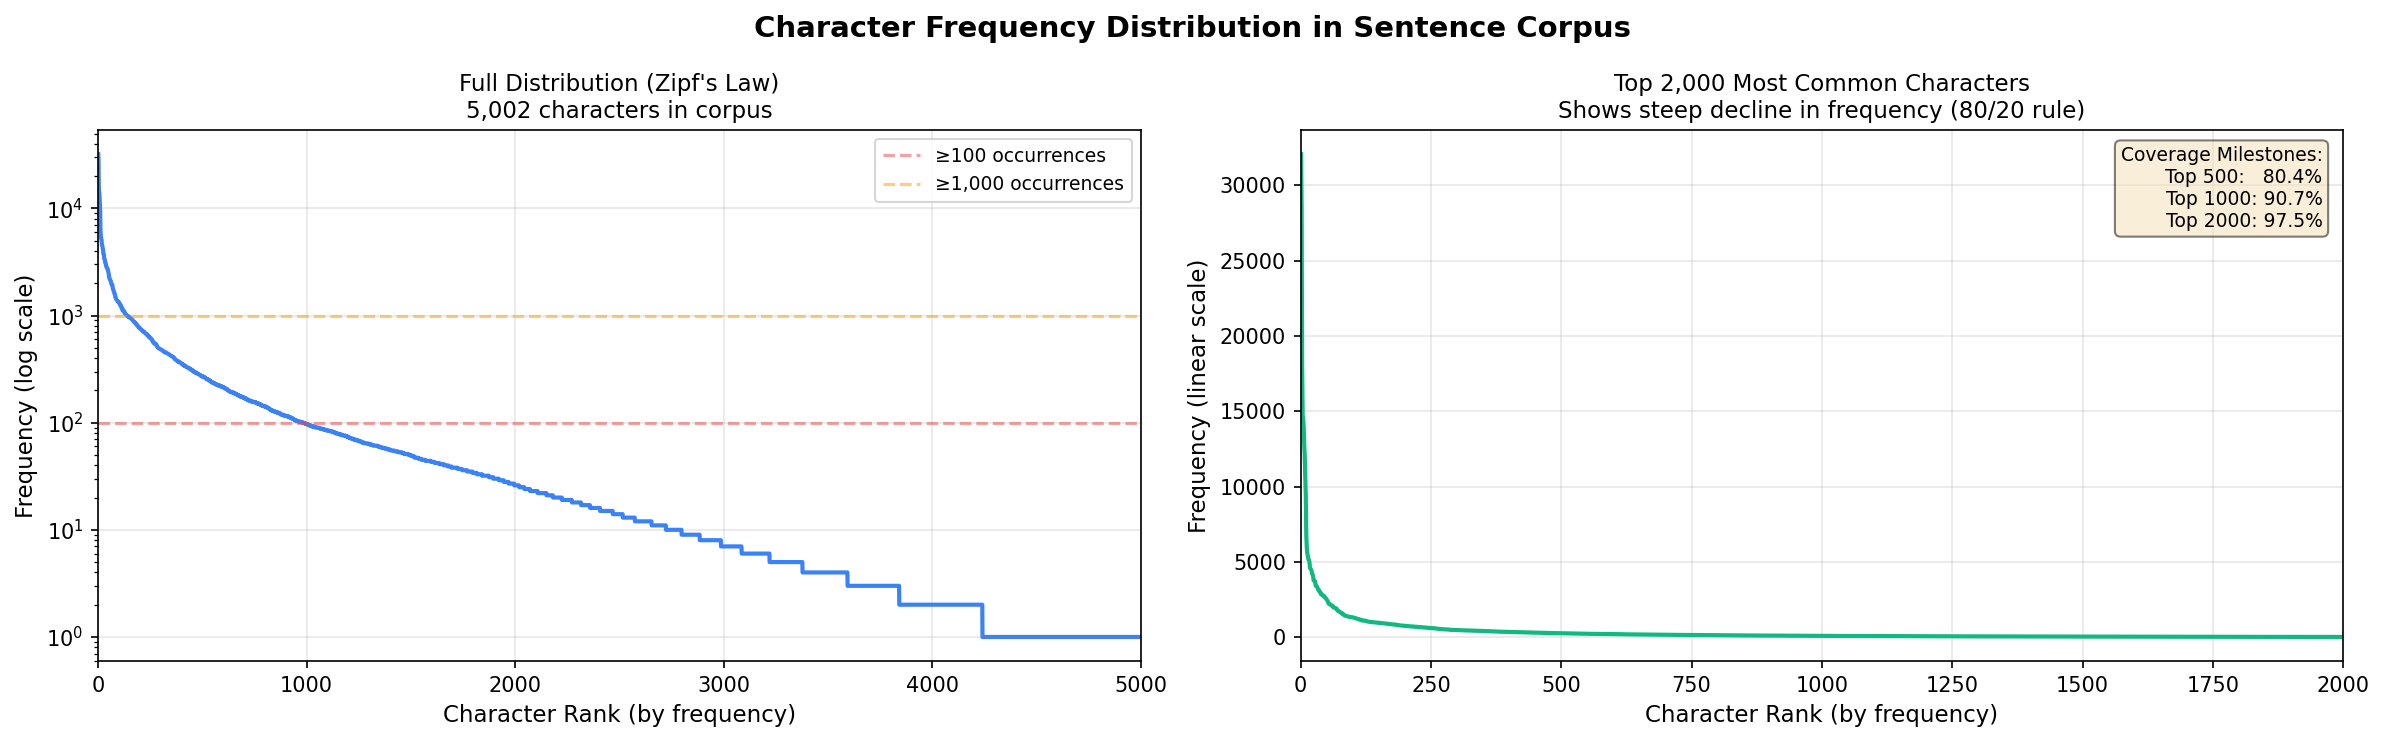
频率分布符合齐夫定律:少数汉字占据主导,大多数很罕见。前 500 个字覆盖 75% 的文本。前 2,000 个覆盖 95%。这对自适应算法很重要,因为先学高频内容能立刻带来阅读能力。
HSK 分级
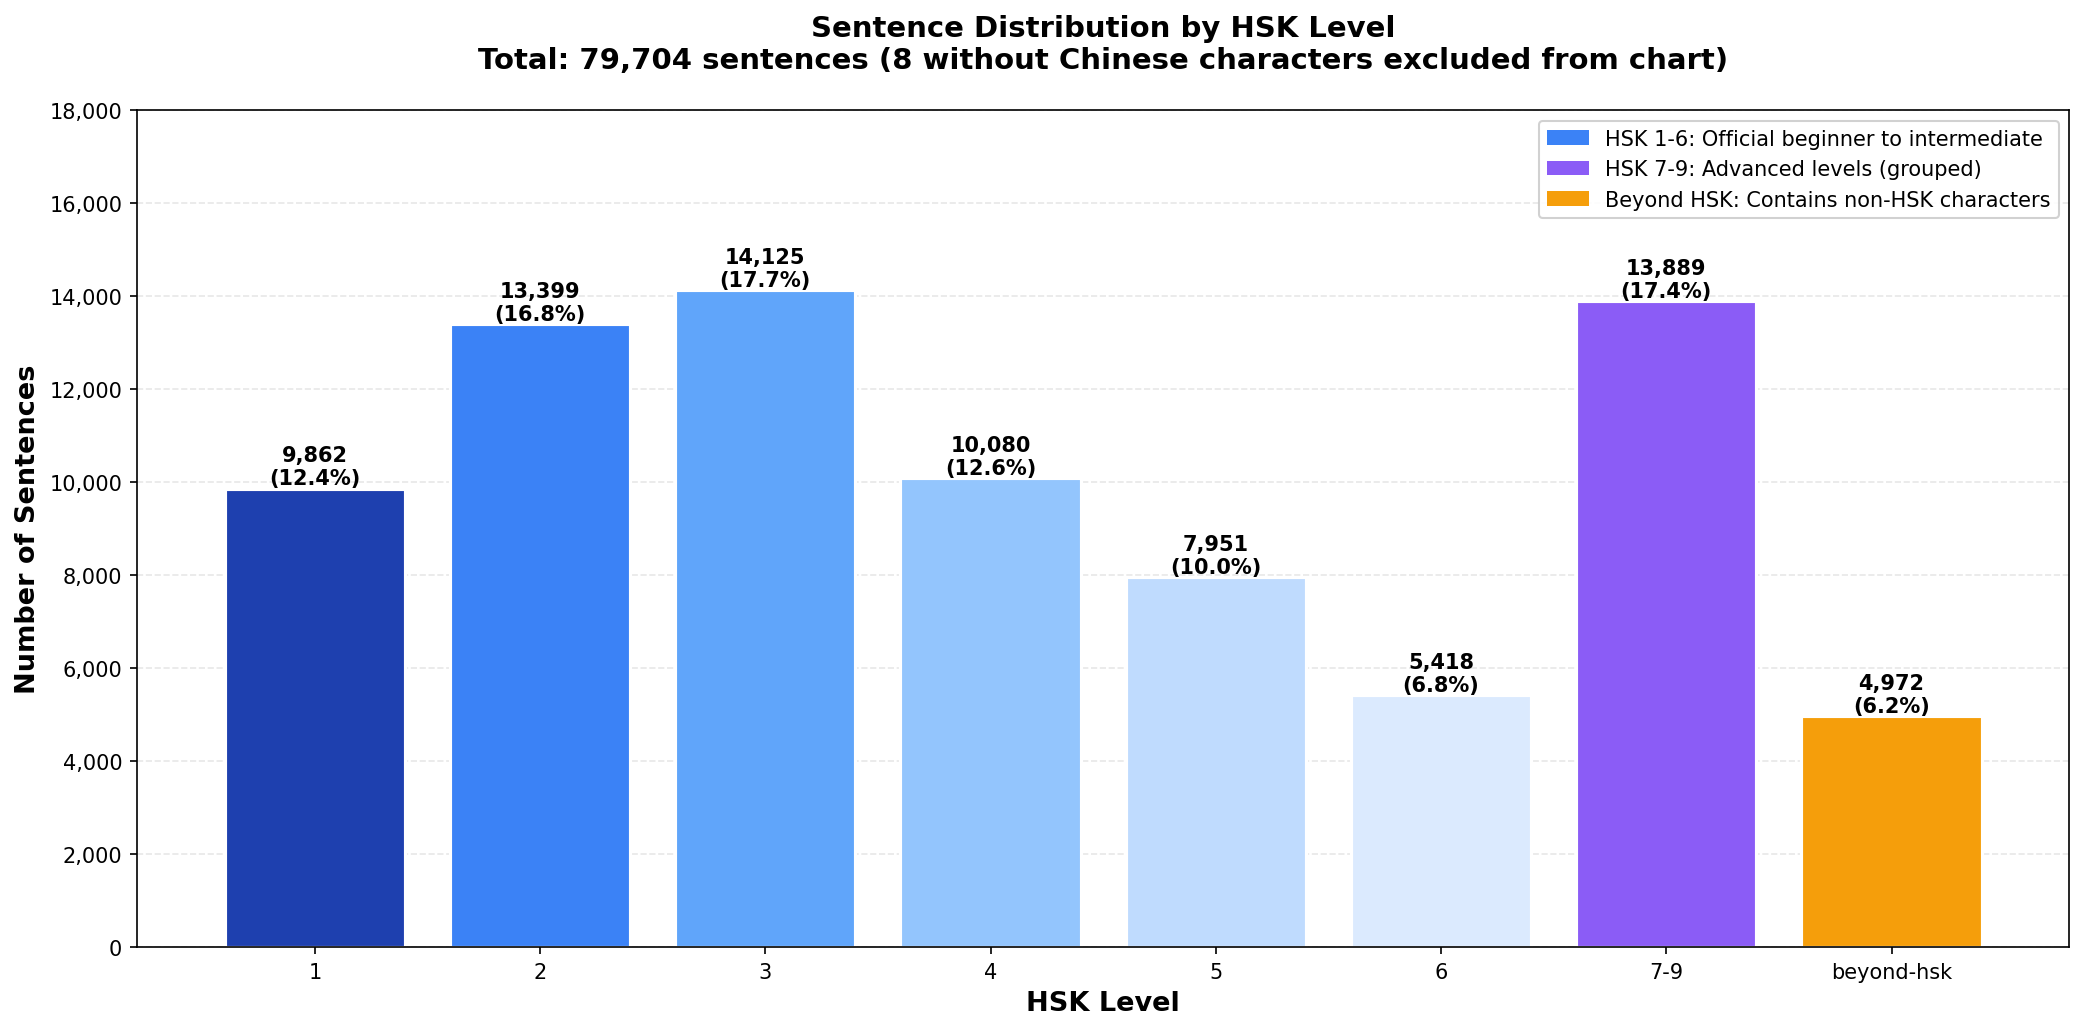
HSK(汉语水平考试)是中国的官方水平测试。2021 年修订版(HSK 3.0)定义了 9 个等级,共 3,000 个汉字。我整合了来自 elkmovie/hsk30 的官方字表(从政府 PDF 经 OCR 得来)。
每个句子按其中最难的字来分级:
- 全是 HSK 1 的字?标为「1」
- 最难的字是 HSK 3?标为「3」
- 含 HSK 9 之外的字?标为「beyond-hsk」
这驱动了筛选功能。当你选择「HSK 3」时,你只会看到每个字都属于 1 到 3 级的句子。不会有意外。
句子处理
从 Tatoeba(一个众包翻译数据库)抓取了 79,000+ 条中文句子。每条一边是英文,一边是中文。
难点:语境敏感的拼音。 汉字会因语境而有多个读音。我先用 jieba + pypinyin 跑了第一遍,然后用 GPT-4o-mini 校验(79K 条句子约花 2 美元)。修正了 10,336 处错误,涉及常见多音字,比如 地(de 还是 di4)、著(zhe 还是 zhu4)、谁(shei2 还是 shui2)。
多音字示例:
- 了:
le(助词)还是liao3(完结) - 行:
xing2(可以)还是hang2(行列) - 长:
zhang3(生长)还是chang2(长)
你不能只靠查表。你需要理解词语的语境。
第一步:jieba + pypinyin。 jieba 把「我们试试看」切分为 [“我们”, “试试”, “看”],然后 pypinyin 为每个词生成拼音:我们试试看 → wo3 men shi4 shi4 kan4。多数情况可行,但在助词和口语读音上会出错。
第二步:GPT-4o-mini 校验。 把完整语料库跑过 OpenAI 的 API(79K 条句子约 2 美元,每次调用打包 10 条)。要求逐字输出带声调的拼音。在 79,603 条句子中发现 10,336 处错误。主要修正:
- 覺(120 处改动):pypinyin 给出
jue2(感觉),OpenAI 给出jiao4(睡觉)- 你應該去睡覺了吧 —— 「你该去睡觉了」
- 著(696 处改动):pypinyin 给出
zhu4(穿著),OpenAI 给出zhe(助词)- 生活就是當你忙著進行你的計劃時… —— 「生活就是当你忙着推进自己的计划时发生的事」
- 谁(404 处改动):pypinyin 给出
shui2(书面),OpenAI 给出shei2(口语)- 你知不知道他们是谁? —— 「你知道他们是谁吗?」
- 长(136 处改动):pypinyin 给出
zhang3(生长),OpenAI 给出chang2(长)- 我看见一个长头发的女生 —— 「我看见一个长头发的女生」
我手工复核了排在前面的那些字,并应用了高置信度的修正。OpenAI 的语境理解捕捉到了基于规则的方法漏掉的错误。
英文翻译: 同样用 GPT-4o-mini 生成(总共约 1 美元)。Tatoeba 的数据集只有约 2,000 条句子带翻译。用那些的话,语料库会从 79,000+ 缩水到 2,000,自适应算法的效果就毁了。所以我用 GPT-4o-mini 翻译了全部 79,000+ 条句子。大语言模型擅长翻译,因为它们会利用语境,而这正是准确中译英所需要的。示例:
- 我們試試看! → Let’s give it a try!
- 你在干什麼啊? → What are you doing?
- 今天是6月18号,也是Muiriel的生日! → Today is June 18th, and it’s Muiriel’s birthday!
- 生日快乐,Muiriel! → Happy birthday, Muiriel!
- 密码是”Muiriel”。 → The password is “Muiriel.”
还套用了质量筛选:
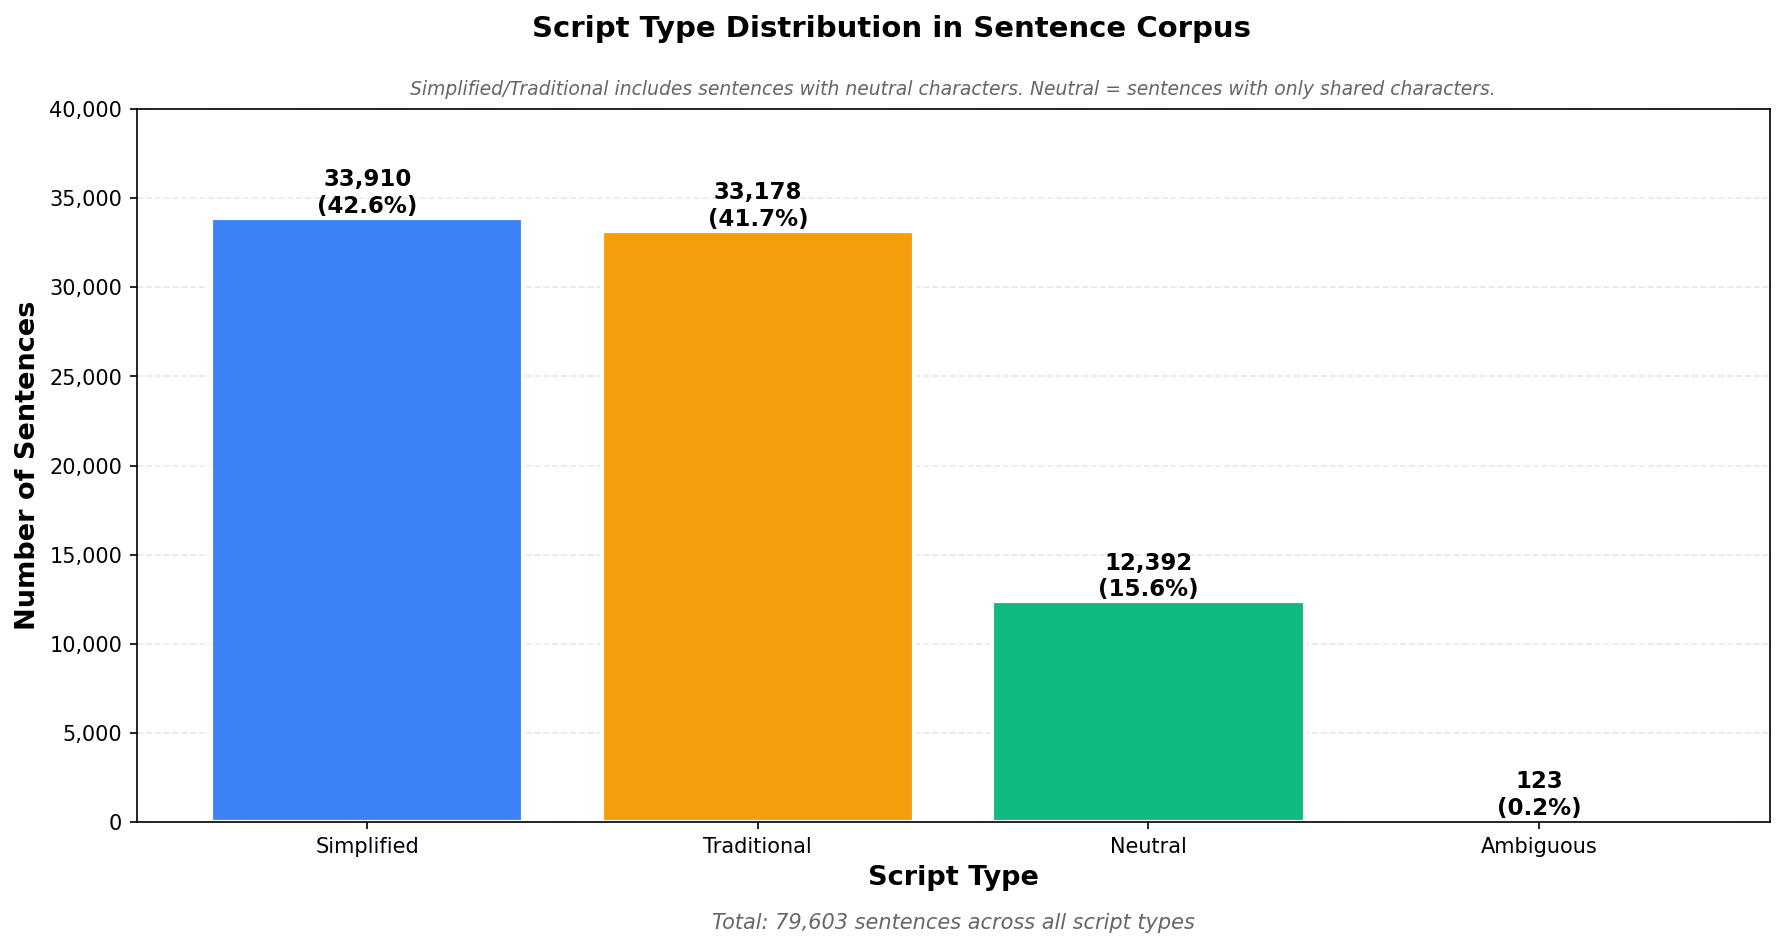
- 字形分类 —— 简体、繁体、中性或混合
- 脏话剔除 —— 过滤粗俗词语(约 10 条句子)
- 长度上限 —— 移除超过 50 字的句子(约 270 条),避免出现滚动
- 元句子 —— 移除 Tatoeba 自我指涉的句子(约 80 条)
最终语料库:79,333 条干净句子。
架构与性能
使用现代网页技术构建,针对速度和隐私做了优化。
为什么本地优先?
- 隐私 —— 无账号、无追踪、无遥测。你的进度从不离开你的设备。我甚至没有做分析统计。数据归你所有。
- 性能 —— 没有网络延迟。句子挑选在 100ms 以内完成。输入反馈是即时的。统计页加载在 50ms 以内。
- 简单 —— 没有后端要维护,没有数据库要扩容,没有鉴权。应用就是静态文件加客户端 JS。我免费托管在 Vercel 上。
- 代价: 没有跨设备同步。在笔记本和手机上的练习是各自独立的。对 MVP 来说可以接受。大多数人只有一台主设备。以后可以加导出/导入或可选的云同步。
技术栈
前端:
- Next.js 15,使用 App Router
- React 19 + TypeScript
- Tailwind CSS
- Dexie.js 用于 IndexedDB
数据管线:
- Python 3.9+ 用于处理脚本
- jieba 用于分词
- pypinyin 用于语境敏感的拼音
- pandas + matplotlib 用于分析
- GPT-4o-mini 用于翻译和拼音校验
音频:
- AWS Polly(Zhiyu 语音)做 TTS
- 1,598 个音节,覆盖全部声调
- OGG 格式,兼容网页浏览器
部署:
- Vercel(零配置)
- 静态站点,无服务器
- 全球 CDN
数据加载与缓存
应用在首次访问时加载大体积数据集,之后积极缓存。
首次加载:
- 79,333 条句子(约 41MB JSON)—— 只取一次,存在内存中
- 汉字映射 CSV(约 2MB)—— ID、拼音、释义
- 音频文件 —— 按需获取(每个 1 到 2KB)
内存缓存:
- 句子存在一个 JavaScript 数组中
- 汉字到 ID 的映射存在一个 Map 中(O(1) 查找)
- 会话期间不重复获取
IndexedDB 持久化:
- WordMastery 表 —— 每个练习过的字一行(掌握度分数、SRS 间隔、下次复习时间、计数)
- SentenceProgress 表 —— 每个完成的句子一行(通过率、尝试次数、上次出现时间)
- SentenceQueue 表 —— 存放接下来的 10 个句子(更改偏好时重新生成)
所有数据都留在你的设备上。除首次加载外没有任何网络请求。
性能技巧:
- 音频预加载 —— NSS 选好下一句时,会在后台预加载它的拼音音频(3 到 5 个文件,不到 10KB)。等你看到它时,音频已缓存好了。
- 队列预取 —— 当你做完 10 句中的 8 句,NSS 会在后台运行以生成下一批。你永远不用等。
- 懒加载 —— 统计页只在你访问时才计算分布,而不是每次操作都算。
离线: 首次加载之后,完全可以离线使用。在飞机上、地铁里、任何地方都能练。进度会立即保存到 IndexedDB(不需要保存按钮)。
关键设计决策
数字声调还是声调符号
应用接受数字声调(wo3、shi4)而不是符号(wǒ、shì)。为什么?
- 更容易输入(不需要特殊键盘)
- 是中文输入法的标准做法(为真实打字做准备)
- 无歧义(
v和ü等价,声调符号需要 Unicode 组合字符) - 迫使你明确思考声调(
wo3= 第三声),而非视觉性死记
以句子为单位的学习
为什么用句子而不是孤立的词?
- 语境 —— 在真实用法中学汉字。「我们试试看」不仅教你 我们(we)、试试(try)、看(look),还 教你语法结构。
- 阅读练习 —— 模拟真实阅读。培养解析汉字序列的能力。
- 输入流利度 —— 训练完整句子的肌肉记忆,就像你实际会用到的那样。
- 难度校准 —— 句子天然带有难度分布(生字数量)。词级别做不到这一点。
- 动力 —— 完成一个句子让人感觉有进展。你在读真正的中文,而不是刷「的 的 的」这样的闪卡。
接下来
就日常练习而言,应用的功能已经完备。如果我回头继续做,可能会加上:
- 移动端 PWA(做成可安装)
- HSK 统计明细
- 复习模式(以 SRS 为核心的练习)
- 整句音频(完整读音,而非仅单字)
- 汉字卡片(字源、笔顺、构词)
- 声调分析(追踪你容易混淆哪些声调)
- 自定义语料(导入你自己的句子)
- 导出/导入(跨设备可携带)
这是开源项目。有想法?提 issue 或 PR。
结语
做这个是为了解决我自己的痒处。我想练中文阅读,又不想承担闪卡的额外开销。真实句子、自适应难度、干净的输入界面。
结果变成了对数据管线(79K+ 条带语境敏感拼音的句子)、自适应算法(EWMA + SRS)和本地优先架构(IndexedDB + 缓存)的一次深入钻研。我学到了很多关于多音字、齐夫定律,以及如何为当天复习调校间隔重复的知识。
如果你在学中文,试试看。如果你是开发者,去看看仓库。句子挑选算法、数据处理和本地优先思路里都有有意思的东西。
感谢:Tatoeba 提供句子,MDBG 提供 CC-CEDICT,elkmovie 提供 HSK 3.0 字表,Unicode 联盟提供 Unihan。
自己试试
访问 hanzi.brianhliou.com 即可开始。
- 选择你的字形和 HSK 等级
- 用数字声调输入拼音(
wo3、ni3、ta1) - 到统计页查看进度
- 每天练习,看掌握度一路上升
源码在 GitHub 上,采用 MIT 许可证。克隆后本地运行:
git clone https://github.com/brianhliou/hanzi-flow.git
cd hanzi-flow/app
npm install
npm run dev
打开 http://localhost:3000。