Hanzi Flow:適応型の中国語リーダー
要点
- Hanzi Flow は中国語の読解アプリだ。実際の文のピンインを入力していくと、まだ知らない漢字が2〜5字含まれるように次の文が選ばれる。
- Tatoeba の79,000文以上を利用している。ルールベースのピンインに GPT-4o-mini を通したことで、著 が zhe であるべきところ zhu4 と読まれるような誤りを10,336件修正した。
- 各漢字の習熟度は移動平均で表され、間隔反復は1時間から始まるため、新しい漢字は同じセッション中に何度も戻ってくる。
- ローカルファースト設計だ。アカウント不要で、進捗はウェブブラウザ内に残り、オフラインでも動作する。
Hanzi Flow は「適応型の文選択」という一つの発想を中心に作った漢字練習アプリだ。現在の習熟度に基づいて、未知の漢字が2〜5字含まれる文を(79,000件以上の実例から)選び、理解度90〜95%の帯を保つ。デッキ管理は不要で、ピンインを入力して練習するだけだ。
ソース: github.com/brianhliou/hanzi-flow
既存ツールの問題点
中国語学習アプリはおおむね三つの陣営に分かれ、どれにも欠点がある。
Anki のようなフラッシュカードアプリ は孤立した漢字を暗記させる。実際に学ぶよりデッキの整理に時間を使ってしまう。ようやく実際の文章でその漢字に出会っても、文脈から切り離して覚えたために認識できない。
Pleco のような辞書アプリ は調べものには優れているが、完全に受動的だ。読んで理解しても、何も定着しない。能動的想起もタイピング練習もない。
読解アプリや家庭教師 が与えてくれるのは、児童書(退屈)かネイティブ向けコンテンツ(難しすぎる)のどちらかだ。退屈か圧倒されるかで、どちらも流暢さにはつながらない。
欠けているのはフロー状態の維持だ。挑戦的だが苛立たない、理解度90〜95%の領域である。適切な難易度の文が自動で選ばれ、タイピングによる能動的想起がある状態が必要だ。
作ったもの
Hanzi Flow は難易度が適応する文ベースの練習アプリだ。中国語を読み、ピンインを入力すると、各漢字の習熟度に応じて次の文が選ばれる。Anki の間隔反復からデッキ管理を取り除き、Duolingo のセッションループに旅行会話集の文ではなく実際の文を載せたものだ。
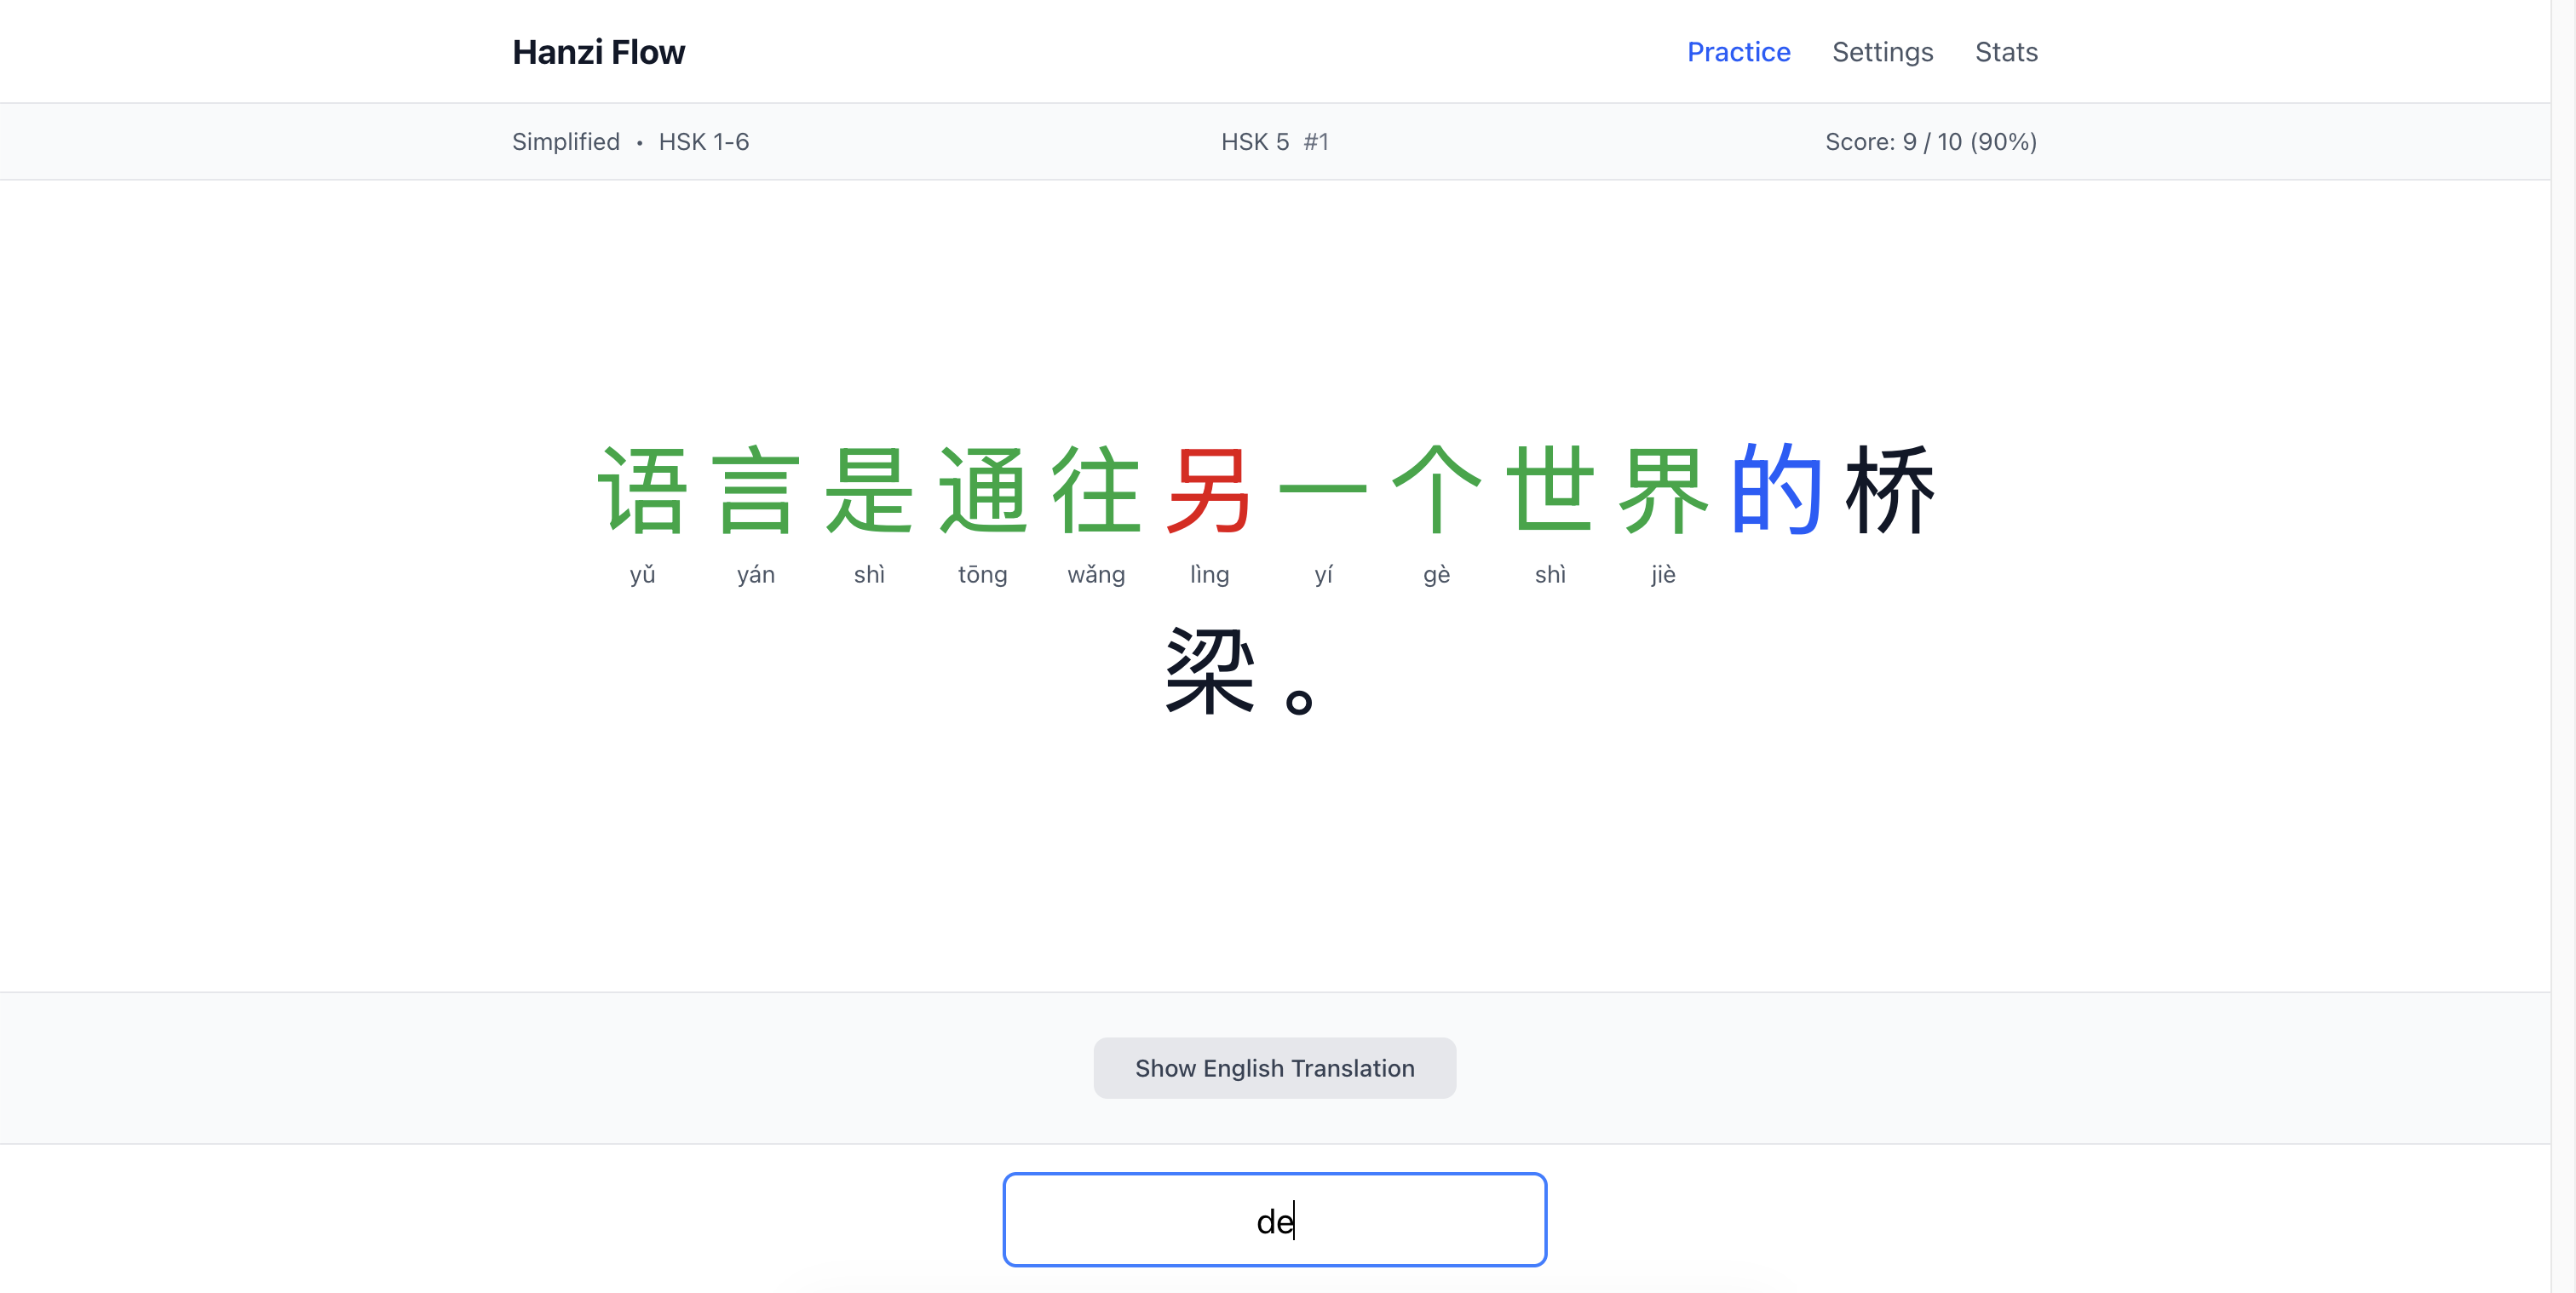
アプリの内容:
- Tatoeba 由来の 79,000文以上(教科書例文ではなく実際の用例)
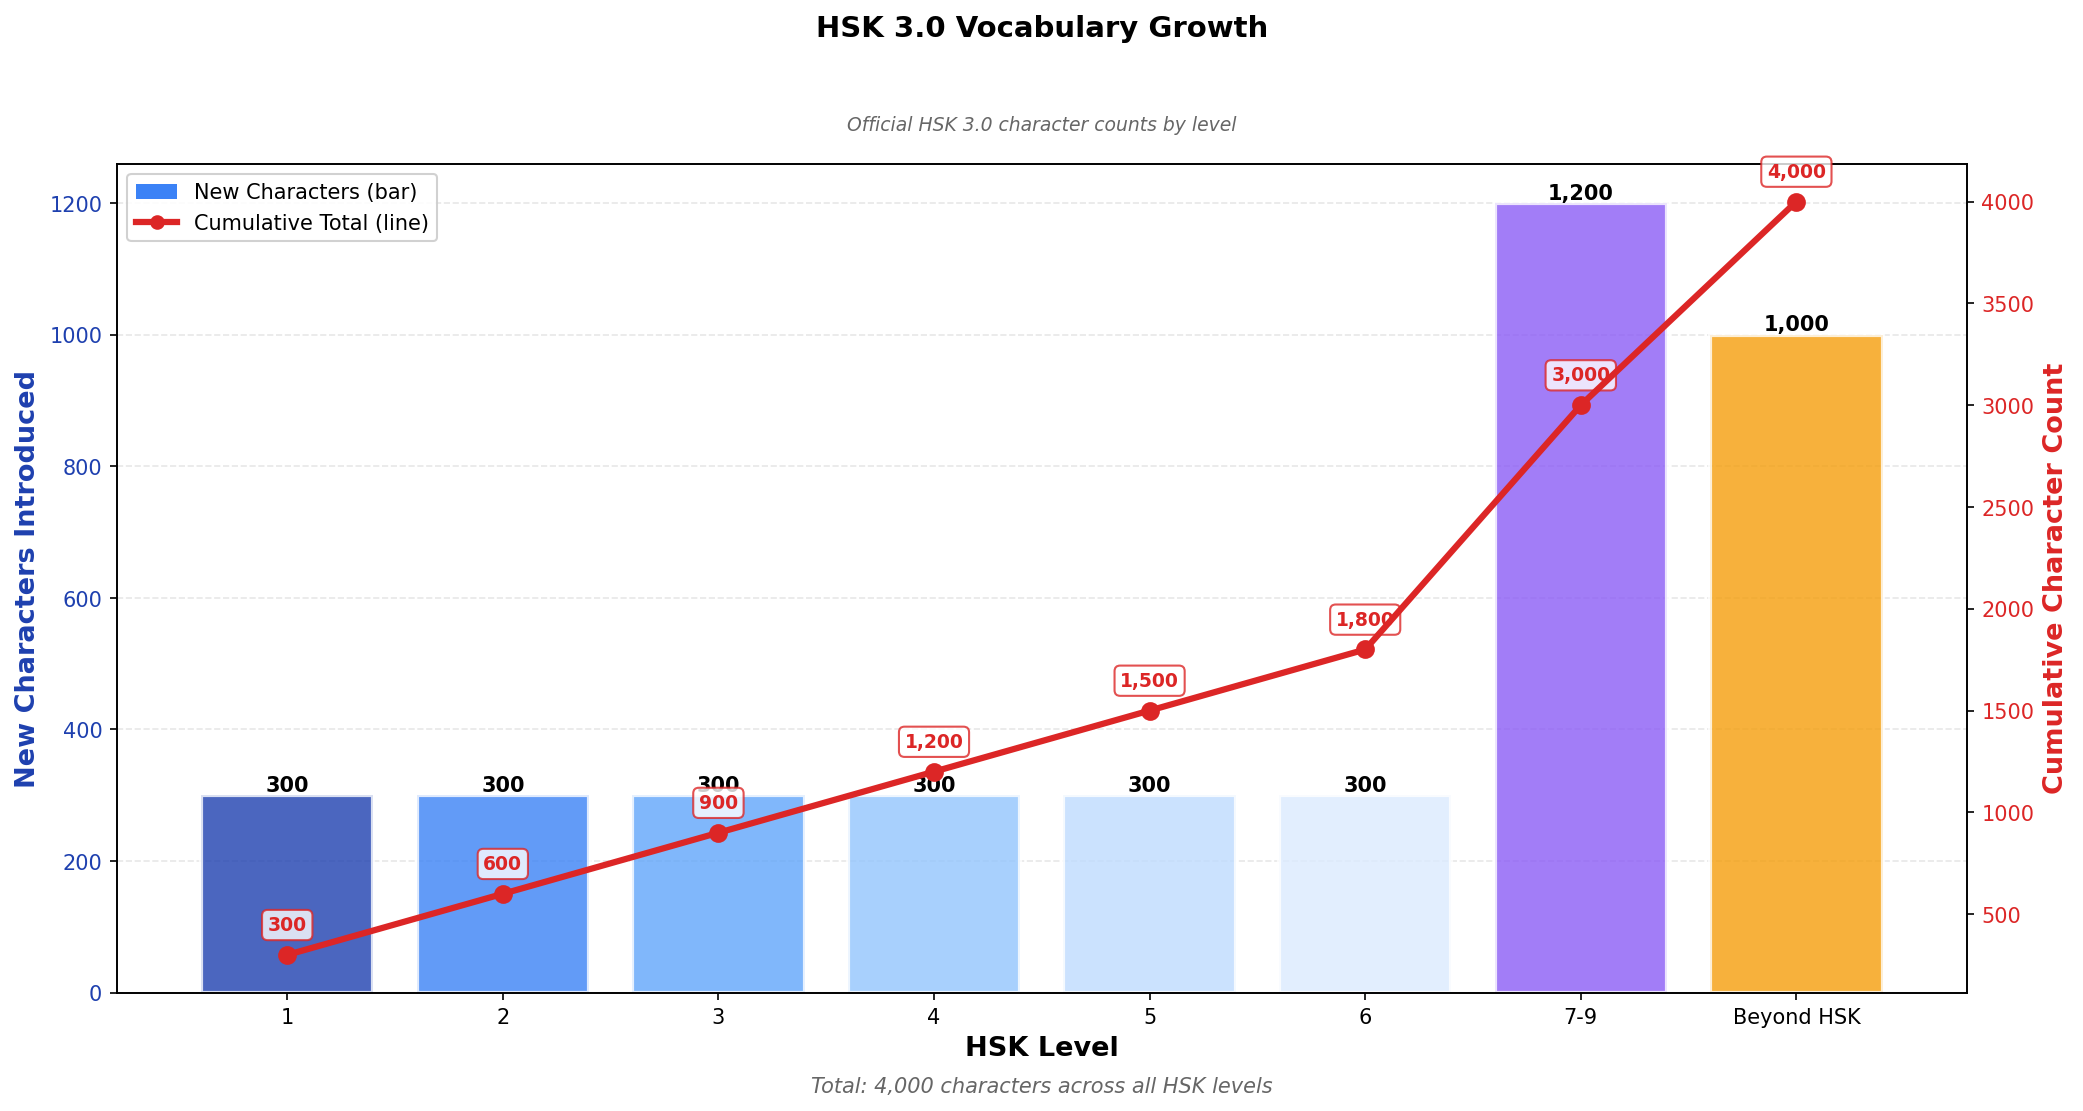
- 4,000字以上 ー HSK 1〜9 に加え、HSK 外の約1,000字
- 適応アルゴリズム ー 習熟度に基づいて未知の漢字が2〜5字含まれる文を選ぶ
- 習熟度トラッキング ー 間隔反復付きの漢字単位スコア(EWMA + SRS)
- HSK 3.0 準拠 ー 公式カリキュラムのレベル(1〜9 または Beyond)で絞り込み
- 字体対応 ー 簡体字、繁体字、または混在
- リアルタイムのフィードバック ー 色による視覚的な手がかりと1,598個の音声ファイル(全ピンイン音節)
- 完全にローカルファースト ー アカウントなし、トラッキングなし、オフライン動作
自分のレベルに合った本物の文で練習し、ピンイン入力でタイピングの流暢さを養う。上達に応じてシステムが適応する。手作業のデッキ管理は不要だ。
ユーザー体験
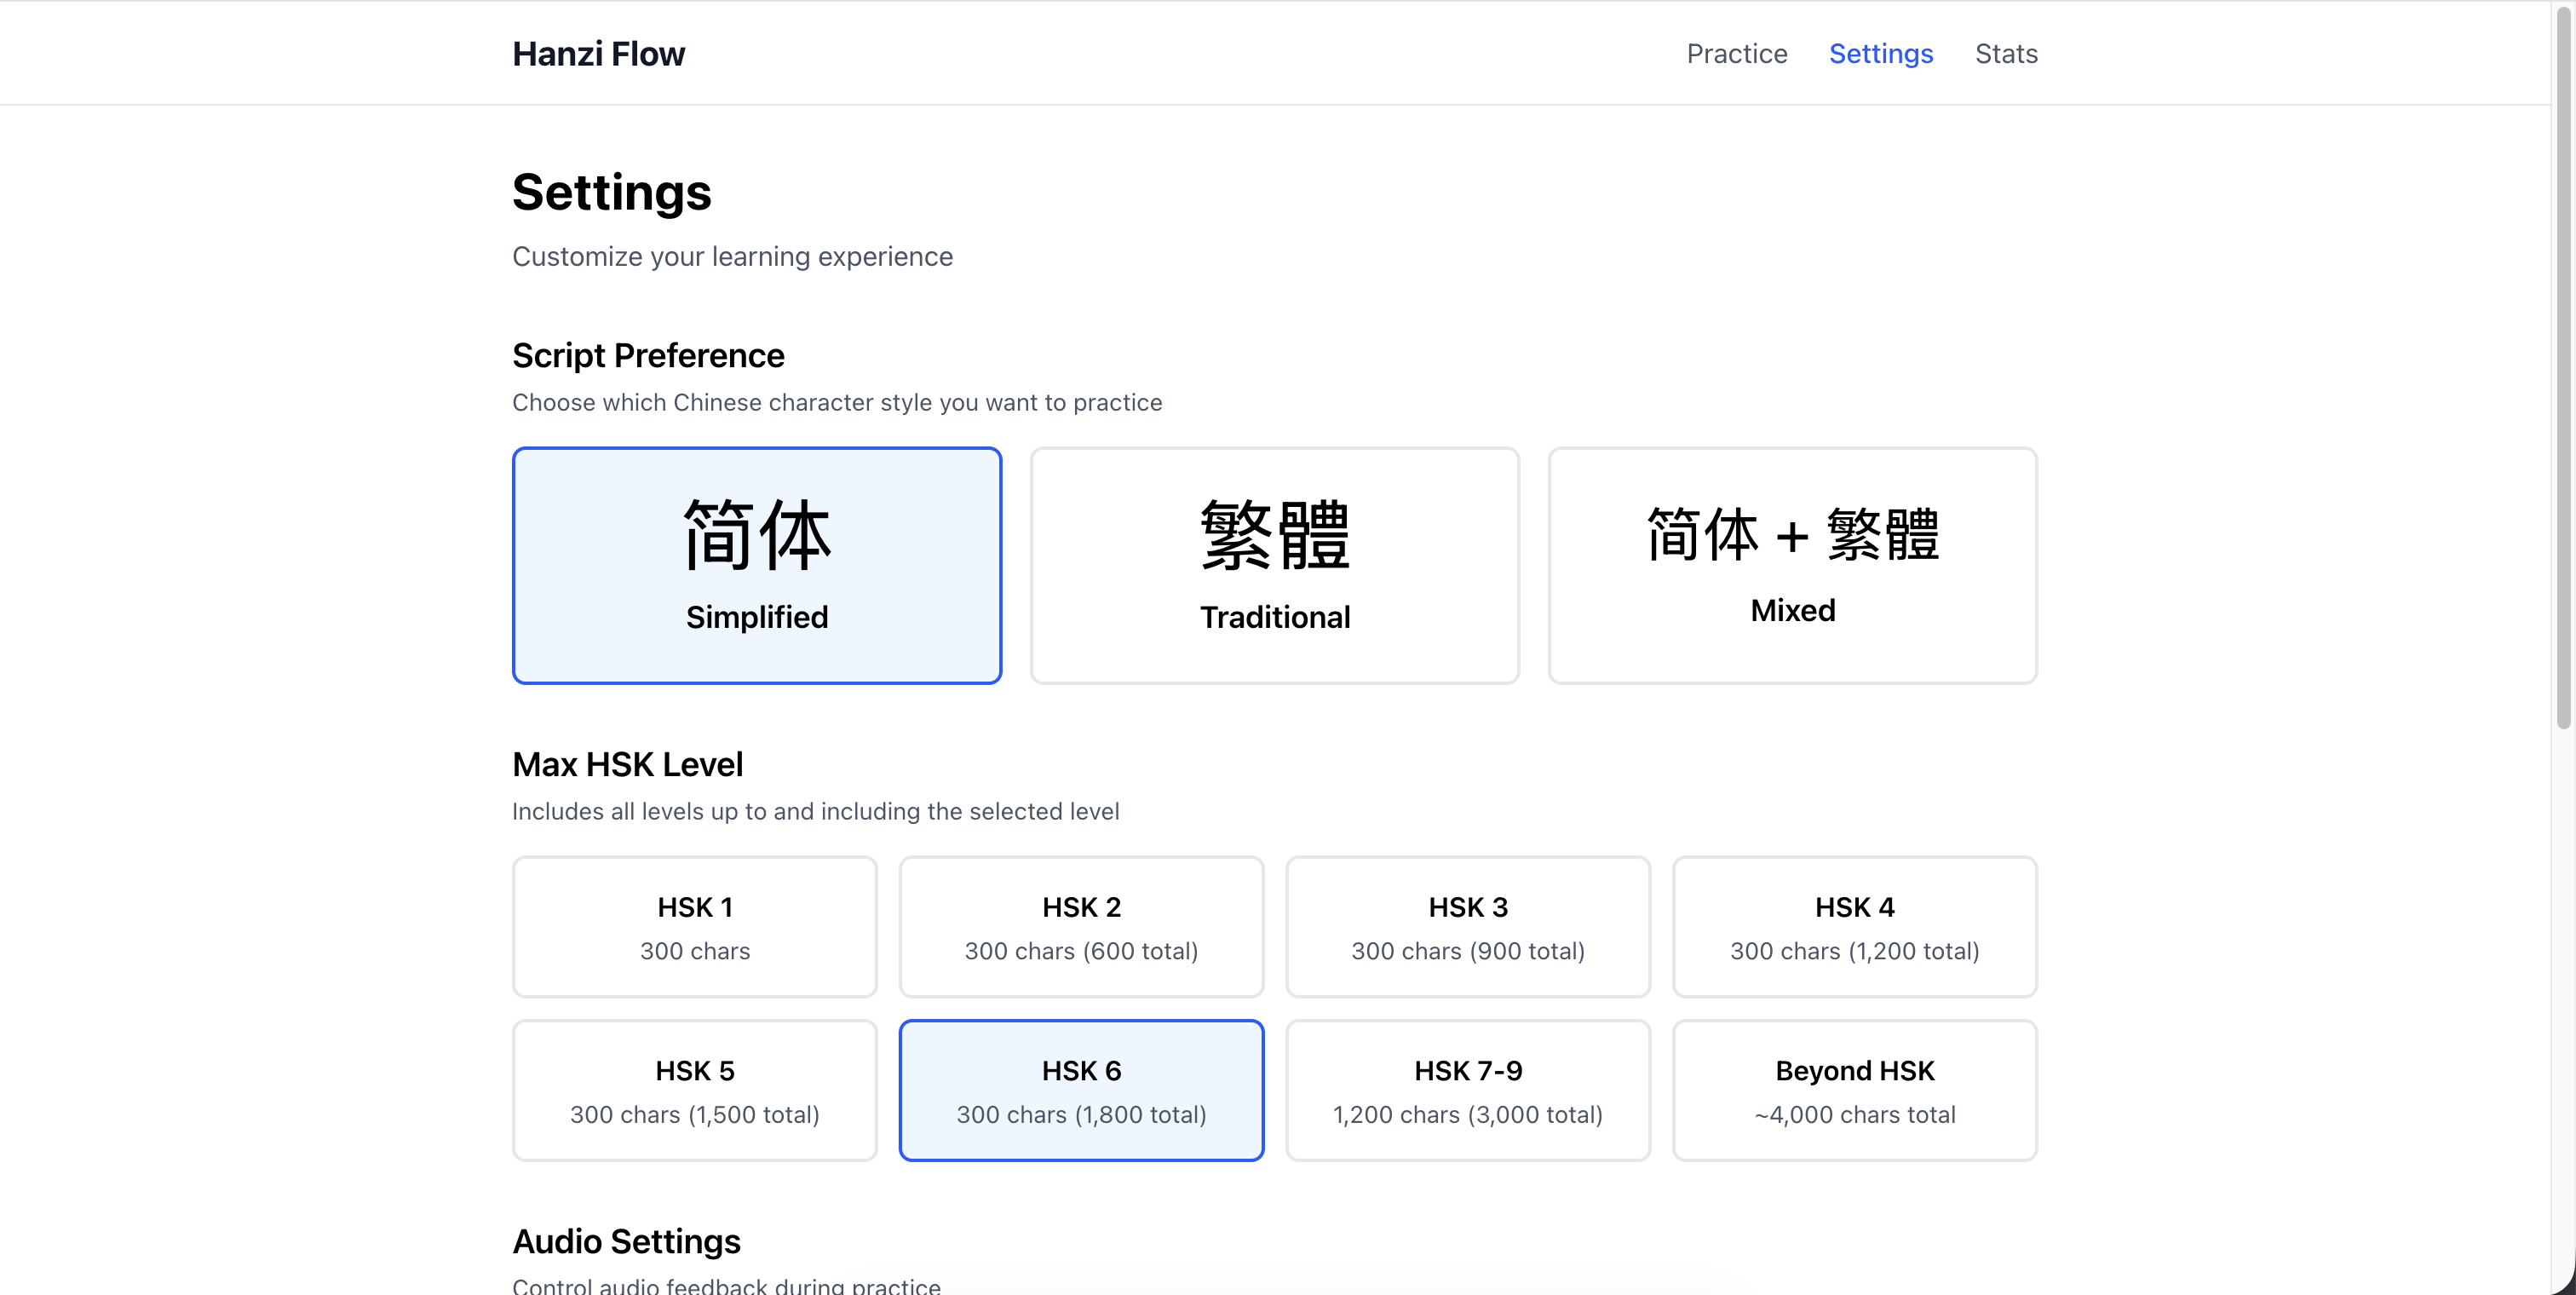
初回起動:設定を選ぶ
アプリを初めて開くと、二つのことを選ぶ。
字体:簡体字、繁体字、混在のいずれか。目的に合わせてコーパスを絞り込む。
HSK レベル:絞り込みは累積式だ。「HSK 1-3」を選べば、レベル1、2、3の漢字だけを使う文が出る。「Beyond HSK」を選ぶと、公式カリキュラム外の上級漢字約1,000字も含まれる。
これらは設定でいつでも変更できる。変更すると、アプリは現在の文キューを破棄し、新しい条件で再生成する。
練習のループ
練習の流れは単純だ。
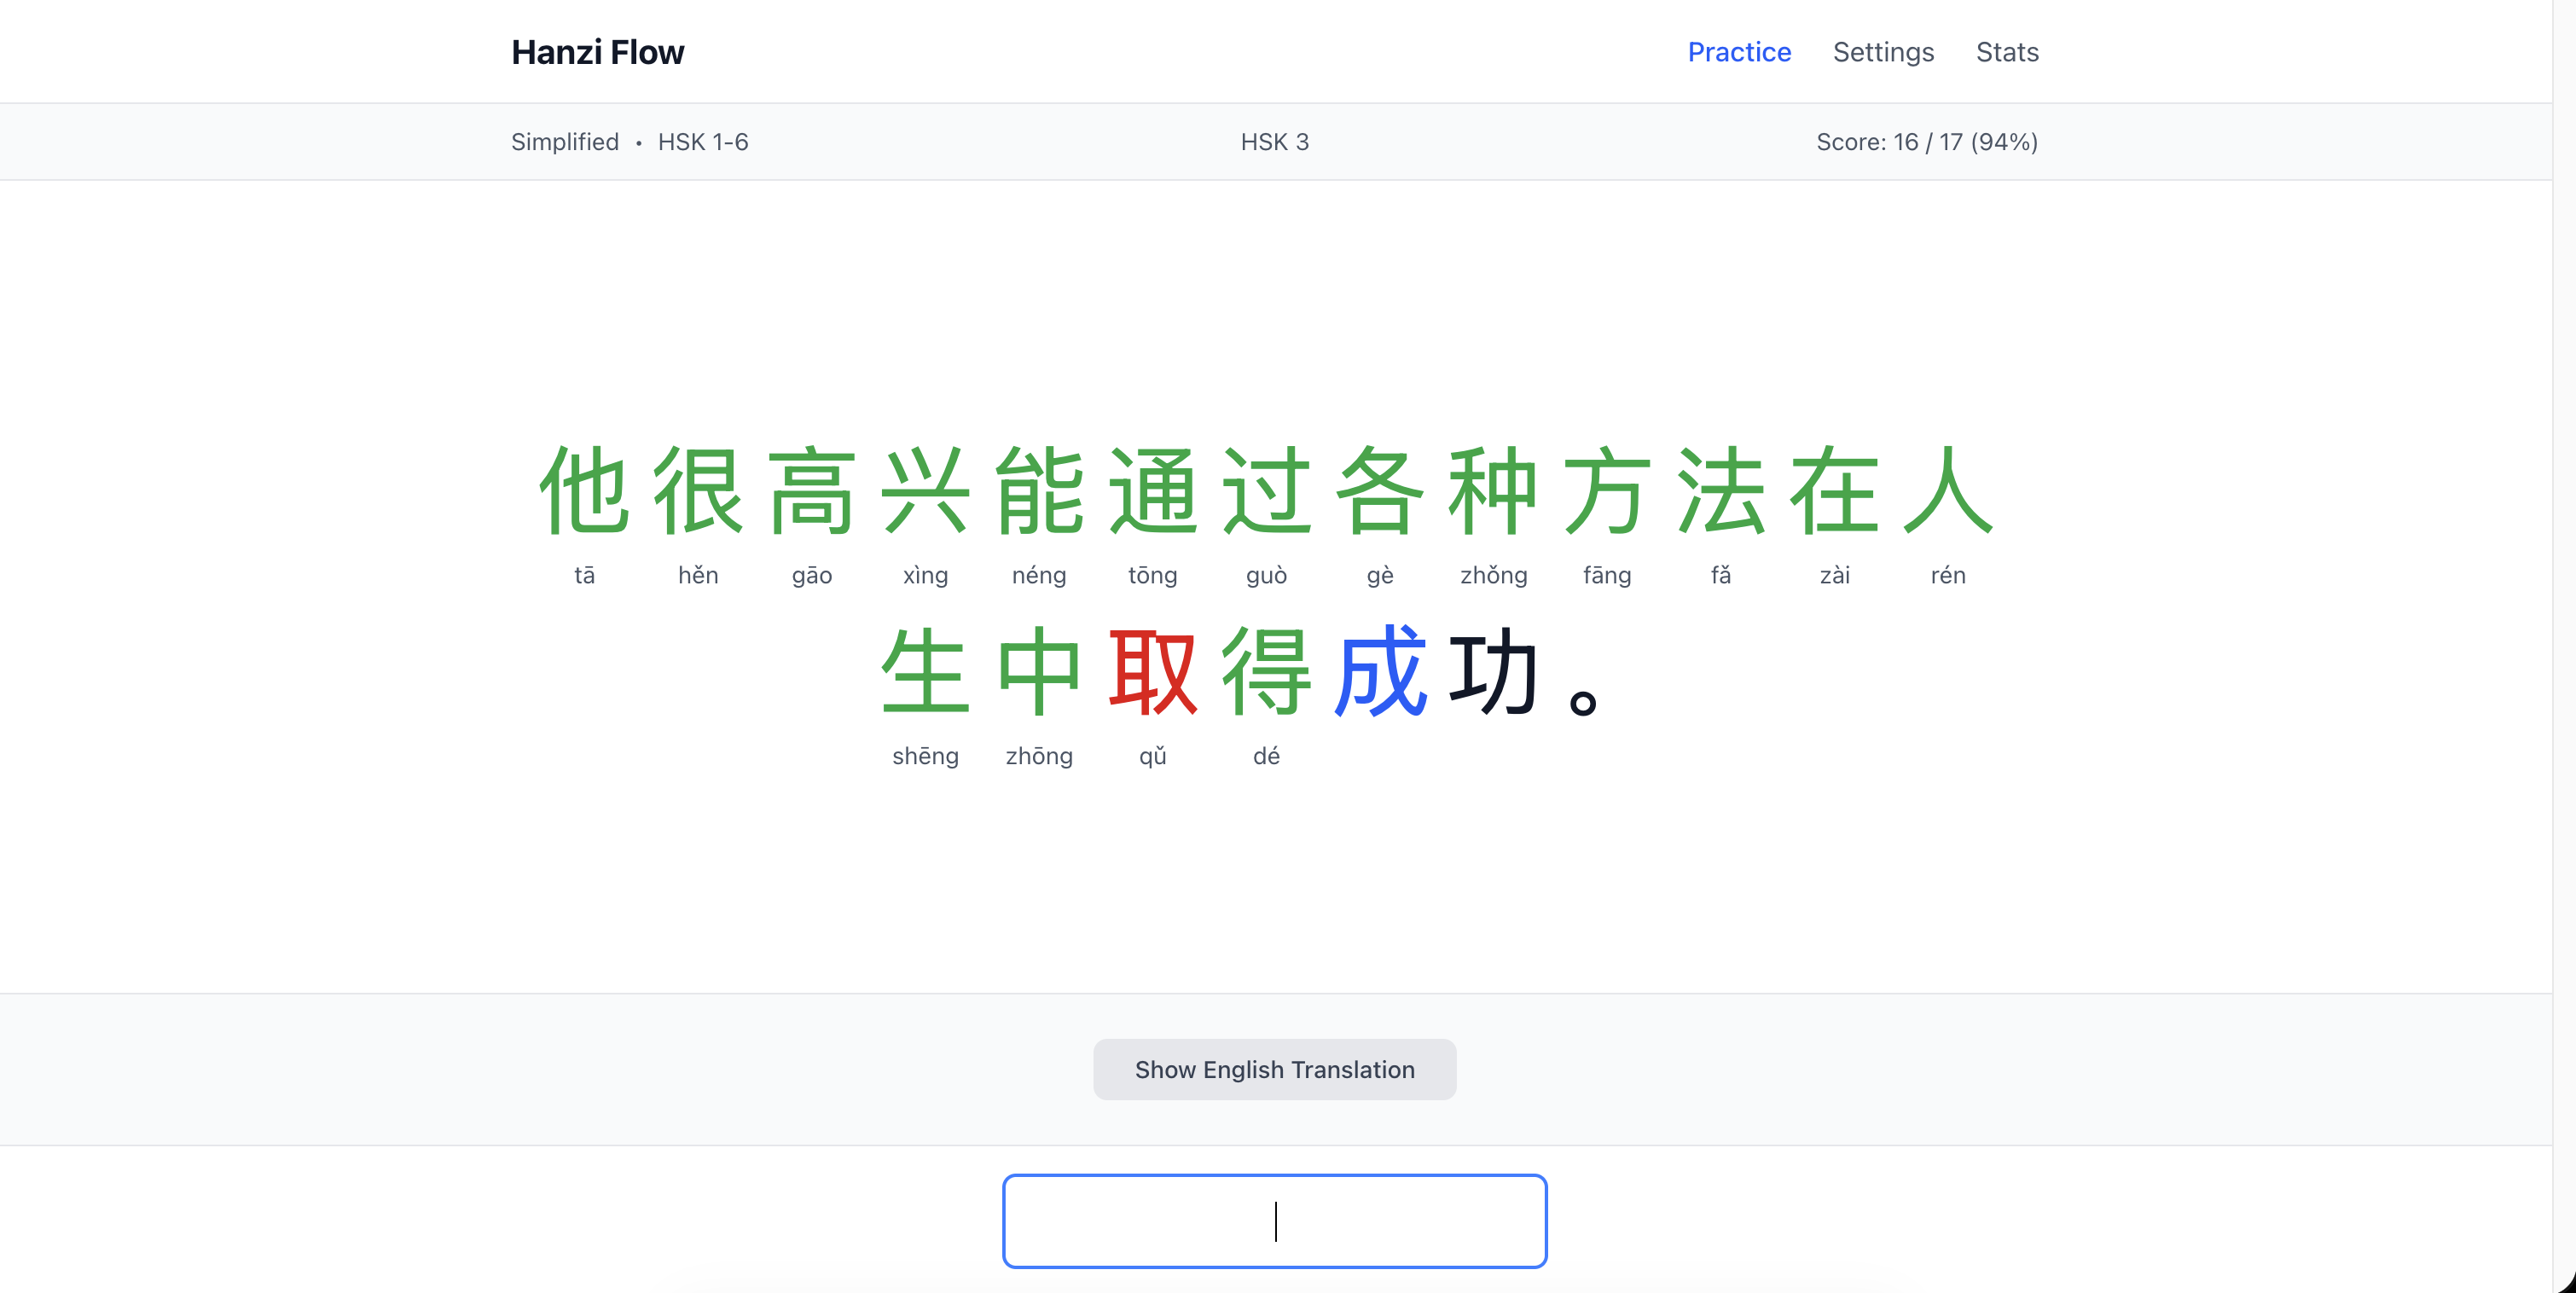
- 文を読む ー 漢字が大きく表示される
- ピンインを入力する ー 1字ずつ、声調は任意(
wo3でもwoでも通る) - フィードバックを得る ー 現在の字は青くハイライト、誤りは赤く点滅して再試行(最大4回)
- ピンインを確認する ー 声調付きの正解が各漢字の下に表示される
- 訳を表示する ー 終了後、任意で英訳が下に出る
- 次の文へ ー スペースキーかボタンで進む
フィードバックは即時で視覚的だ。常に現在の漢字(青いハイライト)に集中できる。誤答は赤く点滅し、正しい発音の音声が鳴る。4回間違えるとシステムは次へ進み、その漢字を紫(放棄)と記録する。異読も受け付ける(地 は de と di の両方が通る)が、文脈上正しいものを表示する。
仕組みの核心はフィードバックループだ。現実では、本で漢字を見かけて読みを誤り、そのまま正解を知らないこともある。テレビを見ていて発音を完全に聞き逃すこともある。そうした学習サイクルは遅い。気軽な学習者だと、1字をきちんと覚えるのに十分な接触を得るまで数か月かかりかねない。
このアプリはサイクルを圧縮する。漢字を見て、入力し、音声付きで即時に訂正され、すぐ再試行して次へ進む。端から端まで10秒だ。1セッションで100字やれば、100回の学習サイクルを回したことになる。能動的想起(入力)、即時訂正(音声+視覚)、高い分量(文が次々来る)が積み重なり、受動的な接触では得られないものになる。
進捗のトラッキング
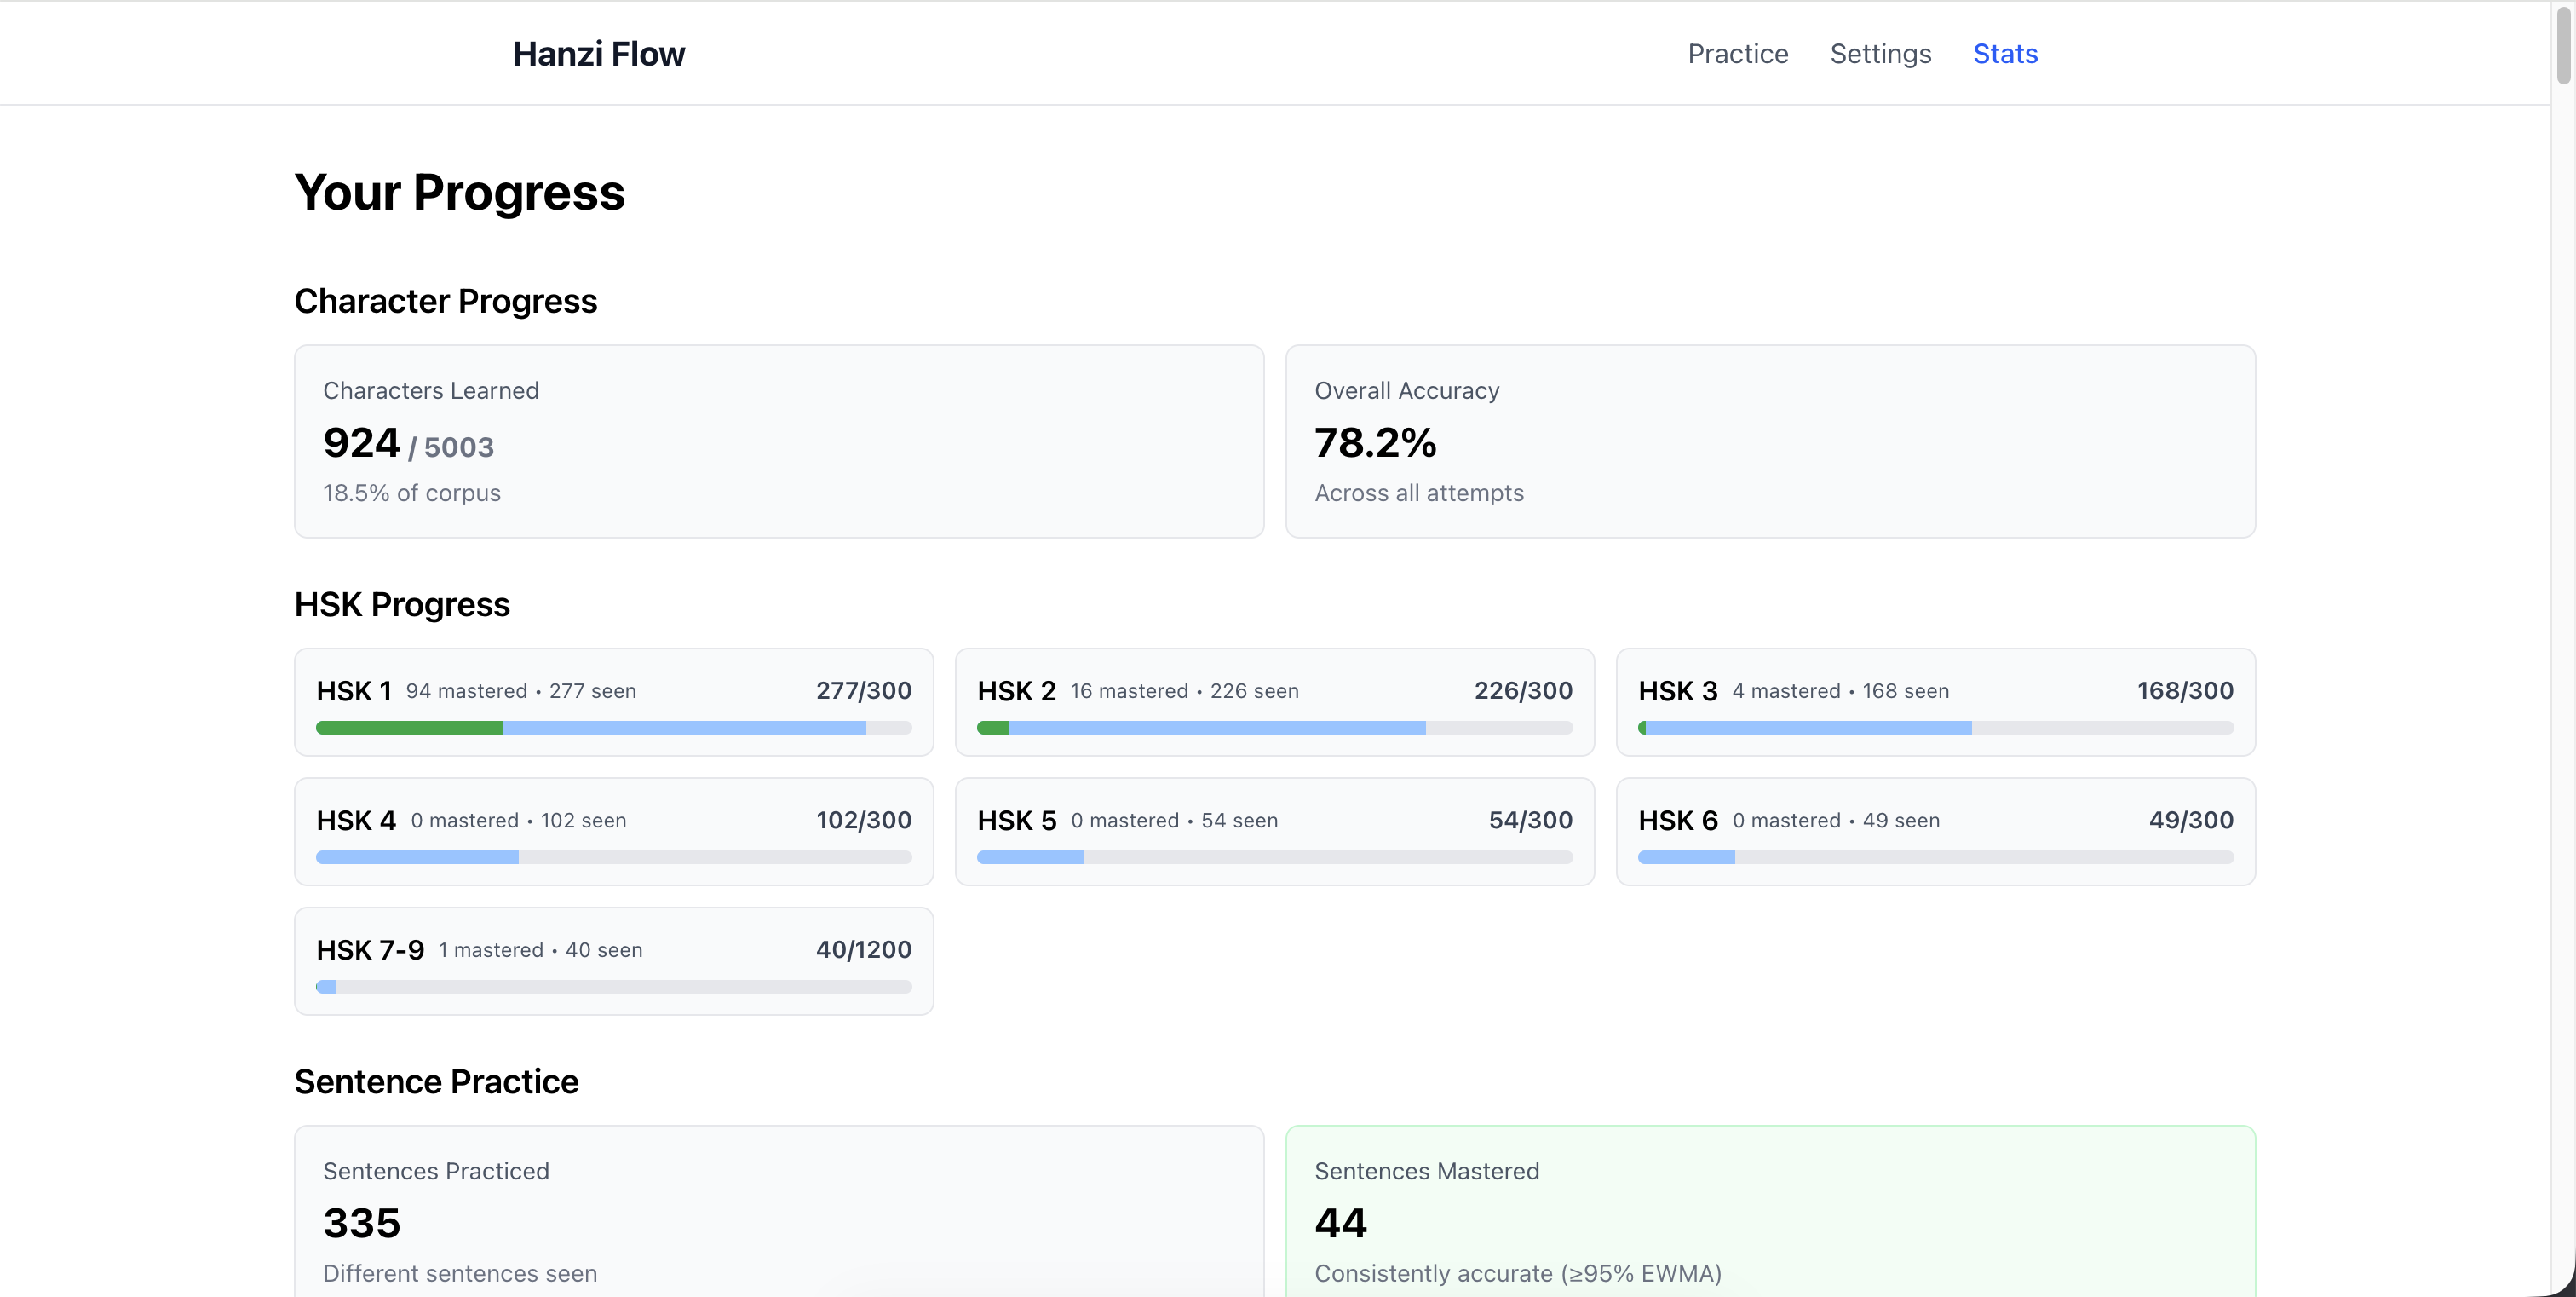
統計ページには主要な4つの指標が表示される。
- 練習した漢字の総数 ー 出会ったユニークな漢字数
- 習得した漢字 ー 習熟度 ≥ 0.8 のもの
- 練習した文 ー 完了したユニークな文の数
- 全体の正答率 ー 1回目で正解した割合
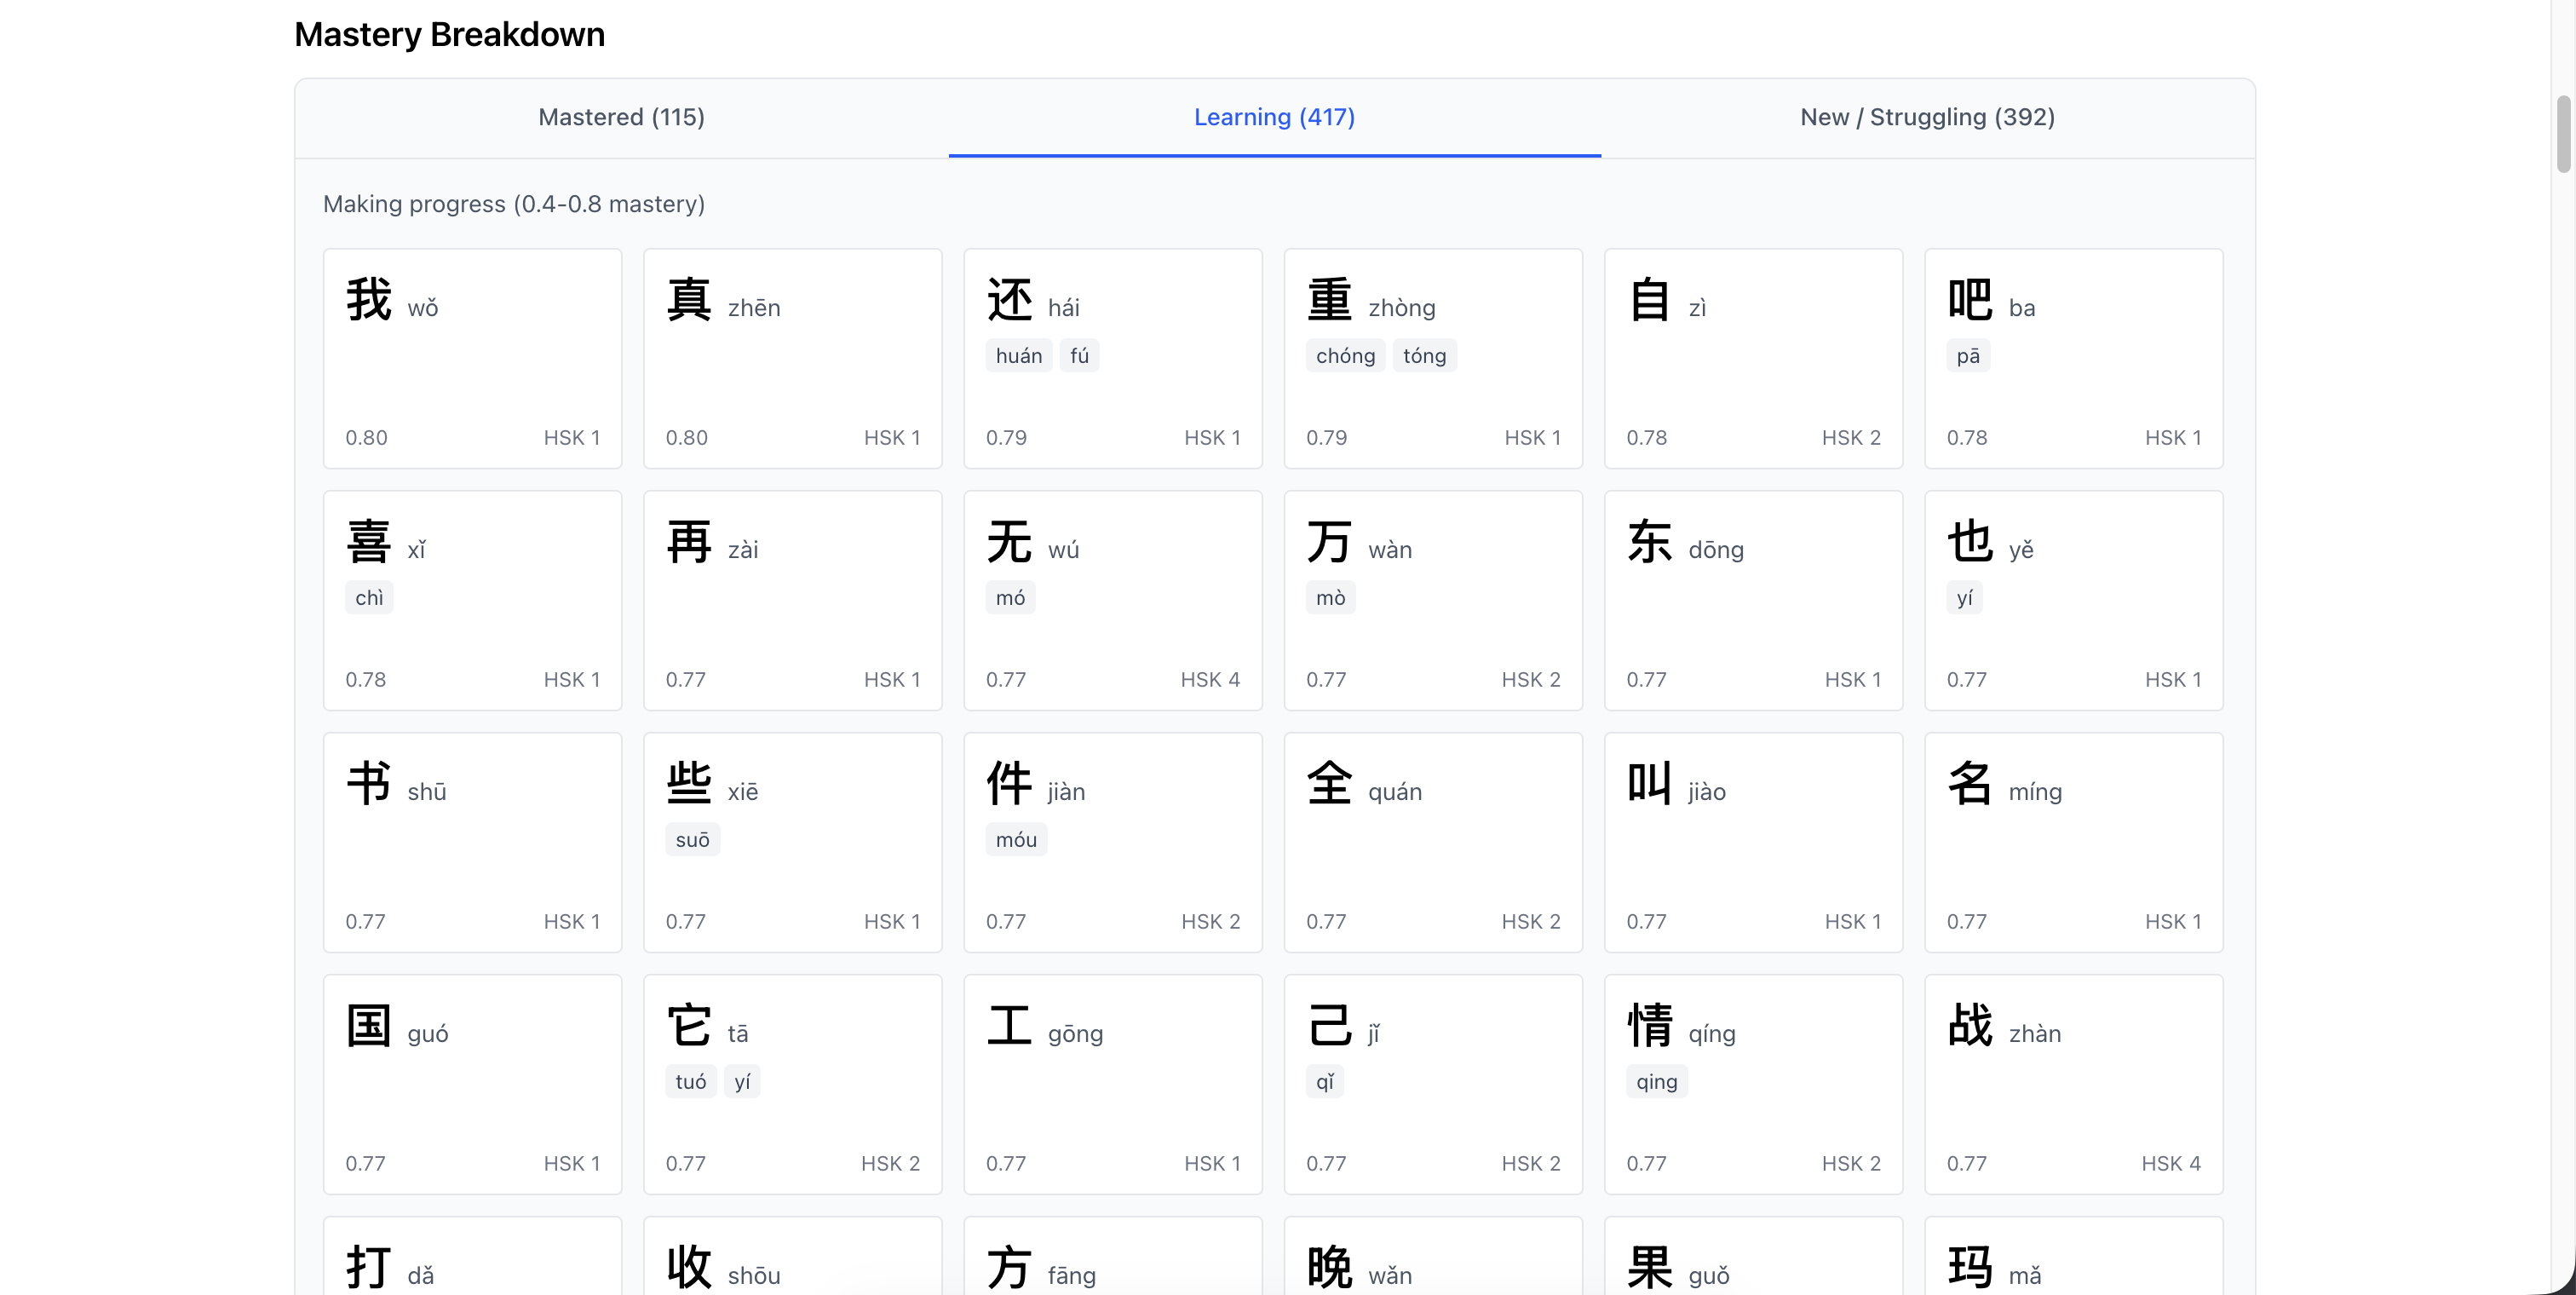
習熟度の内訳では漢字を次のように分類する。
- 学習中(s < 0.6)ー まだ慣れを作っている段階
- 習熟中(0.6 ≤ s < 0.8)ー もう少し
- 習得済み(s ≥ 0.8)ー 安定している
各漢字は間隔反復に基づいて復習期限を記録する。
適応アルゴリズム(NSS)
ランダム選択ではひどいことになる。同じ文が頻繁に出たり、すでに習得したものに時間を使ったり、未知の漢字が10字以上ある文に打ちのめされたりする。
Next Sentence Selection(NSS) が次の文を選ぶアルゴリズムだ。新規学習、間隔反復、新鮮さ、難易度の釣り合いを取る。
基本の考え方
最適点は 1文あたり未知の漢字2〜5字 だ。
- 未知0〜1字 ー 簡単すぎ、単なる復習
- 未知2〜5字 ー 最適。挑戦も文脈も十分
- 未知6字以上 ー 難しすぎ、当て推量になる
アルゴリズムは次の点も釣り合わせる。
- 新規学習(まだ見たことのない漢字)
- 間隔反復(期限の来た漢字の復習)
- 新鮮さ(同じ文を繰り返し詰め込まない)
- 多様性(難易度を混ぜる)
仕組み
NSS はバッチで動く。練習を始めると10文を生成する。8文終えた時点で、次のバッチをバックグラウンドで先読みする。待たされることはない。
4つのステップがある。
1. 対象となる文を絞り込む
コーパス全体(79K)から始める。次の条件を適用する。
- 字体(簡体字/繁体字/混在)
- HSK レベル(選択した範囲)
- クールダウン(直近20分に見た文を除外)
これで対象プールが得られ、通常は20K〜40K文になる。
2. ランダムに300候補を抽出する
プールから無作為に300文を取る。多様性には十分な大きさで、高速にスコア付けできる小ささ(100ms未満)だ。無作為抽出により、セッションごとに異なる文に出会える。
3. 各候補にスコアを付ける
300文それぞれについて、4つの要素からスコアを計算する。
- 基本ゲイン ー 各漢字の (1 - 習熟度) の合計。習熟度が低い字ほど高い。復習期限を過ぎているとゲインは2倍になる。
- 新鮮さ ー 最後に見てからの経過時間に基づくボーナス。多様性を促し、繰り返しの詰め込みを防ぐ。
- 通過ペナルティ ー この文を何度も完璧にこなしている場合はスコアを下げる。練習しすぎを避ける。
- k ペナルティ ー 未知2〜5字の帯から外れる文にペナルティを与える。難易度を守らせる。
合計する:score = base_gain + novelty - pass_penalty - k_penalty
4. 上位10文を選び、シャッフルしてキューへ
スコア順に並べ、上位10文を取り、難易度を混ぜるためシャッフルする。キューに追加する。
この10文を練習する。残り2文になると、アルゴリズムがバックグラウンドで再実行され、次のバッチを先読みする。
習熟度のトラッキング
すべての漢字に0.0から1.0の 習熟度スコア(s)が付く。
- s = 0.3(新しい漢字の初期値)
- s → 1.0(安定して正解できている)
- s → 0.0(間違えている)
更新には α=0.15 の 指数加重移動平均(EWMA) を使う。直近の成績がより重く効くが、変化は緩やかだ。1回の失敗で急落せず、1回の成功で膨らみもしない。
漢字を正解すると、その 安定度(SRS の間隔)が1.2倍に伸びる。1時間から始まり、次は1.2時間、次は1.44時間となる。Anki の急な跳躍(1日 → 3日 → 7日)より長くローテーションに留める。
なぜ遅くするのか。同日中の復習が重要 だからだ。短期記憶から長期記憶へ移すには、1セッション内で同じ漢字を3〜5回見る必要がある。急な跳躍はその窓を逃す。
漢字が期限(next_review_ts を過ぎた状態)になると、スコア計算で2倍の重みを持つ。アルゴリズムは期限切れの漢字を含む文を優先する。典型的な間隔反復だ。
データパイプライン
これを作るには包括的なデータが必要だった。発音付きの漢字、訳文付きの文、難易度タグ、品質フィルタである。コーパスの構築方法は次のとおりだ。
文字セット
Unicode の CJK 統合漢字(U+4E00〜U+9FFF)から始めた。20,992字ある。現代中国語の全漢字に加え、まれな異体字や歴史的字形も含む。
次に、3つのソースのデータで各字を補強した。
- Unihan データベース ー ピンインの読み、異体字、部首分解
- CC-CEDICT ー 英語の定義と用例語(学 → “study; learn”、学生 → “student”)
- OpenCC ー 字体分類のための簡体字/繁体字の対応
結果として、漢字の99.7%にピンインがあり、67%に英語の語義があり、35%に異体字の対応がある。どの漢字が実際に Tatoeba に現れるか(5,000字以上)と、どれが理論上のもの(まれな古典語)かも把握できている。
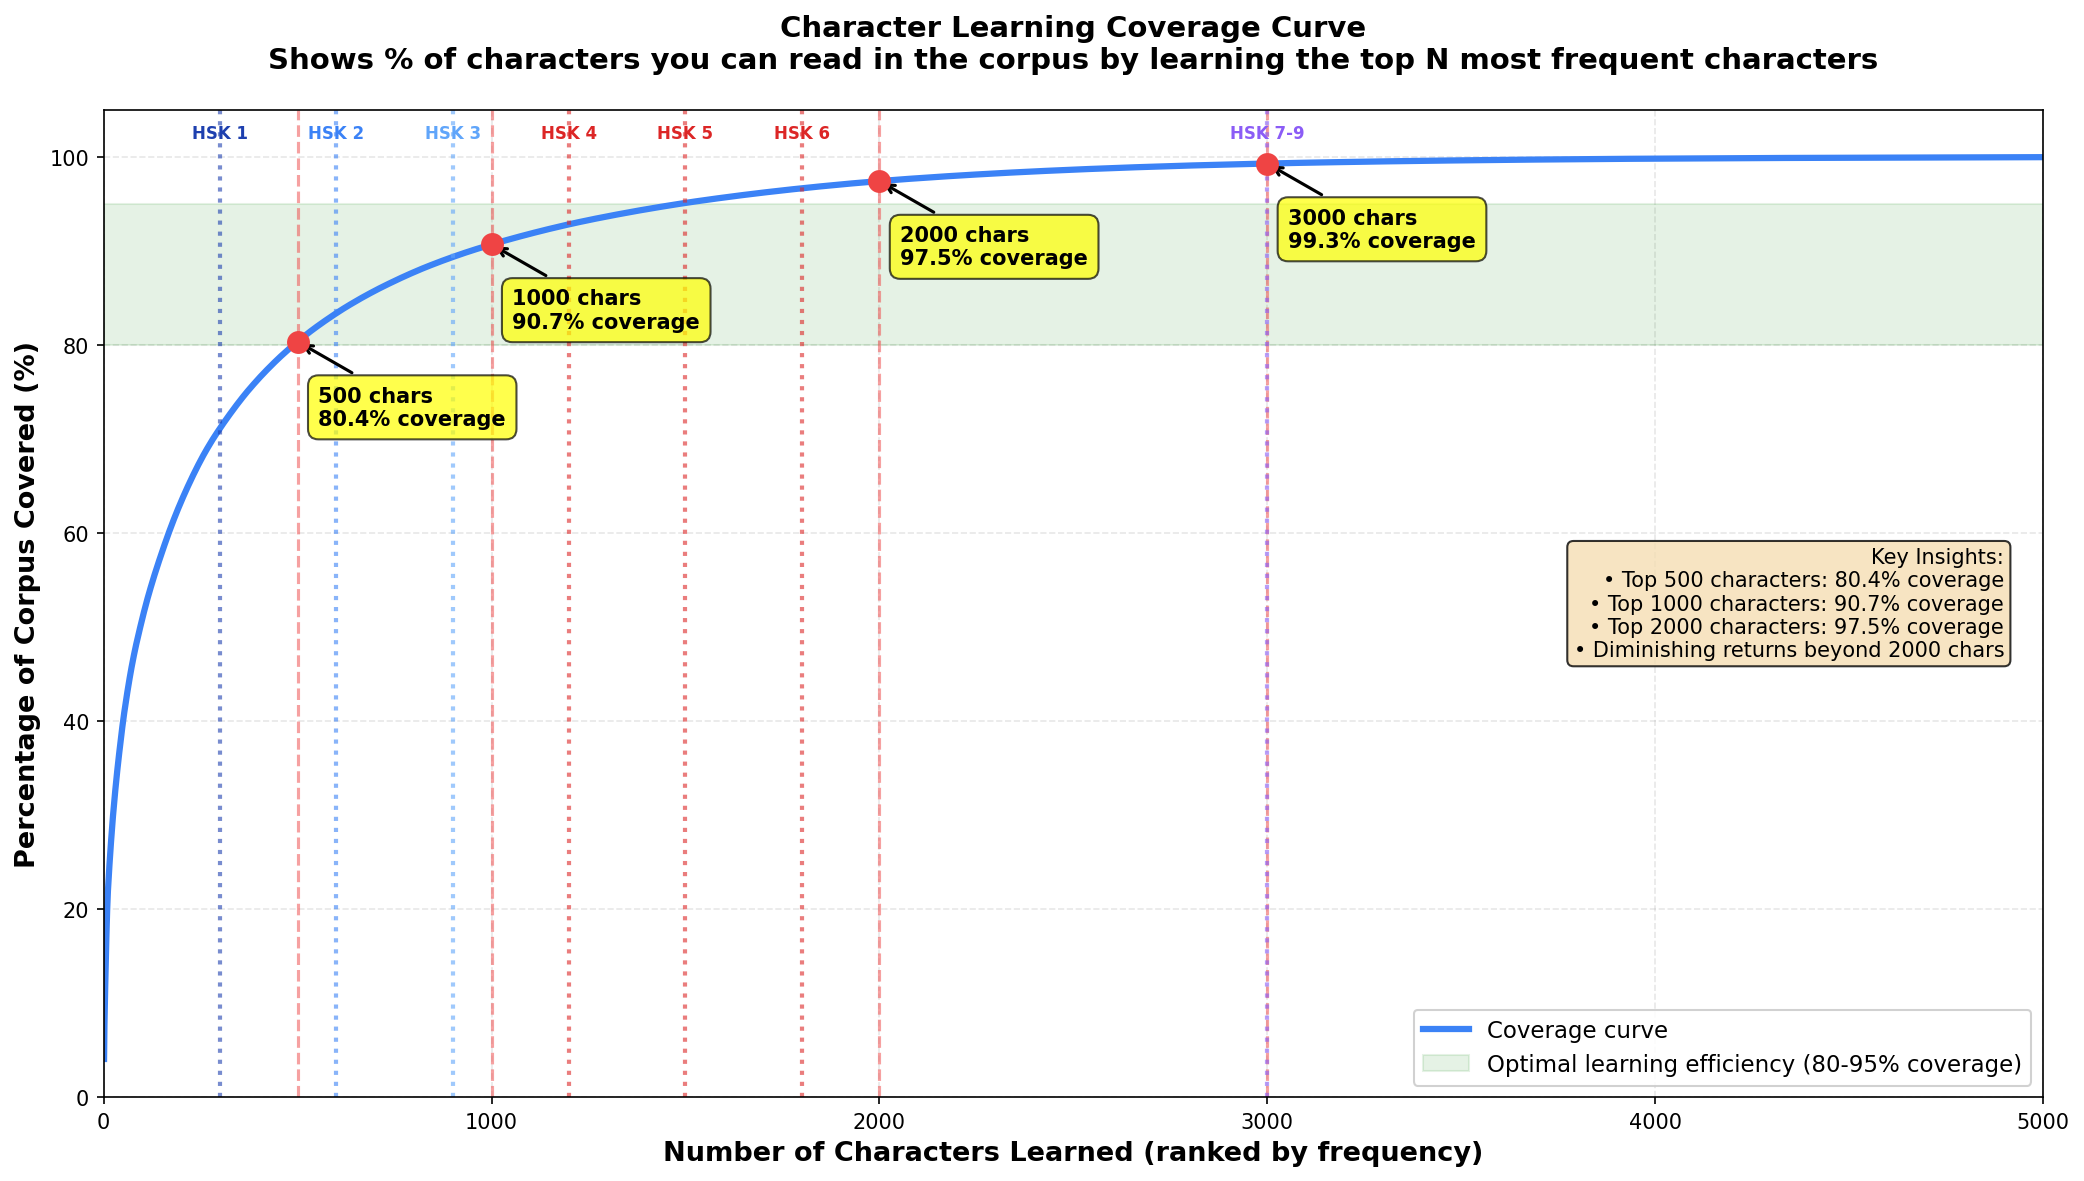
この曲線は HSK レベルをまたいで漢字が積み上がる様子を示している。HSK 1 は約300字、HSK 2 でさらに300字追加、という具合だ。識字の閾値である約3,000字に近づく高いレベルでは曲線が平坦になる。それを越えると収穫は減っていく。
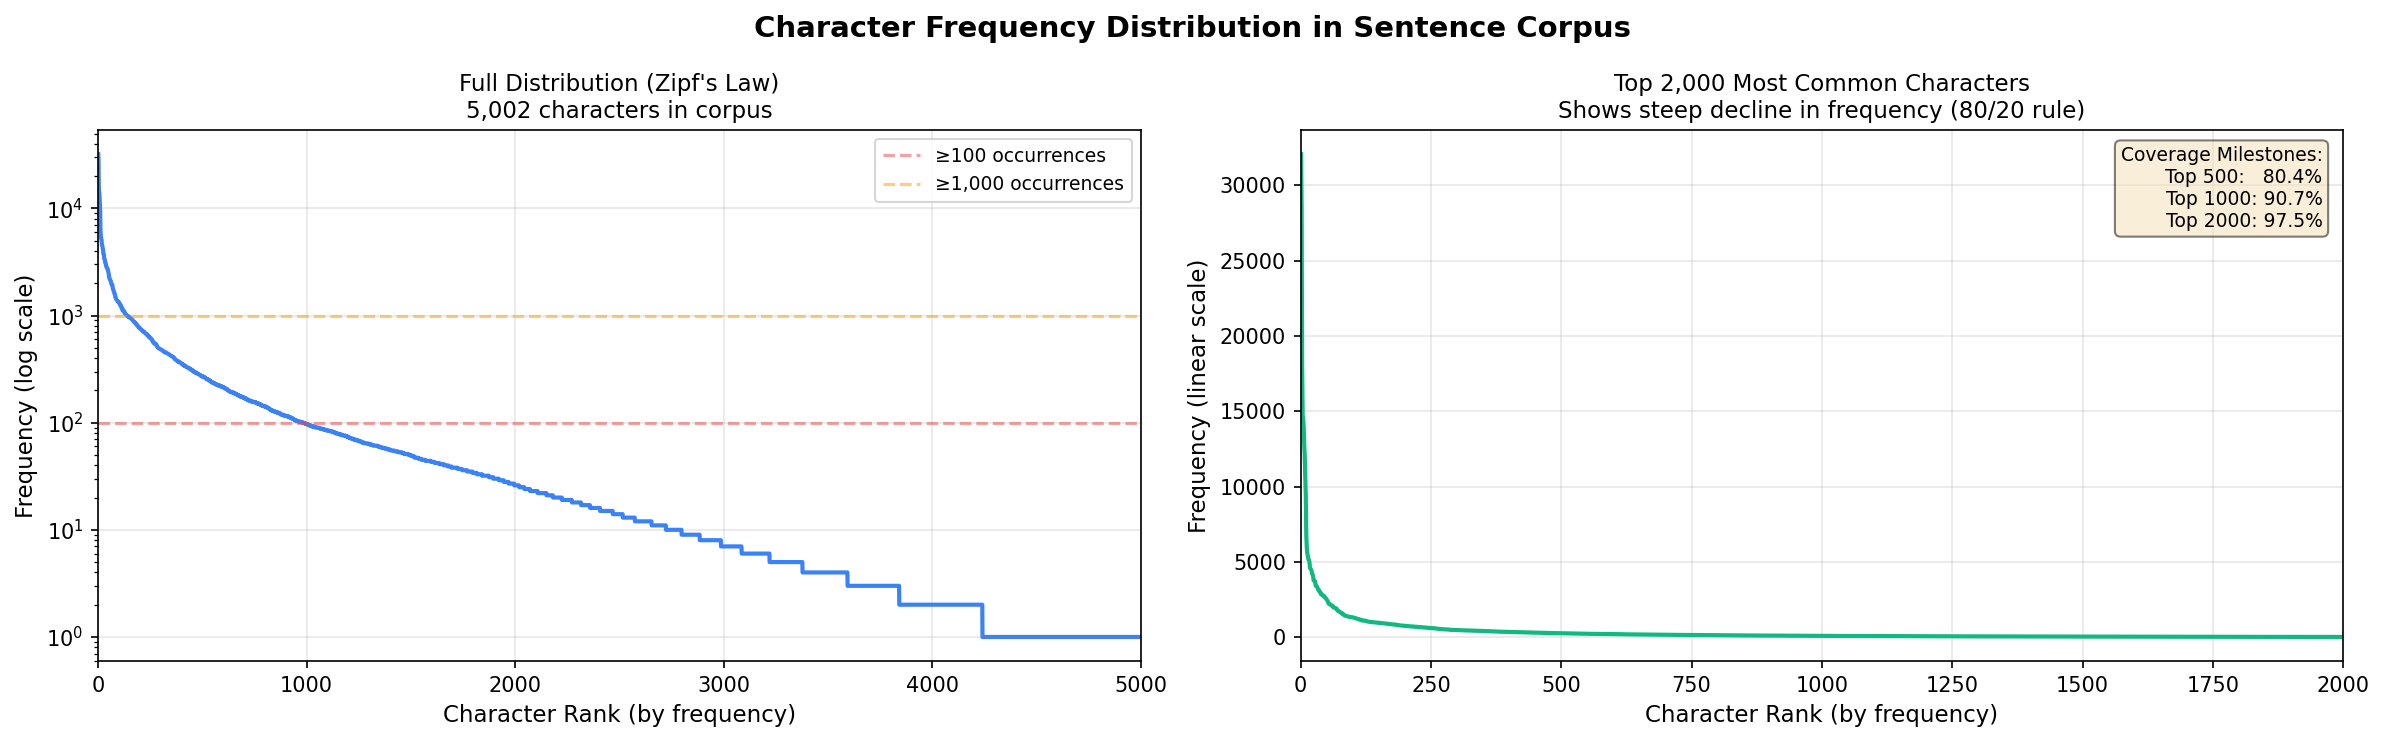
頻度分布はジップの法則に従う。ごく一部の漢字が大部分を占め、多くはまれだ。上位500字が文章の75%を、上位2,000字が95%をカバーする。高頻度のものから学べばすぐ読解力になるため、これは適応アルゴリズムにとって重要だ。
HSK による分類
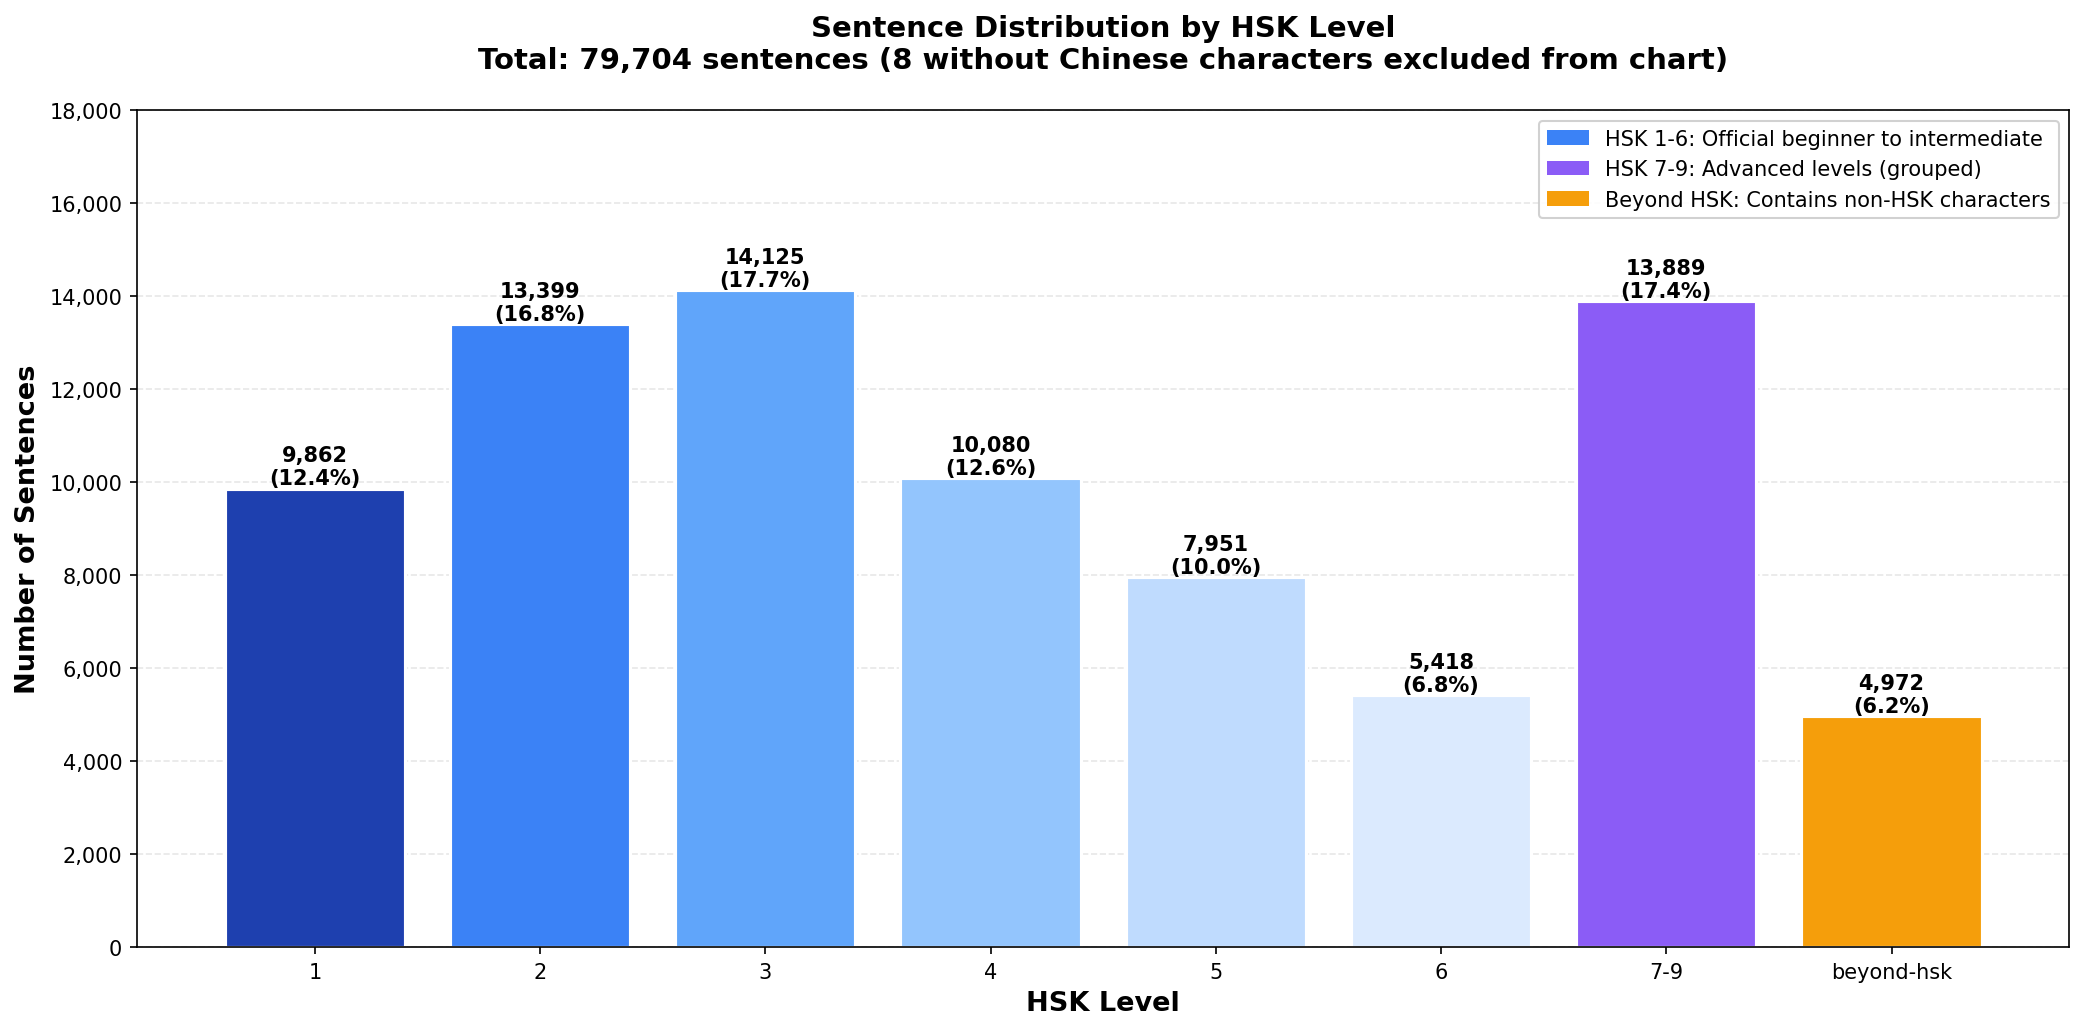
HSK(漢語水平考試)は中国の公式な語学能力試験だ。2021年の改訂版(HSK 3.0)は9レベル、合計3,000字を定めている。政府の PDF から OCR された elkmovie/hsk30 の公式リストを統合した。
各文は、その中で最も難しい漢字によって分類される。
- 全部 HSK 1 の字か?「1」とタグ付け
- 最難の字が HSK 3 か?「3」とタグ付け
- HSK 9 を超える字があるか?「beyond-hsk」とタグ付け
これがフィルタを動かす。「HSK 3」を選ぶと、すべての漢字がレベル1〜3の文だけが出る。不意打ちはない。
文の処理
クラウドソーシング型の翻訳データベース Tatoeba から中国語の文を79,000件以上取得した。各文は片側が英語、もう片側が中国語になっている。
課題:文脈を考慮したピンイン。 漢字は文脈によって複数の発音を持つ。まず jieba と pypinyin で初回処理を行い、その後 GPT-4o-mini で検証した(79K文で約2ドル)。地(de と di4)、著(zhe と zhu4)、谁(shei2 と shui2)といったよくある多音字にまたがり、10,336件の誤りを修正した。
多音字の例:
- 了:
le(助詞)とliao3(終える) - 行:
xing2(よい)とhang2(行・列) - 长:
zhang3(育つ)とchang2(長い)
表を引くだけでは決まらない。語の文脈を理解する必要がある。
ステップ1:jieba + pypinyin。 jieba が「我们试试看」を [“我们”, “试试”, “看”] に分割し、pypinyin が各語のピンインを生成する。我们试试看 → wo3 men shi4 shi4 kan4。多くの場合はうまくいくが、助詞や口語的な発音では失敗する。
ステップ2:GPT-4o-mini による検証。 コーパス全体を OpenAI の API に通した(79K文で約2ドル、1回の呼び出しで10文をまとめて処理)。声調記号付きで1字ずつのピンインを求めるプロンプトを使った。79,603文のうち10,336件の誤りが見つかった。主な修正は次のとおりだ。
- 覺(120件):pypinyin は
jue2(感じる)、OpenAI はjiao4(眠る)- 你應該去睡覺了吧 ー「もう寝たほうがいいよ」
- 著(696件):pypinyin は
zhu4(着る)、OpenAI はzhe(助詞)- 生活就是當你忙著進行你的計劃時… ー「人生とは計画を立てるのに忙しいときに起きるものだ」
- 谁(404件):pypinyin は
shui2(文語的)、OpenAI はshei2(口語的)- 你知不知道他们是谁? ー「彼らが誰か知っている?」
- 长(136件):pypinyin は
zhang3(育つ)、OpenAI はchang2(長い)- 我看见一个长头发的女生 ー「長い髪の女の子を見かけた」
上位の漢字は手作業で確認し、確度の高い修正を適用した。OpenAI の文脈理解は、ルールベースの手法が見逃す誤りを捉えた。
英訳: こちらも GPT-4o-mini で生成した(総額約1ドル)。Tatoeba のデータセットには約2,000文分の訳しかなかった。それを使えばコーパスが79,000文以上から2,000文に減り、適応アルゴリズムの効果を損なってしまう。そこで GPT-4o-mini で79,000文以上すべてを翻訳した。LLM は文脈を使うため翻訳が得意で、それは正確な中英変換にまさに必要なものだ。例:
- 我們試試看! → Let’s give it a try!
- 你在干什麼啊? → What are you doing?
- 今天是6月18号,也是Muiriel的生日! → Today is June 18th, and it’s Muiriel’s birthday!
- 生日快乐,Muiriel! → Happy birthday, Muiriel!
- 密码是”Muiriel”。 → The password is “Muiriel.”
品質フィルタも適用した。
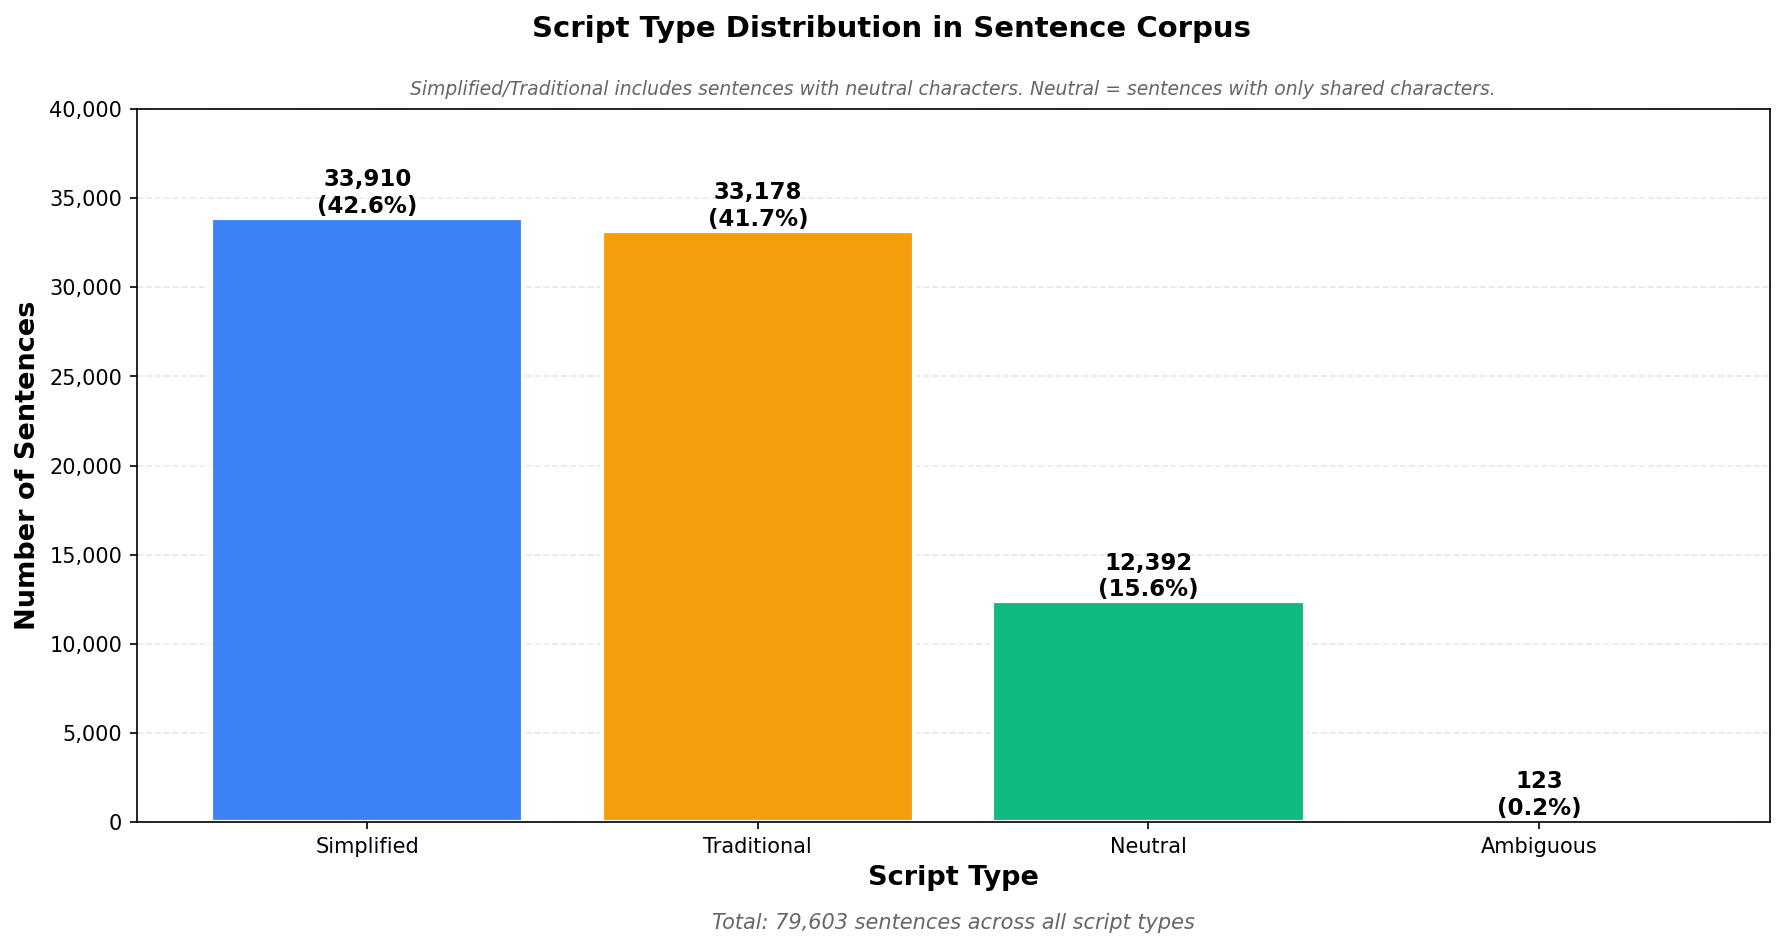
- 字体の分類 ー 簡体字、繁体字、中立、混在
- 不適切語の除去 ー 下品な表現を除外(約10文)
- 長さの上限 ー スクロールを避けるため50字を超える文を削除(約270文)
- メタ的な文 ー Tatoeba 自体に言及する文を削除(約80文)
最終的なコーパスは 79,333文のクリーンな文 だ。
アーキテクチャと性能
モダンなウェブ技術で構築し、速度とプライバシーに最適化した。
なぜローカルファーストなのか
- プライバシー ー アカウントなし、トラッキングなし、テレメトリなし。進捗が端末を離れることはない。アナリティクスすら入れていない。データは自分のものだ。
- 性能 ー ネットワーク遅延がない。文の選択は100ms未満で走る。入力のフィードバックは即時だ。統計は50ms未満で読み込まれる。
- 単純さ ー 保守するバックエンドも、スケールさせるデータベースも、認証もない。アプリは静的ファイルとクライアント側の JS だけだ。Vercel で無料でホストしている。
- トレードオフ: 端末間の同期がない。ノートPCとスマートフォンでは別々に練習することになる。MVP としては許容範囲だ。多くの人は主に使う端末が1台だ。後でエクスポート/インポートや任意のクラウド同期を追加できるだろう。
技術スタック
フロントエンド:
- Next.js 15(App Router)
- React 19 + TypeScript
- Tailwind CSS
- IndexedDB 用に Dexie.js
データパイプライン:
- 処理スクリプト用に Python 3.9+
- 単語分割に jieba
- 文脈を考慮したピンインに pypinyin
- 分析に pandas + matplotlib
- 翻訳とピンイン検証に GPT-4o-mini
音声:
- TTS に AWS Polly(Zhiyu の音声)
- 1,598音節、全声調を網羅
- ウェブブラウザ互換性のため OGG 形式
デプロイ:
- Vercel(設定不要)
- 静的サイト、サーバーなし
- グローバル CDN
データの読み込みとキャッシュ
アプリは初回訪問時に大きなデータセットを読み込み、その後は積極的にキャッシュする。
初回読み込み:
- 79,333文(約41MB の JSON)ー 一度だけ取得し、メモリに保持
- 漢字マッピングの CSV(約2MB)ー ID、ピンイン、語義
- 音声ファイル ー 必要に応じて取得(各1〜2KB)
メモリ内キャッシュ:
- 文は JavaScript の配列に保持
- 漢字から ID へのマッピングは Map に保持(O(1) の参照)
- セッション中の再取得なし
IndexedDB での永続化:
- WordMastery テーブル ー 練習した漢字ごとに1行(習熟度スコア、SRS の間隔、次回復習時刻、回数)
- SentenceProgress テーブル ー 完了した文ごとに1行(通過率、試行回数、最後に見た時刻)
- SentenceQueue テーブル ー 次の10文を保存(設定変更時に再生成)
すべてのデータは端末に留まる。初回読み込み以外にネットワーク通信はない。
性能の工夫:
- 音声の事前読み込み ー NSS が次の文を選んだ時点で、そのピンイン音声をバックグラウンドで先読みする(3〜5ファイル、10KB未満)。文が表示される頃には音声はキャッシュ済みだ。
- キューの先読み ー 10文のうち8文を終えると、NSS がバックグラウンドで走って次のバッチを用意する。待たされることはない。
- 遅延読み込み ー 統計ページは訪問時にのみ分布を計算し、操作ごとには計算しない。
オフライン: 初回読み込み後は完全にオフラインで動く。飛行機でも地下鉄でも、どこでも練習できる。進捗は即座に IndexedDB へ保存される(保存ボタンは不要)。
主要な設計判断
声調番号か声調記号か
アプリは声調記号(wǒ、shì)ではなく声調番号(wo3、shi4)を受け付ける。なぜか。
- 入力が簡単(特別なキーボードが不要)
- 中国語 IME の標準(実際の入力の準備になる)
- 曖昧さがない(
vとüは等価、声調記号は Unicode の結合文字が必要) - 視覚的な暗記ではなく、声調を明示的に考えさせる(
wo3は第三声)
文ベースの学習
孤立した単語ではなく、なぜ文なのか。
- 文脈 ー 実際の用法の中で漢字を学べる。「我们试试看」は 我们(私たち)、试试(試す)、看(見る)および 文法パターンを教えてくれる。
- 読解の練習 ー 実際の読書に近い。漢字の連なりを解析する技能が身につく。
- タイピングの流暢さ ー 実際に使う形そのままに、文全体の筋肉記憶を鍛える。
- 難易度の校正 ー 文には自然な難易度分布(未知の漢字数)がある。単語単位では得られない。
- 動機づけ ー 文を1つ終えると前進した感覚がある。「的 的 的」のフラッシュカードを詰め込むのではなく、本物の中国語を読んでいるのだ。
今後の予定
日々の練習に必要な機能は揃っている。また手を入れるなら、次のような追加が考えられる。
- モバイル PWA 化(インストール可能にする)
- HSK 別の統計内訳
- 復習モード(SRS 中心のセッション)
- 文の音声(漢字単位だけでなく全体の発音)
- 漢字カード(字源、筆順、熟語)
- 声調の分析(混同しやすい声調を記録)
- 独自コーパス(自分の文をインポート)
- エクスポート/インポート(端末間での持ち運び)
オープンソースのプロジェクトだ。アイデアがあれば issue か PR を出してほしい。
おわりに
自分の困りごとを解決するために作った。フラッシュカードの手間なしに中国語の読解を練習したかった。本物の文、適応する難易度、すっきりした入力インターフェースだ。
結果として、データパイプライン(文脈を考慮したピンイン付きの79K文以上)、適応アルゴリズム(EWMA + SRS)、ローカルファーストのアーキテクチャ(IndexedDB + キャッシュ)への深い掘り下げになった。多音字、ジップの法則、同日復習に向けた間隔反復の調整について多くを学んだ。
中国語を学んでいるなら試してほしい。開発者ならリポジトリを見てほしい。文の選択アルゴリズム、データ処理、ローカルファーストの手法に面白いところがある。
謝辞:文は Tatoeba、CC-CEDICT は MDBG、HSK 3.0 のリストは elkmovie、Unihan は Unicode Consortium に。
自分で試す
hanzi.brianhliou.com から始められる。
- 字体と HSK レベルを選ぶ
- 声調番号付きでピンインを入力する(
wo3、ni3、ta1) - 統計ページで進捗を確認する
- 毎日練習し、習熟度が上がるのを見る
ソースは MIT ライセンスで GitHub にある。クローンしてローカルで実行する:
git clone https://github.com/brianhliou/hanzi-flow.git
cd hanzi-flow/app
npm install
npm run dev
http://localhost:3000 を開く。