aide:測量 AI 編碼工作階段
簡而言之
- aide 把 Claude Code 與 Codex 的工作階段日誌讀入 SQLite,跨所有專案回報成本、token,以及工作階段出錯的地方。
- 它以 30 分鐘的閒置間隔把工作階段切成工作區塊,因為開著兩天的終端機並不是一個 48 小時的工作階段。
- 重複出現的發現會變成建議的操作手冊與工作階段簡報,你接受之後它們才會進入未來的工作階段。
- 它不呼叫任何 LLM,執行起來零成本,所有東西都留在本機。
METR 研究發現開發者相信 AI 讓他們快了 20%。實測結果:慢了 19%。我想要自己使用情形的資料,於是做了一個本機效能工具。
這是什麼
aide 把 Claude Code 與 Codex 的工作階段日誌(JSONL)匯入 SQLite,並顯示各專案的狀況:成本、token 使用量、工作階段模式、效能趨勢、審查佇列,以及反覆出現的工作流程摩擦。
它也會把重複出現的發現轉成建議的專案知識。你先審查並接受這些產出,它們才會成為未來由人或代理進行工作時的操作手冊或開場簡報。
零 LLM 呼叫。零執行成本。所有資料都留在本機。
~/.claude/projects/**/*.jsonl → Claude parser → SQLite → aide
~/.codex/sessions/**/*.jsonl  → Codex parser  → SQLite → aide
問題所在
Claude Code 與 Codex 會產生詳盡的本機日誌:訊息、工具呼叫、token 計數、時間戳記、命令與中介資料。這些檔案就放在 ~/.claude/projects/ 和 ~/.codex/sessions/ 底下。沒人去看。
每個人對 AI 編碼工具值不值得都有看法。沒人有資料。我隨著時間有變得更有效率嗎?哪些專案吃掉最多 token?工作階段反覆在哪裡出錯?更好的指示或操作手冊真的減少了摩擦嗎?
有用的視角是跨越你所有工作階段的個人趨勢,再加上一個把重複錯誤轉成更好的未來脈絡的回饋循環。單一份工作階段紀錄兩者都看不出來。
運作方式
資料管線
- 探索 - 找出已設定的 Claude 與 Codex JSONL 來源
- 解析 - 把各供應商特有的事件正規化成同一個工作階段模型
- 工作區塊 - 以 30 分鐘閒置間隔把每個工作階段切成連續的編碼時段
- 匯入 - 以增量方式 upsert 進 SQLite,並追蹤檔案的 mtime
- 審查循環 - 為可疑的工作階段排序、把重複原因分組,並提出可供審查的產出
成本估算
所有成本都依目前 API 費率估算。訂閱使用者(Pro/Max)可以切換開關,改為顯示以 token 為基礎的指標,而非金額。
主要功能
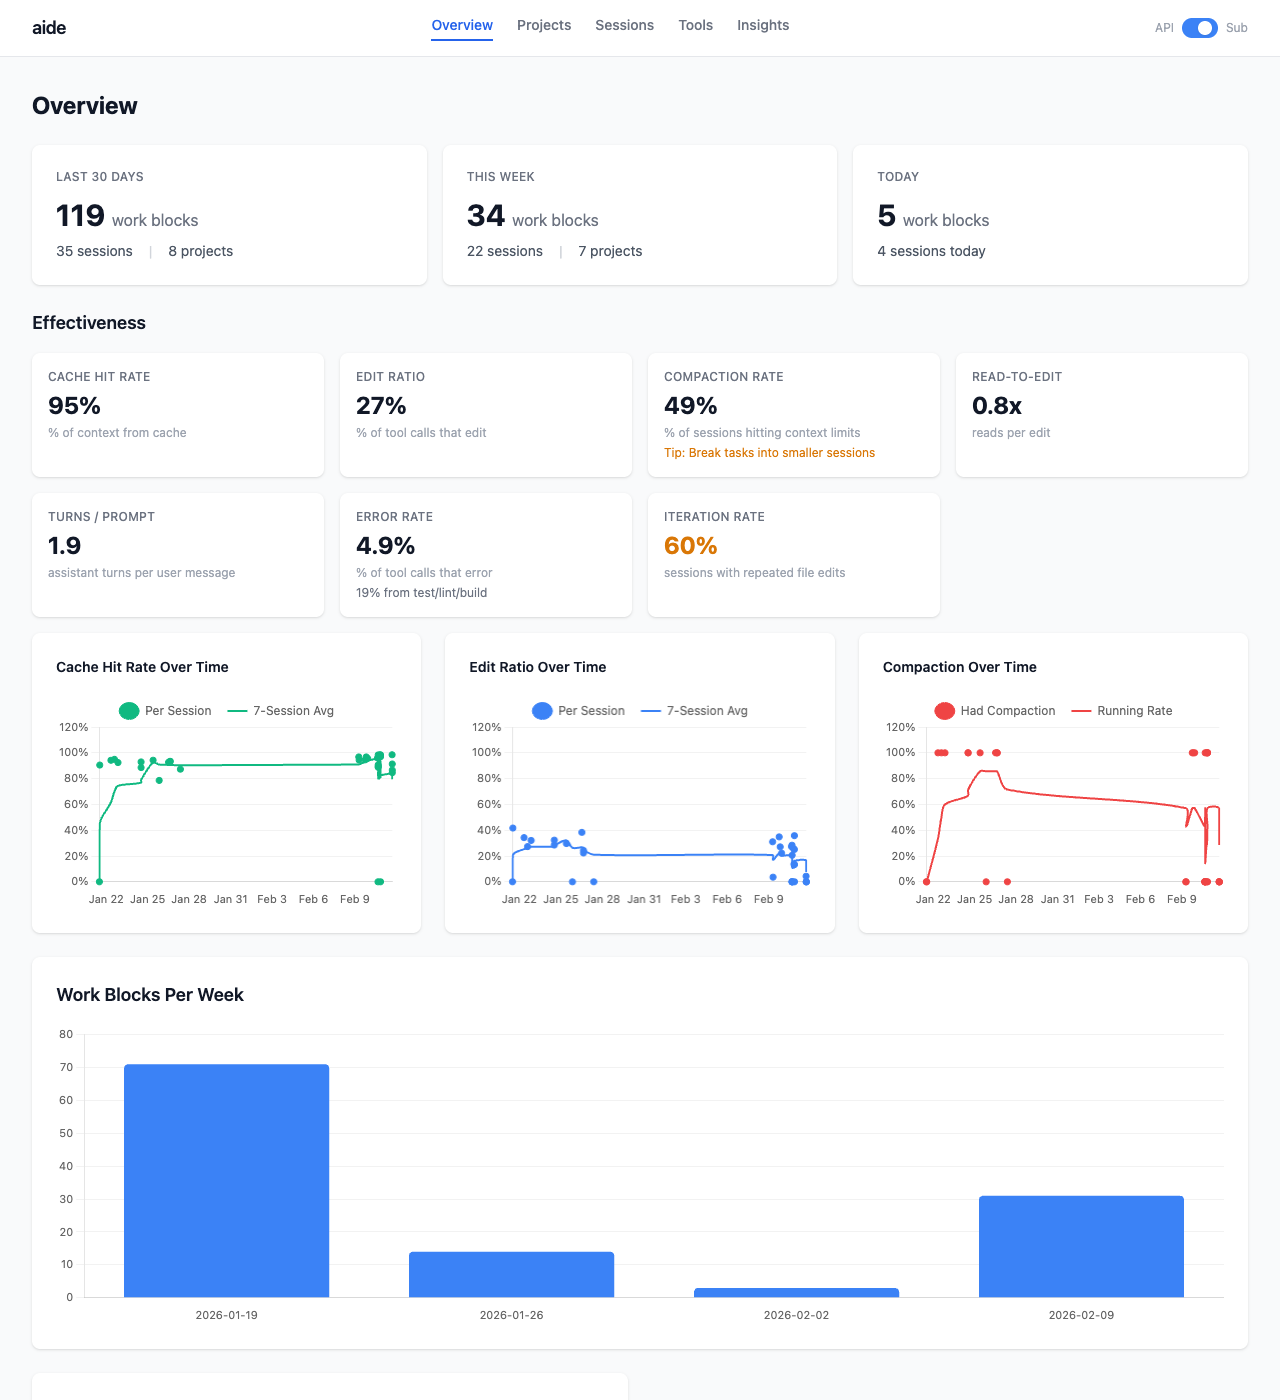
總覽儀表板
摘要卡片、效能指標(快取命中率、編輯比率、壓縮率、錯誤率)、趨勢圖表、每週工作區塊數。
效能
專案與供應商層級的彙總會把最近 30 天和前 30 天相比:每個工作階段的平均成本、活躍時間、審查佇列比率、編輯歸屬,以及工具錯誤率。
行動摘要會把反覆出現的調查訊號分組,例如沒有編輯的工作、專案歸屬薄弱、缺少前綴規則,以及編輯歸屬缺口。每個行動都會連回造成它的工作階段。
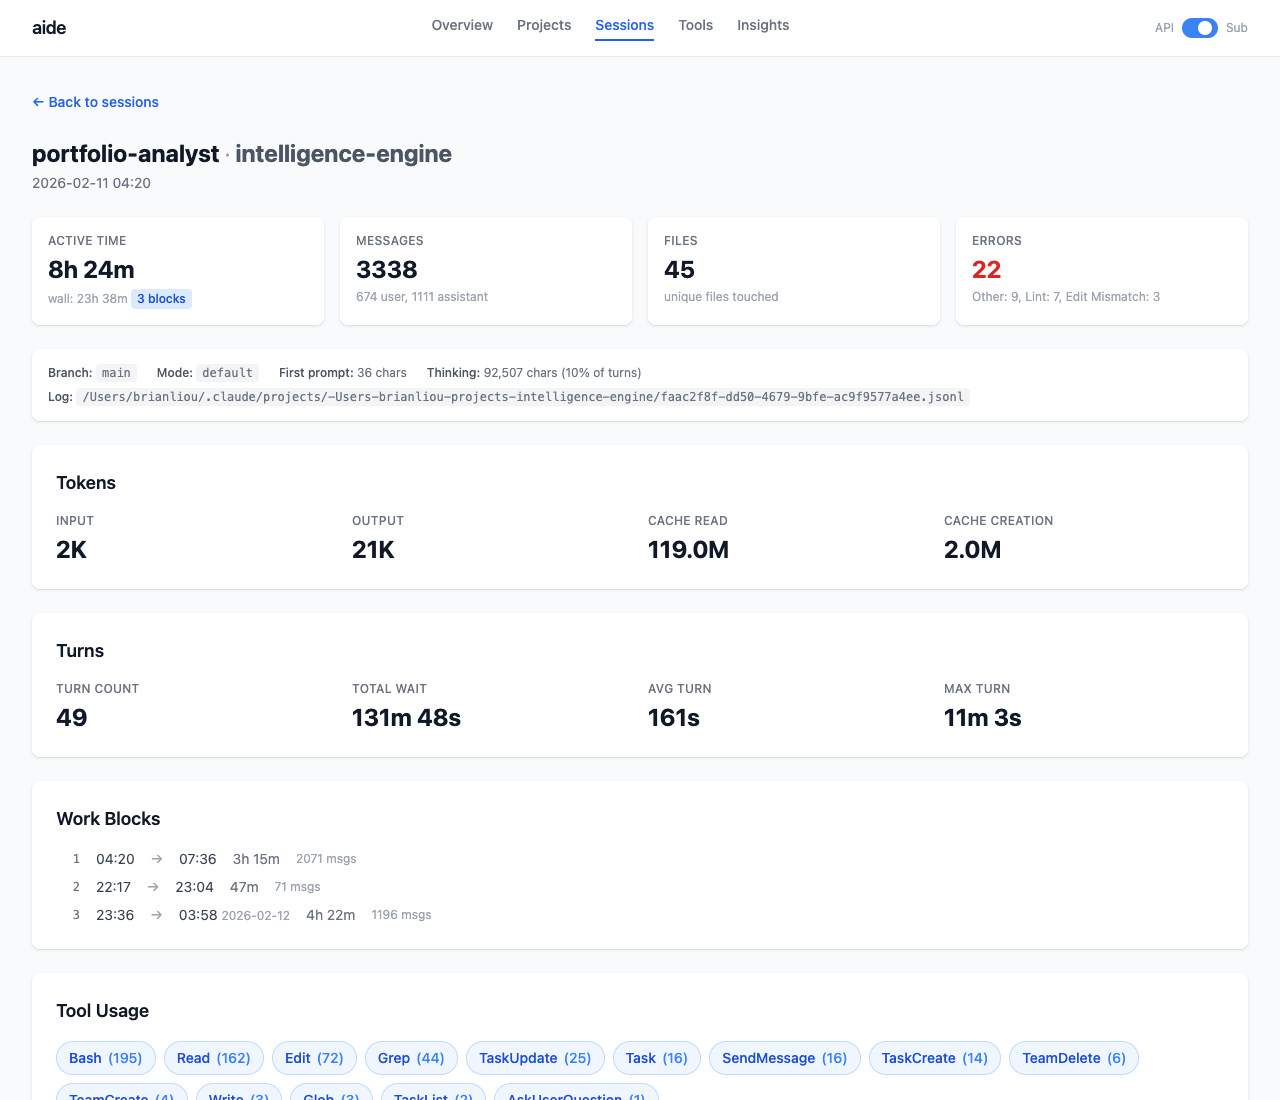
工作階段細節
深入查看任一工作階段:token 分解、工具使用、觸及檔案及其讀取/編輯/寫入次數、工作區塊時間軸、錯誤分類。
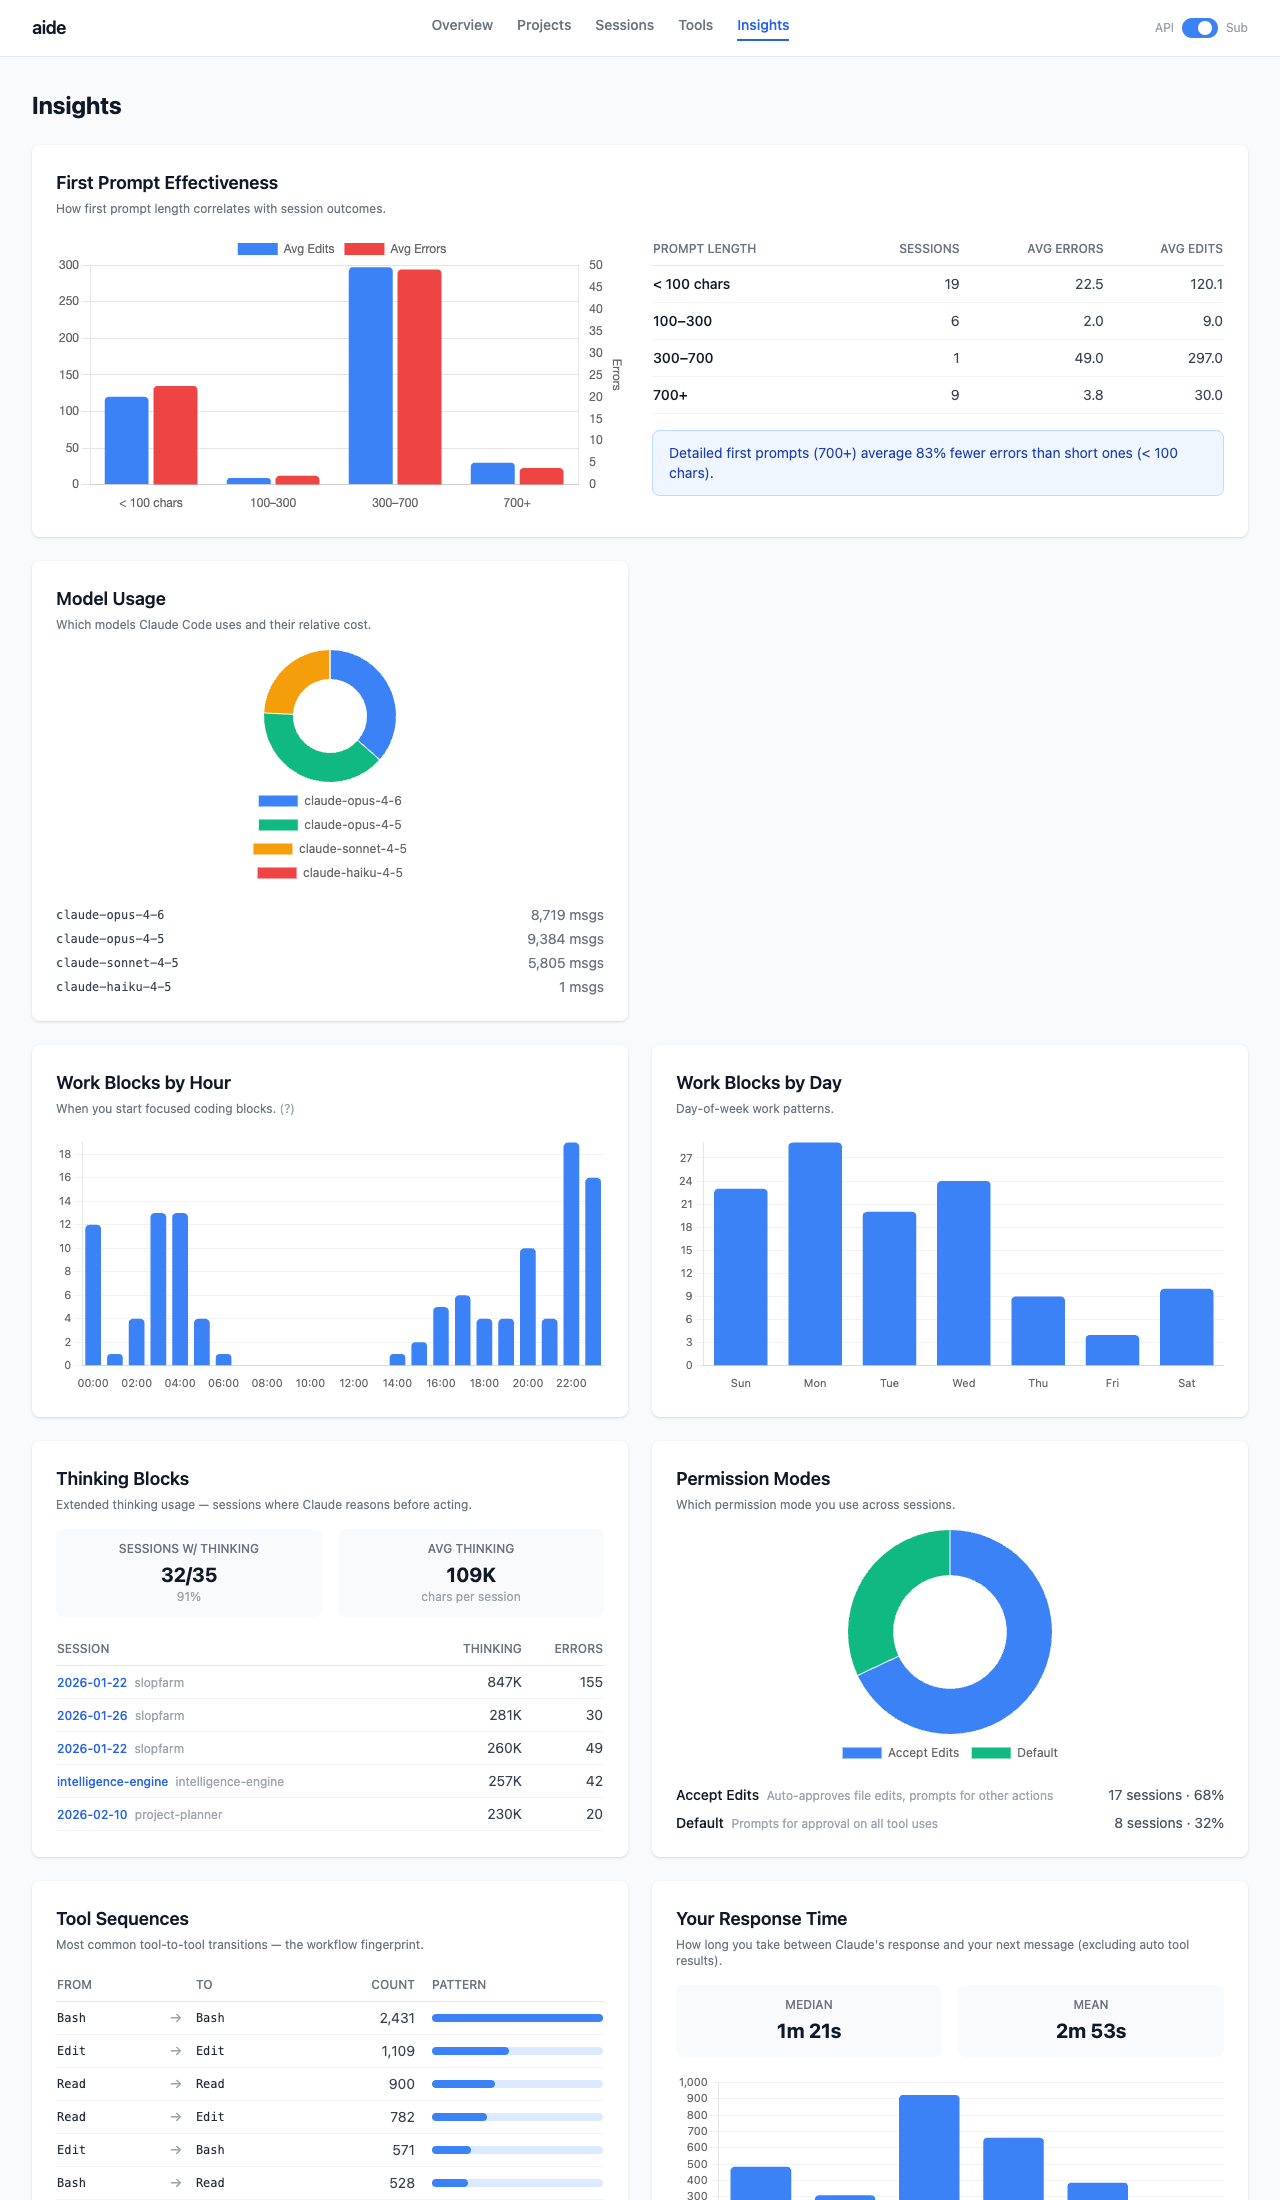
洞見
首個提示的效果、成本集中度、時間模式、模型使用情形、工具序列、思考區塊分析、權限摩擦,以及調查行動。
更多
- 工作階段解剖 -
aide autopsy <session-id>會產生單一工作階段的診斷報告:成本分解、脈絡視窗分析、壓縮偵測,以及專案指示的改進建議。 - 產出審查 - 重複出現的發現會變成建議的語意產出。接受的產出會餵進操作手冊與任務簡報。
- 訂閱模式 - 為 Pro/Max 訂閱者在 API 成本檢視與以 token 為基礎的指標之間切換。
- CLI 統計 -
aide stats會直接在終端機印出快速摘要,不需開啟網頁瀏覽器。
技術細節
工作區塊
JSONL 裡的「工作階段」只是一個終端機視窗一直開著而已。一個從週一橫跨到週三、中間還睡了覺的工作階段,會被讀成一個 48 小時的工作階段,讓「持續時間」變得毫無意義。
訊息之間的間隔分佈是雙峰的:大多數間隔在 5 分鐘以內(活躍工作),另有一小群超過 30 分鐘(離開)。以 30 分鐘為門檻可以乾淨地把這兩個峰分開。
每個工作階段會切成工作區塊,也就是連續的編碼時段。「35 個工作階段中共 119 個工作區塊」比「35 個工作階段」告訴你的更多。
錯誤分類
工具錯誤會自動分類:測試(pytest、jest)、Lint(ruff、eslint)、建置(pip、npm)、Git、編輯不符、檔案存取。多數「錯誤」其實是正常的迭代(編輯-測試-修正循環中的測試失敗)。儀表板會把迭代和真正的錯誤分開。
效能指標
- 快取命中率 - 由快取提供的輸入脈絡百分比(越高=重用越好)
- 編輯比率 - 屬於檔案編輯的工具呼叫百分比(越高=越有生產力)
- 壓縮率 - 觸及脈絡上限的工作階段百分比
- 讀取與編輯之比 - 每次編輯的讀取次數(越低=翻找越少)
- 迭代率 - 有檔案被編輯 3 次以上的工作階段
- 審查率 - 近期工作階段中值得人工審查的百分比
- 編輯歸屬 - 能對應到檔案路徑的編輯/寫入呼叫百分比
AI 編碼日誌是一座金礦。 每一次工具呼叫、token 計數、時間戳記與命令形態都在裡面。難的是決定哪些指標真的重要。
工作區塊改變了一切。 原始的工作階段持續時間讓每張圖表都失真。在閒置間隔處切分讓資料變得誠實。資料清理比花俏的視覺化重要得多。
零 LLM 呼叫是正確的限制。 每個指標都是啟發式的。沒有 API 呼叫,沒有邊際成本。你想重新匯入、重新建立幾次都可以。
技術堆疊
- Python 3.12+ 搭配 Click CLI
- Flask + Jinja2 樣板
- Chart.js(CDN)用於互動圖表
- Tailwind CSS(CDN)用於樣式
- SQLite(標準函式庫)用於儲存
- uv 用於套件管理