aide:量化 AI 编程会话
简而言之
- aide 把 Claude Code 与 Codex 的会话日志读入 SQLite,跨全部项目汇报成本、token 以及会话在哪里出了问题。
- 它以 30 分钟空闲间隔为界把会话切分成工作块,因为一个开着两天的终端窗口并不等于一场 48 小时的会话。
- 反复出现的结论会变成建议的操作手册和会话简报,你确认接受后它们才会进入后续会话。
- 它不发起任何 LLM 调用,运行零成本,所有数据都留在本地。
METR 的研究发现,开发者认为 AI 让自己快了 20%。实测结果:慢了 19%。我想拿到自己使用情况的数据,于是做了一个本地效能工具。
这是什么
aide 把 Claude Code 与 Codex 的会话日志(JSONL)导入 SQLite,展示各个项目中正在发生的事:成本、token 用量、会话模式、效能趋势、复核队列,以及反复出现的工作流摩擦。
它还会把反复出现的结论转化为建议的项目知识。这些产物要经你复核并接受,才会成为后续人类或智能体工作的操作手册或开场会话简报。
零 LLM 调用。零运行成本。所有数据都留在本地。
~/.claude/projects/**/*.jsonl → Claude parser → SQLite → aide
~/.codex/sessions/**/*.jsonl  → Codex parser  → SQLite → aide
问题所在
Claude Code 和 Codex 会生成详细的本地日志:消息、工具调用、token 计数、时间戳、命令和元数据。文件就放在 ~/.claude/projects/ 和 ~/.codex/sessions/ 下面。没人去看它们。
关于 AI 编程工具值不值,每个人都有看法。但没人有数据。我随着时间变得更高效了吗?哪些项目吃掉了最多 token?会话总是在哪里出问题?一条更好的指令或操作手册是否真的减少了摩擦?
真正有用的视角是你全部会话上的个人趋势,再加上一个把重复错误转化为更好的后续上下文的反馈闭环。单份会话记录两者都给不了。
工作原理
数据流水线
- 发现 - 找到已配置的 Claude 和 Codex JSONL 数据源
- 解析 - 把各家特有的事件归一化成统一的会话模型
- 工作块 - 以 30 分钟空闲间隔为界,把每场会话切分成连续的编程时段
- 导入 - 以增量方式 upsert 进 SQLite,跟踪文件的 mtime
- 复核闭环 - 给可疑会话排序,归并重复成因,并提出可复核的产物
成本估算
所有成本均按当前 API 价格估算。订阅用户(Pro/Max)可以切换开关,改为显示基于 token 的指标,而不是金额。
主要功能
总览仪表盘
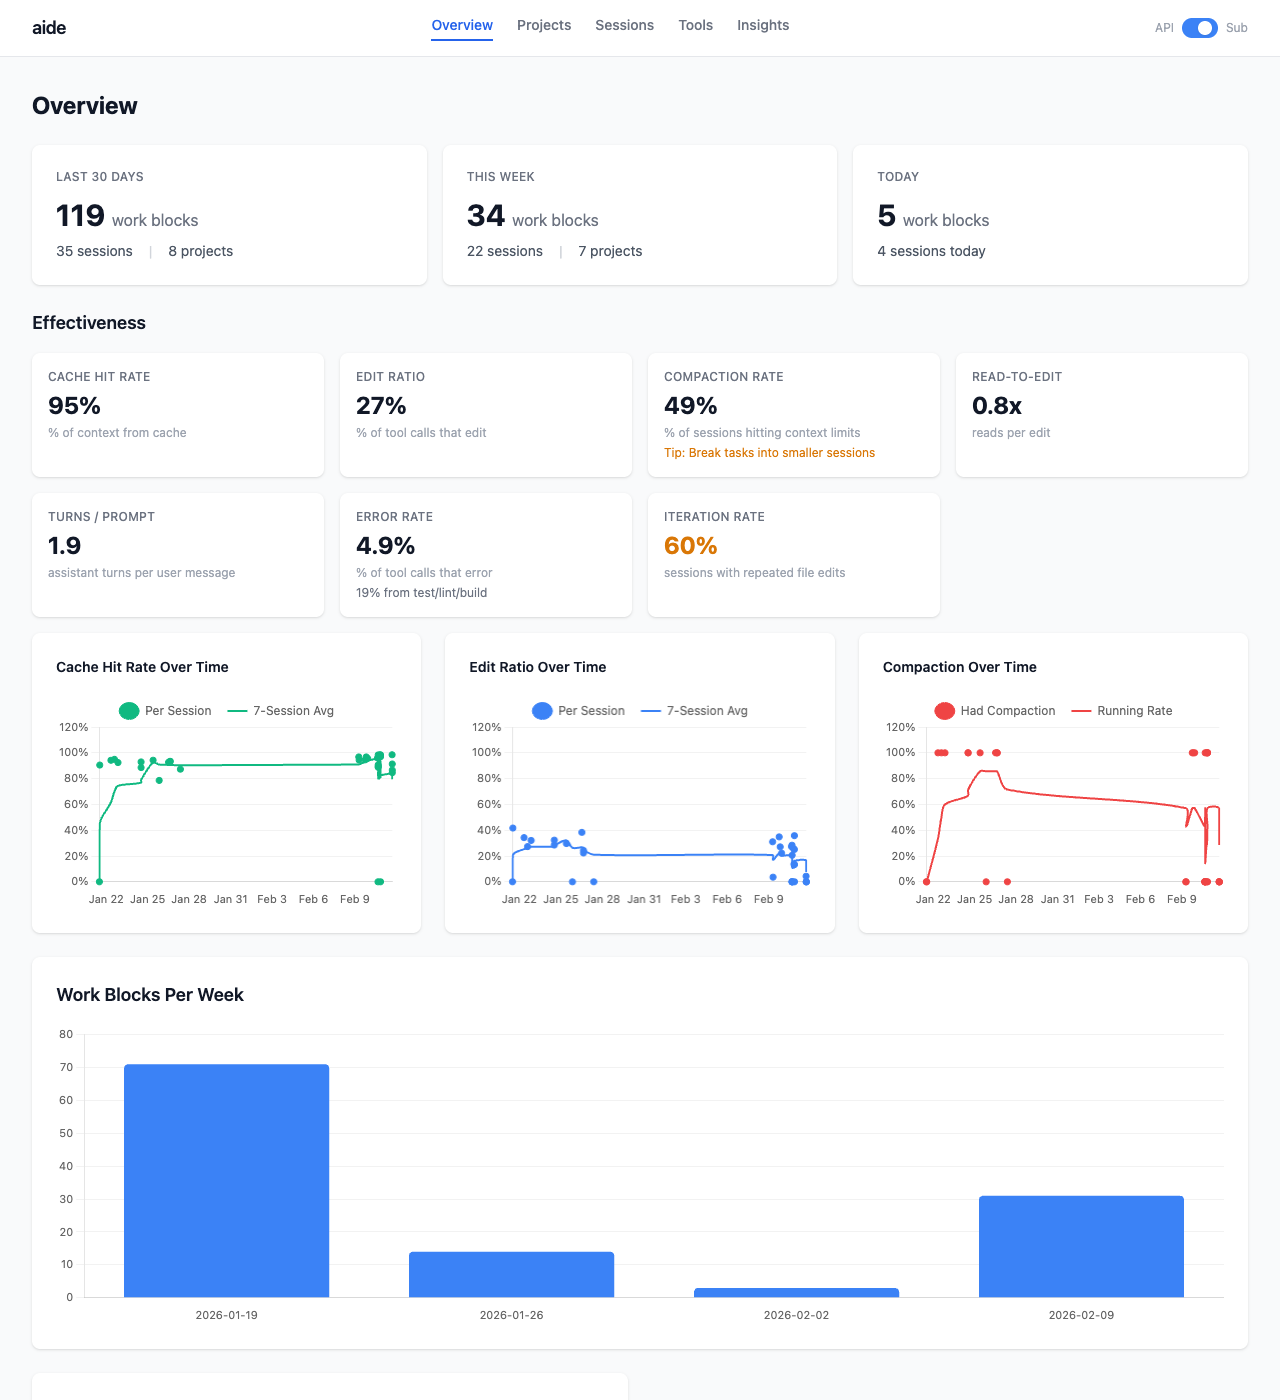
概要卡片、效能指标(缓存命中率、编辑占比、压缩率、错误率)、趋势图表、每周工作块数量。
效能
按项目和按提供方的汇总会把最近 30 天与前 30 天对比:每场会话平均成本、活跃时间、复核队列比例、编辑归因和工具错误率。
行动概要会归并反复出现的排查信号,例如无编辑的工作、项目归因薄弱、缺少前缀规则、编辑归因缺口。每项行动都能链回引发它的那些会话。
会话详情
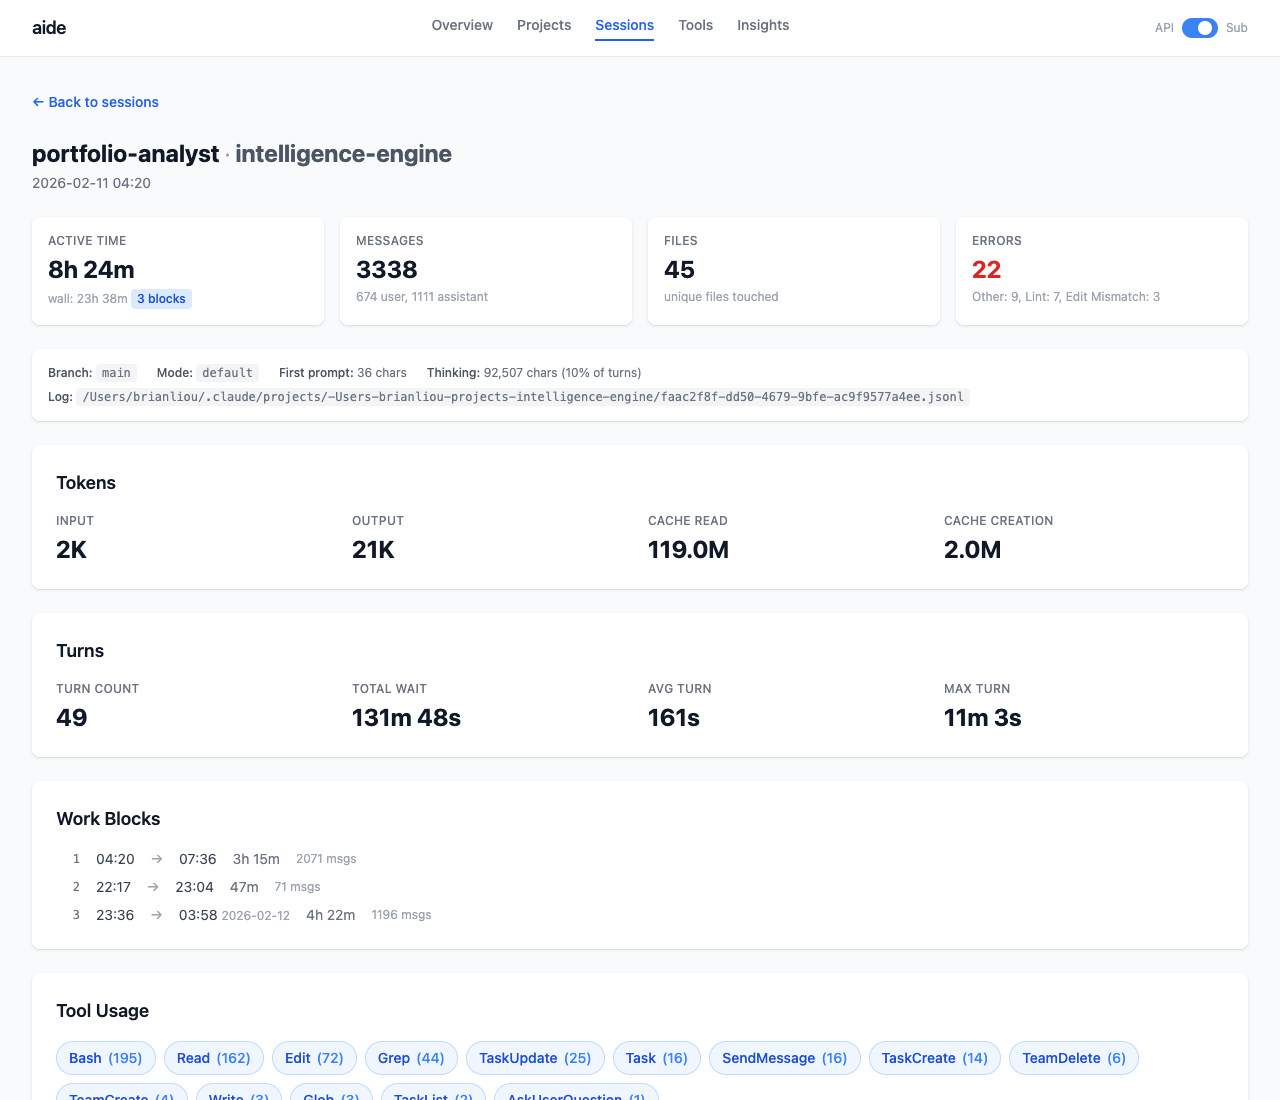
深入任意一场会话:token 明细、工具使用、涉及文件及其读取/编辑/写入次数、工作块时间线、错误分类。
洞察
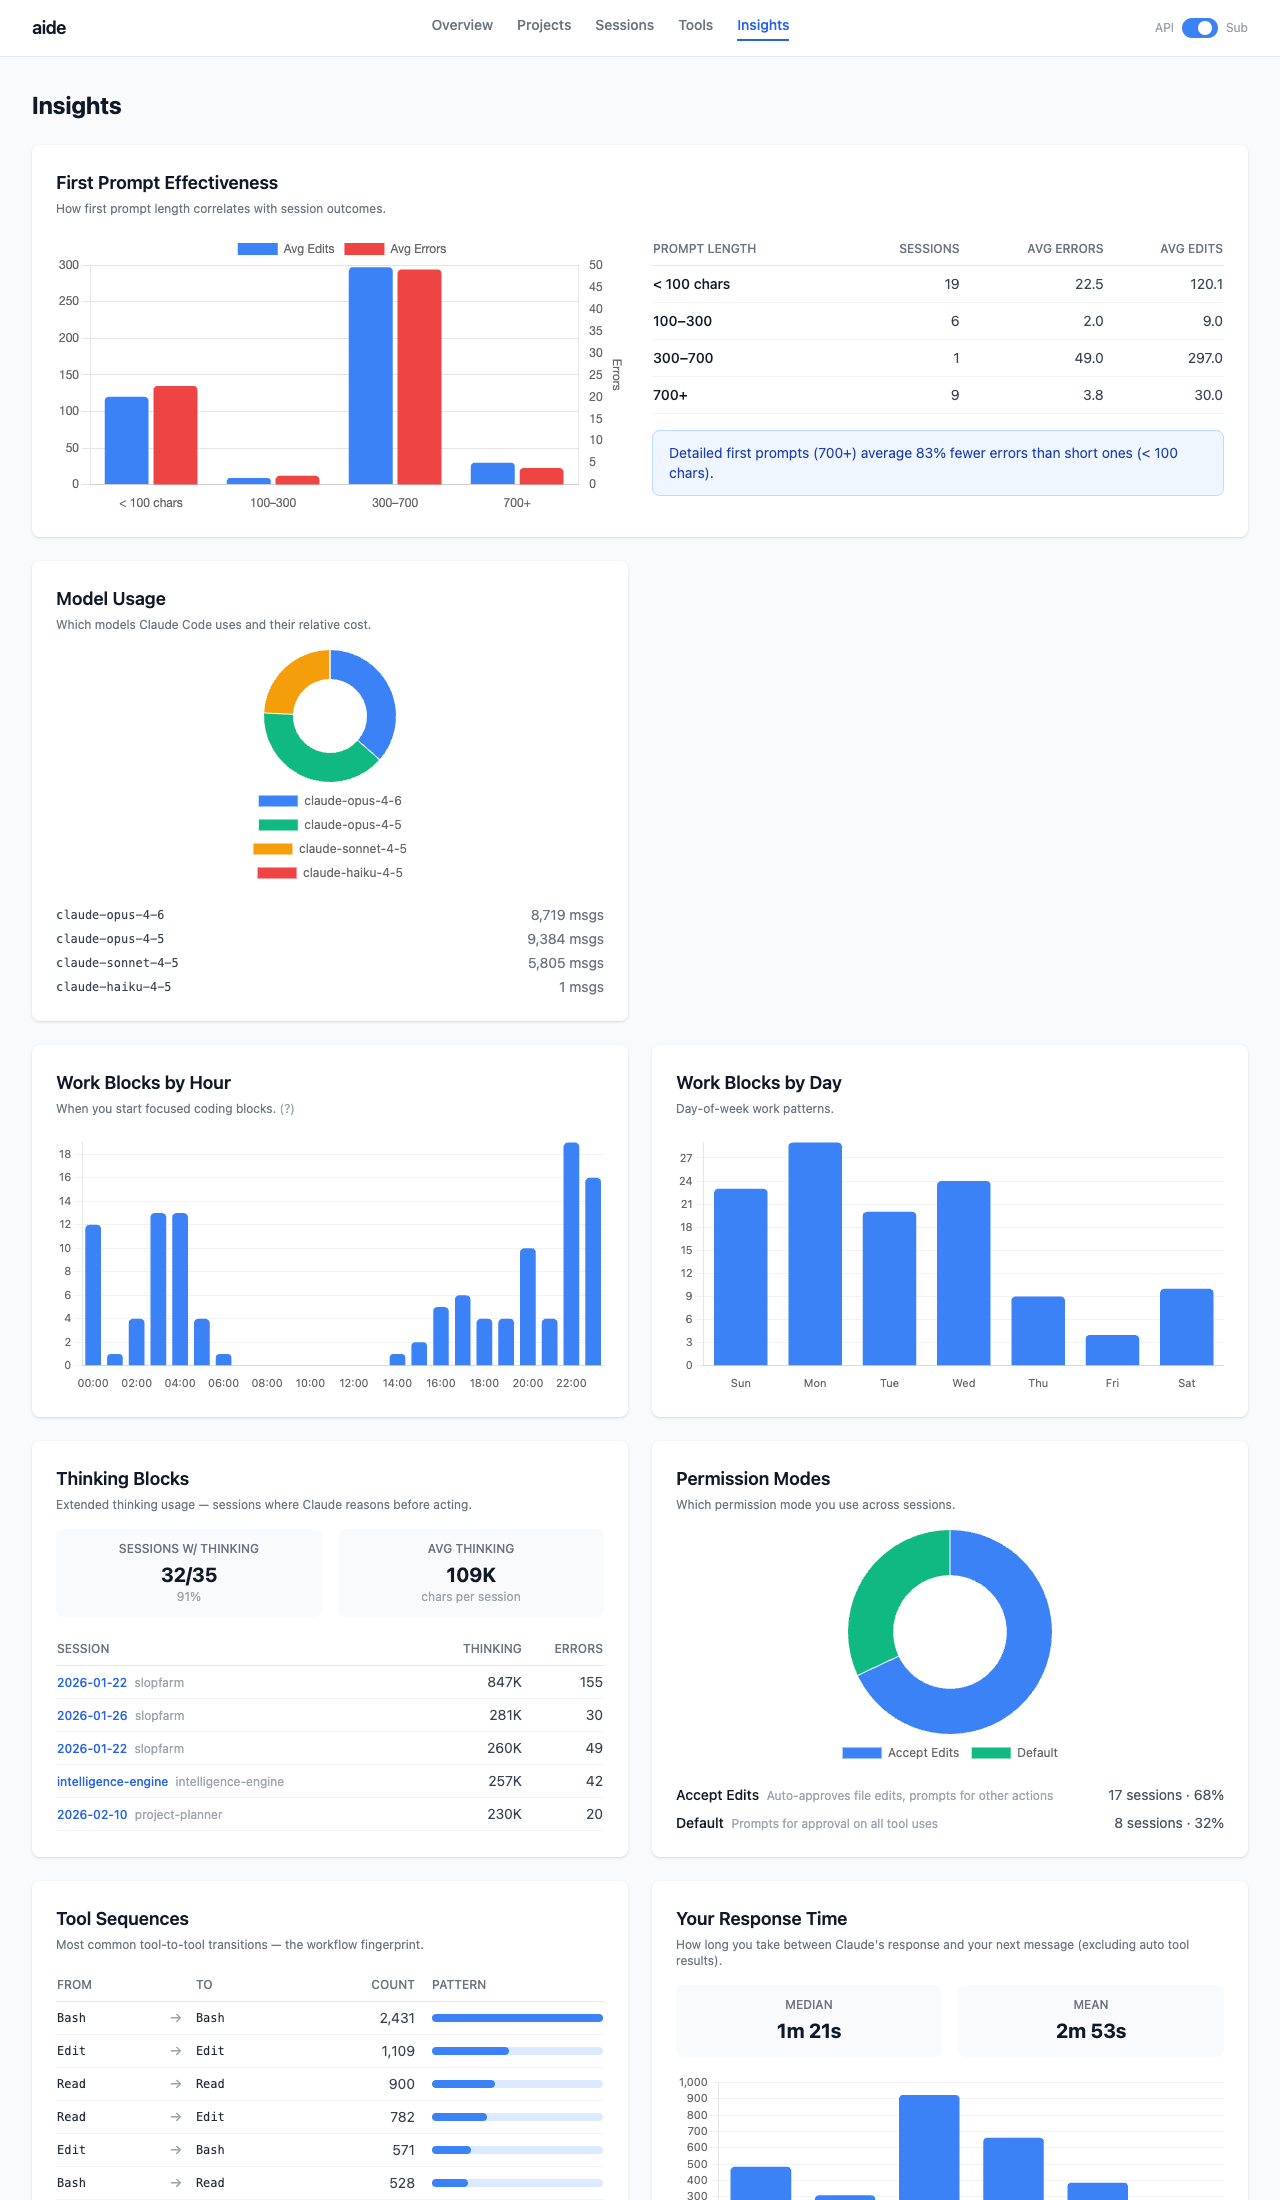
首条提示的效果、成本集中度、时间模式、模型使用、工具序列、思考块分析、权限摩擦以及排查行动。
更多
- 会话复盘 -
aide autopsy <session-id>会生成单场会话的诊断报告:成本明细、上下文窗口分析、压缩检测,以及项目指令的改进建议。 - 产物复核 - 反复出现的结论会变成建议的语义产物。被接受的产物会汇入操作手册和任务简报。
- 订阅模式 - 在 API 成本视图和面向 Pro/Max 订阅者的 token 指标之间切换。
- 命令行统计 -
aide stats直接在终端打印一份快速概要,无需打开网页浏览器。
技术细节
工作块
JSONL 里的一场「会话」只是一个终端窗口一直开着而已。一场从周一横跨到周三、中间还睡了觉的会话,会被读成 48 小时的会话,「时长」也就毫无意义了。
消息之间的间隔分布是双峰的:大多数间隔不到 5 分钟(活跃工作),另有一小簇超过 30 分钟(离开)。30 分钟的阈值能干净地把两个峰分开。
每场会话都被切分成工作块,也就是连续的编程时段。「35 场会话里有 119 个工作块」比「35 场会话」告诉你的更多。
错误分类
工具错误会被自动归类:测试(pytest、jest)、静态检查(ruff、eslint)、构建(pip、npm)、Git、编辑不匹配、文件访问。多数「错误」其实是正常迭代(编辑-测试-修复循环中的测试失败)。仪表盘会把迭代和真正的错误区分开。
效能指标
- 缓存命中率 - 输入上下文中由缓存提供的比例(越高 = 复用越好)
- 编辑占比 - 工具调用中属于文件编辑的比例(越高 = 产出越多)
- 压缩率 - 触及上下文上限的会话比例
- 读取与编辑之比 - 每次编辑对应的读取次数(越低 = 搜索越少)
- 迭代率 - 存在文件被编辑 3 次以上的会话比例
- 复核率 - 近期会话中值得人工复核的比例
- 编辑归因 - 编辑/写入调用中能关联到具体文件路径的比例
AI 编程日志是一座金矿。 每一次工具调用、token 计数、时间戳和命令形态都在里面。难的是判断哪些指标真正重要。
工作块改变了一切。 原始的会话时长让每张图表都产生误导。按空闲间隔切分后,数据才诚实起来。数据清洗比花哨的可视化更重要。
零 LLM 调用是正确的约束。 每个指标都是启发式的。没有 API 调用,没有边际成本。想重新导入、重新构建多少次都行。
技术栈
- Python 3.12+,配合 Click 命令行
- Flask + Jinja2 模板
- Chart.js(CDN)用于交互式图表
- Tailwind CSS(CDN)用于样式
- SQLite(标准库)用于存储
- uv 用于包管理