在鬥獸棋引擎中測試「奔穴競速」評估項
簡而言之
- Mistboard 的鬥獸棋引擎完全沒有奔穴競速的概念,於是我試了三種方式教它。三種結果都是無效或負向。
- 在出貨強度下,奔穴競速只決定 4.7% 的對局(弱搜尋測試給出 22%),而搜尋深度提高 12 倍,也只是提早兩著看出敗勢。
- 獸穴附近的搜尋延伸看起來有 +45 Elo,直到我把節點預算固定下來;此時它變成略為負向。專門的奔穴競速評估項則是無效。
- 要固定預算,否則你量到的只是預算本身。反倒是從同一批對局裡找出的兩個常數,和棋計數器與和棋輕視值,讓有勝負對局的比例翻倍。
Mistboard 的鬥獸棋引擎沒有奔穴競速的概念。它以子力加上每個棋子朝敵方獸穴推進的獎勵來評估局面,從不去問那個衝向自己獸穴的跑者是不是先到。它要等搜尋抵達獸穴時才知道,大約在十二著之外。
這看起來是個明顯的缺口,在一局機器人把鼠子來回挪動、而敵方鼠子走進獸穴的對局之後,我把它記成了一個 issue。我花了一天試著補上它。三條路線,全部無效或負向。以下是量測結果,以及我會從中留下什麼。
引擎本來就會做的事
值得分開來講,因為它決定了後面的一切。引擎對取勝條件的理解是完整的:抵達獸穴被評為將死,在候選著法中排在第一位,也會在靜態搜尋中被搜到。它缺的是預見,不是理解。
它反正還是會贏,因為鬥獸棋由子力主導,而評估值精確地讀出子力。在進入獸穴的那一刻,勝方的中位數領先 20 分,大約一隻貓。只有 4.7% 的對局是由落後的一方取勝。
沒有這個概念時它會怎麼下
研究中的第 10 局只有四著長,卻比下面任何表格都更能說明問題。
鬥獸棋的中路是三列水域。d 路是唯一跨越它的陸橋。在這些對局進行時 Mistboard 採用的規則下,虎只能沿縱向跳水,不能橫向跳,因此站在那條走廊裡的虎幾乎無處可去。(自 2026 年 9 月起,虎也能像獅一樣橫向跳水,依循中國的規則版本;那條走廊對它已不再是陷阱,下面這條變化是舊規則下的變化。)
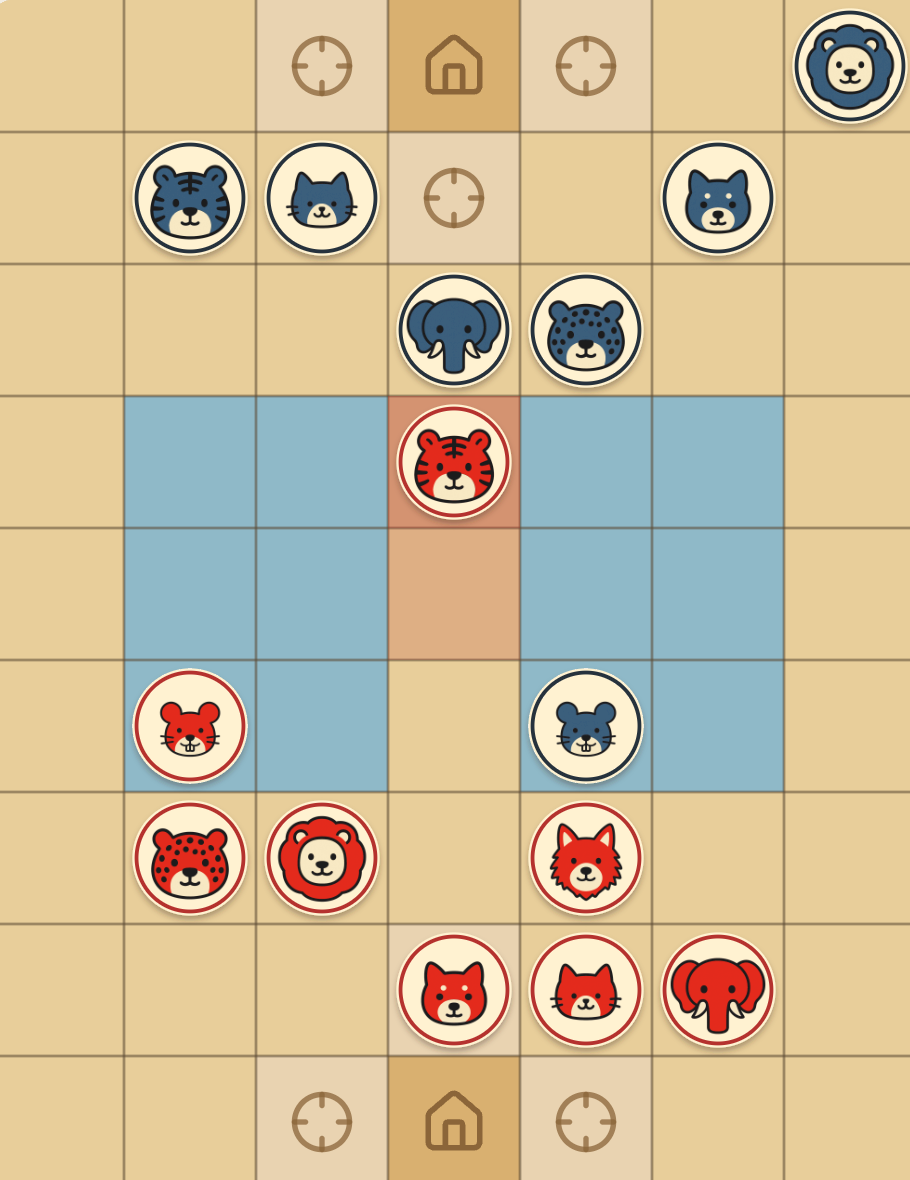 第 20 著,藍方行棋。紅色格子是剛走的一著:紅方的虎在 d6 吃掉一隻狼,現在站在走廊裡。藍方的象就在它上方一格,位階高於它。 在第 20 著,紅方位於 d5 的虎有兩個合法著法。向前或向後,都還在走廊裡。它往前吃掉了狼,讓藍方損失 40 分,並把虎停在藍方象的旁邊。
藍方的象位階高於虎,所以這看起來像是送禮。藍方沒有立刻吃掉它,而這正是別人要我解釋的一著。引擎的理由是那隻虎逃不掉:象在 d7 時,虎唯一的著法是 d5,而從 d5 唯一的著法是 d4,被一個能吃掉它的棋子沿著單線走廊一路趕下去。馬上吃掉它,等於花一個先手去收一個已經收下的東西。藍方走了一步免費的改善著法,兩著之後才吃掉虎,地點在 d5 而不是 d6。兩條變化到達的子力完全相同。
決定這局勝負的四著:
41  Blue  elephant d7 -> d6    steps into the corridor after the tiger
42  Red   lion     c3 -> c7    jumps into the square the elephant just left
43  Blue  elephant d6 -> d5    takes the tiger, up a piece
    Red's lion is now three moves from a den Blue cannot defend
那隻虎是誘餌。不是棄子:它反正幾乎已被困住,而吃狼得 +10 分,幾乎所有其他選擇都是 +6,差距只有四分,而不是一套計畫。它在離開棋盤的路上做到的,是把唯一位階高於獅的棋子拉到 d 路下方。在第 20 著,獅的跳躍評估為 -195,因為 c7 緊鄰藍方在 d7 的象。兩著之後,同樣的跳躍就取勝了,因為象走開了。
藍方在這段變化結束時領先 13 分,然後輸了。
把這套計畫回述一遍,聽起來像引擎理解了奔穴競速。它並沒有。在那套評估裡,這個專案前後都不存在任何奔穴競速評估項。它搜了五百萬個節點,這條變化就出來了。整個結果就是這樣:那個 issue 想裝進去的行為本來就在,是由深度而不是知識產生的。
基準比率:4.7% 的對局,而且要在出貨強度下量測
以每著五百萬節點的生產預算進行的 172 局自我對弈。
| 終局方式 | 比例 |
|---|---|
| 重複局面和棋 | 52.9% |
| 進入獸穴 | 26.2% |
| 無進展和棋 | 20.9% |
| 真正的競速(勝方在十著之前仍持平或落後) | 4.7% |
同一套測試架構在 200k 節點下報告 22% 是競速。棋力較弱會把這個數字誇大約五倍。便宜的量測方法本來就有,而它會在「讓人覺得值得多做事」的方向上錯了 5 倍。
餘裕:搜尋深度提高 12 倍只換到兩著
對每一場競速,我在敗方的對局裡用二分搜尋找出每個預算最早能辨認出必敗的那一著,再取兩者的差距。
| 差距 | 競速局數 |
|---|---|
| 0 著 | 4 |
| 2 著 | 3 |
| 4 著 | 1 |
六千萬節點對上五百萬節點,較深的搜尋看出敗勢的時間中位數只早了兩著。在那個視界之前,兩者走勢相當接近,只在最後一兩著才分歧。
這就是應該讓這個專案終止的數字。如果十二倍的搜尋只換回兩著,那些資訊就不是擺在那裡等著更聰明的評估去挖出來。
路線 A:搜尋延伸,免費版與付費版
不用實作就能先探測。測試架構的一項策略是:只要有棋子位於敵方獸穴 R 格之內,就給該方更大的節點預算,這是任何真實延伸的嚴格上界。
在算任何 Elo 之前的第一個發現:觸發條件並不稀疏。
| 半徑 | 觸發的著數比例 |
|---|---|
| 2 | 23% |
| 3 | 43% |
| 4 | 72% |
鬥獸棋的棋盤很小,獸穴又在底線。在 R=4,也就是要及早看出競速所需的半徑下,這個延伸其實就是「到處都搜十二倍」,所以「精準手術」這個框架從一開始就錯了。
在 R=2、每組 300 對換色對局的條件下:
| 組別 | Elo | 節點數與對照組之比 |
|---|---|---|
| 獸穴附近 12 倍深度,免費給予 | +45 | 3.3x |
| 預算中性,基礎 3.7M + 獸穴附近 10M | -15 | 1.04x |
| 預算中性,基礎 1.1M + 獸穴附近 20M | -12 | 0.98x |
同一個想法、同一份程式碼,符號相反。引擎的五百萬節點是由玩家願意等多久決定的,所以真實的延伸無法憑空變出深度:它只能從搜尋的其他部分拿。免費那組量到的是額外的運算量,跟獸穴毫無關係。
我跑了預算中性那組,是因為 +45 看起來好得不像真的。若停在那裡,就會為一個價值略低於零的功能買下一週的工作量。
兩組都只花了一個下午,因為兩者都不需要動引擎。那個延伸只是測試架構裡依棋盤條件調整節點預算的一項策略。對任何形如「讓它對 X 更聰明」的提案,先免費給它完美的 X,是判斷 X 到底有沒有關係最便宜的方法。
路線 B:評估項本身
我還是做了,因為延伸失敗的理由並不適用於評估項。延伸要花節點;評估項在每個葉節點幾乎不花成本。
這是當時的評估函式。在棋盤上跑一圈,每個棋子各自獨立貢獻:
for idx in 0..N {
    let v = VAL[role_of(code) as usize];
    let friendly = color_of(code) == me;
    s += if friendly { 2 * v } else { -2 * v };

    // Advancement toward the relevant den: the enemy's for our pieces, ours for theirs.
    let target = if friendly { enemy_den } else { own_den };
    let dist = manhattan(idx as u8, target);
    let advance = if dist <= 1 { 400 } else { (16 - dist) * 3 };
    s += if friendly { advance } else { -advance };
}
那個推進項就是評估對競速視而不見的原因,而原因在於對稱性。我的跑者離你的獸穴三格是 +39。你的跑者離我的獸穴三格是 -39。雙方都在衝刺時算出來接近零,於是局面在最已成定局的那一刻讀起來一片平靜。
所以這個評估項不能是另一個逐棋子的獎勵。它必須是每方一個判定,只算一次,並把兩個跑者互相比較:
for side in [me, 1 - me] {
    // Nearest enemy runner to this side's den, and this side's nearest defender
    // to its own trap ring.
    let (mut att, mut def) = (99, 99);
    for idx in 0..N { /* ...scan once... */ }

    if att > RACE_RADIUS { continue; }   // no race here: contribute nothing

    // The side to move gets one free step in the race for its own den.
    let margin = att - def + i32::from(side == me);
    let pen = if margin <= 0 { RACE_LOST }
              else if margin == 1 { RACE_TIGHT }
              else { 0 };
    score += if side == me { -pen } else { pen };
}
防守方的距離是量到陷阱環,而不是量到獸穴。那才是正確的攔截區,因為獸穴的三個鄰格就是它的三個陷阱,而站在陷阱上的棋子可以被任何防守方吃掉,不論位階。走進你獸穴的象必須經過一格,讓你的鼠可以吃掉它。
在它原本針對的局面中,它改變了 17% 的選著,並在節點數相同時多花約 17% 的實際耗時。在每個權重 300 對換色對局、且尚未計入該成本的情況下:
| 權重 | Elo |
|---|---|
| 10 | -3 |
| 25 | +9 |
無效,而且是在對它有利的方向上。
我會留下的東西
固定預算,否則你量到的只是預算。實驗的免費版本是最方便做的那個,而它會遞給你一個自信的正數。這個改動必須從哪裡挪資源,就從那裡挪,再看結果是否還撐得住。
這個陷阱一天之內抓到我兩次。同一個下午的一次輕視值掃描顯示有勝負的對局從 32% 升到 50%,但這本來就是提高輕視值在結構上必然產生的結果,因為自我對弈掃描中雙方都用了同樣的設定。只有讓兩個數值互相對抗,才能看出它有沒有代價。結果沒有,所以那一項出貨了。
評估上的缺口是真的,診斷也正確。只是它背後什麼都沒有。從同一批對局中找到的兩個常數,一個是讓對局過早結束的無吃子和棋計數器,另一個是接近零的和棋輕視值,把鬥獸棋從四分之一的對局有勝負提升到大約一半,而兩者都沒有教引擎任何東西。那個 issue 要的是理解。理解從來不是瓶頸。
這些對局是公開的,上面那個局面也是。分析棋盤跑的是同一個引擎,所以如果你認為藍方當時該吃掉那隻虎,你可以讓它把那條變化走完。