在斗兽棋引擎里测试「冲兽穴竞速」评估项
摘要
- Mistboard 的斗兽棋引擎完全不懂冲兽穴竞速,于是我试了三种办法教它。三种结果都是无效或负收益。
- 在发布版强度下,冲兽穴竞速只决定 4.7% 的对局(弱搜索测试给出的是 22%),而搜索加深 12 倍也只能提前两着看到败势。
- 兽穴附近的搜索延伸看起来有 +45 Elo,直到我把节点预算固定住;此时它略为负值。专门的冲兽穴竞速评估项结果为无效。
- 要把预算固定住,否则你测的只是预算。来自同一批对局的两个常数,和棋计数器和和棋轻视值,反倒把决出胜负的对局比例翻了一倍。
Mistboard 的斗兽棋引擎没有冲兽穴竞速这个概念。它对局面的评估是子力加上每个棋子朝对方兽穴推进的奖励,从不去问那个奔向自己兽穴的对手棋子是否会先到。等搜索抵达兽穴时它才发现,那大约是十二着之后。
这看上去是个明显的短板,我在一局机器人把鼠来回挪动、任由对方鼠走进兽穴之后,把它记成了一个 issue。我花了一天试着补上。三条路线,全是无效或负收益。以下是测量结果,以及我从中保留下来的东西。
引擎本来会做的事
这点值得单独说,因为它决定了后面的一切。引擎对胜利条件的理解是完整的:进入兽穴被算作将死,在候选着法里排在最前,并且在静态搜索中被搜索。它缺的是预见能力,不是理解力。
它照样能赢,因为斗兽棋由子力主导,而评估函数对子力的读取是精确的。在进入兽穴的那一刻,胜方的中位子力领先 20 分,大约一只猫。只有 4.7% 的对局是由处于劣势的一方赢下的。
没有这个概念时它会怎么走
研究中的第 10 局只有四着长,它比下面任何表格都更好地解答了这个问题。
斗兽棋的中路是三行水面。d 路是唯一跨越它的陆桥。在这些对局进行时 Mistboard 采用的规则下,虎只能纵向跳水,绝不能横向跳,所以站在那条通道里的虎几乎无处可去。(自 2026 年 9 月起,虎也像狮一样可以横向跳,遵循中国规则体系;这条通道对它不再是陷阱,下面这条着法线是旧规则下的产物。)
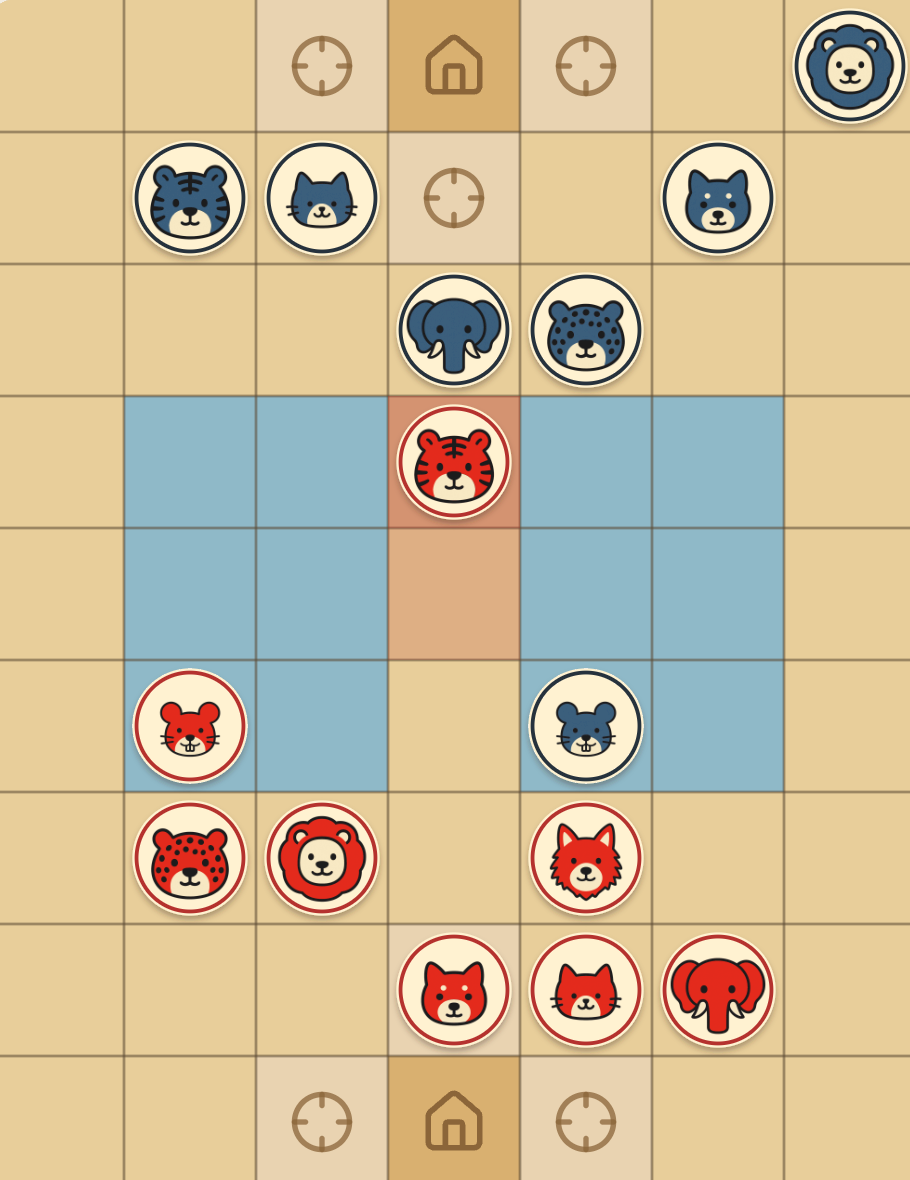 第 20 着,蓝方行棋。红色方格是刚走完的一着:红方的虎在 d6 吃掉一只狼,现在站在通道里。蓝方的象在它上方一格,等级高于它。 第 20 着时红方在 d5 的虎只有两个合法着法。向前或向后,都还在通道里。它选择向前吃掉了狼,这让蓝方损失 40 分,同时把虎停在了蓝方象的旁边。
蓝方的象等级高于虎,所以这看起来像是送礼。蓝方没有立刻吃,这正是我被要求解释的一着。引擎的理由是那只虎逃不掉:象在 d7 时,虎唯一的着法是 d5,而从 d5 出发唯一的着法是 d4,被一个能吃掉它的棋子沿着单车道通道一路赶下去。去吃它等于花一个先手收取已经到手的东西。蓝方走了一着白得的改善着法,两着之后在 d5 而不是 d6 吃掉了虎。两条线路达到的子力完全相同。
决定这局胜负的四着:
41  Blue  elephant d7 -> d6    steps into the corridor after the tiger
42  Red   lion     c3 -> c7    jumps into the square the elephant just left
43  Blue  elephant d6 -> d5    takes the tiger, up a piece
    Red's lion is now three moves from a den Blue cannot defend
那只虎是诱饵。不是弃子:它反正几乎已被困死,而吃掉狼得 +10,几乎所有其他选择都是 +6,差距是四分而非一个计划。它在离开棋盘的路上所做的,是把唯一等级高于狮的棋子拉下 d 路。第 20 着时狮的跳跃评估值是 -195,因为 c7 紧邻 d7 上蓝方的象。两着之后同样的跳跃就能取胜,因为象走开了。
这段着法结束时蓝方领先 13 分,然后输掉了。
把这个计划复述一遍,听起来像是引擎理解了冲兽穴竞速。它并没有。那份评估函数里从头到尾都没有冲兽穴竞速项,在这个项目之前和之后都没有。它搜索了五百万个节点,这条线路就出来了。这就是全部结果:那个 issue 想装进去的行为本来就在,是由深度而不是知识产生的。
基础发生率:4.7% 的对局,而且要在发布版强度下测量
172 局自我对弈,采用生产环境的每着五百万节点预算。
| 终局方式 | 占比 |
|---|---|
| 重复局面和棋 | 52.9% |
| 进入兽穴 | 26.2% |
| 无进展和棋 | 20.9% |
| 真正的竞速(胜方在十着之前持平或落后) | 4.7% |
同一套测试框架在 20 万节点下报出 22% 的竞速比例。棋力更弱会把这个数字大约放大五倍。便宜的测量方式是现成的,而它会朝着「值得多做工作」的方向错上 5 倍。
上限空间:搜索加深 12 倍只换来两着
对每一场竞速,我在败方的对局中二分查找每个预算最早能识别出必败的那一着,然后取差值。
| 差距 | 竞速局数 |
|---|---|
| 0 着 | 4 |
| 2 着 | 3 |
| 4 着 | 1 |
六千万节点对五百万节点,更深的搜索看到败势的时间中位数只提前两着。在那个视野之前,两者走势非常接近,只在最后一两着才分开。
这个数字本该让项目就此终结。如果十二倍的搜索只挽回两着,那这个信息并不是摆在那里、等着一个更聪明的评估函数去发掘。
路线 A:搜索延伸,免费版与付费版
没有真的实现就先探了一下。测试框架里的一条策略规定:只要有棋子处在对方兽穴 R 格之内,就给该方更大的节点预算,这是任何真实延伸的严格上界。
在算 Elo 之前的第一个发现:触发条件并不稀疏。
| 半径 | 触发的着数占比 |
|---|---|
| 2 | 23% |
| 3 | 43% |
| 4 | 72% |
斗兽棋棋盘很小,兽穴就在底线上。在 R=4,也就是早期看到竞速所需的半径下,这个延伸就等于「到处都多搜十二倍」,所以「精准手术」这种设想从一开始就是错的。
在 R=2,每组 300 对交换先后手的对局:
| 实验组 | Elo | 相对对照组的节点数 |
|---|---|---|
| 兽穴附近 12 倍深度,免费给予 | +45 | 3.3x |
| 预算中性,基础 3.7M + 兽穴附近 10M | -15 | 1.04x |
| 预算中性,基础 1.1M + 兽穴附近 20M | -12 | 0.98x |
同一个想法,同一份代码,符号相反。引擎那五百万节点是由玩家愿意等多久固定下来的,所以真实的延伸没法凭空造出深度:它只能从搜索的其他部分抢。免费那一组测的是额外算力。跟兽穴毫无关系。
我之所以跑了预算中性那一组,是因为 +45 看起来好得不真实。就此停手,就会为一个价值略低于零的功能花掉一周工作。
两组各花了一个下午,因为都不需要动引擎。那个延伸只是测试框架里一条根据棋盘条件改变节点预算的策略。对于任何形式为「让它在 X 上更聪明」的提案,先免费给它完美的 X,是判断 X 到底重不重要的最便宜的办法。
路线 B:评估项本身
我还是把它做了出来,因为延伸失败的原因并不适用于一个评估项。延伸消耗节点;而评估项在每个叶子节点上几乎不花成本。
这是当时的评估函数。在棋盘上做一次循环,每个棋子独立贡献:
for idx in 0..N {
    let v = VAL[role_of(code) as usize];
    let friendly = color_of(code) == me;
    s += if friendly { 2 * v } else { -2 * v };

    // Advancement toward the relevant den: the enemy's for our pieces, ours for theirs.
    let target = if friendly { enemy_den } else { own_den };
    let dist = manhattan(idx as u8, target);
    let advance = if dist <= 1 { 400 } else { (16 - dist) * 3 };
    s += if friendly { advance } else { -advance };
}
那个推进项正是评估函数对竞速视而不见的原因,而根源是对称性。我的奔跑者距你的兽穴三格得 +39。你的奔跑者距我的兽穴三格得 -39。双方同时冲刺得到的数字接近零,于是恰恰在局势最已定的那一刻,局面读起来风平浪静。
所以这个项不能再是一个逐子奖励。它必须是每方一个判定,只计算一次,把两个奔跑者互相比较:
for side in [me, 1 - me] {
    // Nearest enemy runner to this side's den, and this side's nearest defender
    // to its own trap ring.
    let (mut att, mut def) = (99, 99);
    for idx in 0..N { /* ...scan once... */ }

    if att > RACE_RADIUS { continue; }   // no race here: contribute nothing

    // The side to move gets one free step in the race for its own den.
    let margin = att - def + i32::from(side == me);
    let pen = if margin <= 0 { RACE_LOST }
              else if margin == 1 { RACE_TIGHT }
              else { 0 };
    score += if side == me { -pen } else { pen };
}
防守方是按到陷阱环的距离来度量的,而不是到兽穴。这才是正确的拦截区,因为兽穴的三个相邻格就是它的三个陷阱,而站在陷阱上的棋子不论等级都能被任何防守方吃掉。走进你兽穴的象必须穿过一个你的鼠能吃掉它的格子。
在它专门针对的那些局面里,它改变了 17% 的选着,并且在节点数相同时实际耗时增加约 17%。每个权重跑 300 对交换先后手的对局,在还没把这项成本算进去之前:
| 权重 | Elo |
|---|---|
| 10 | -3 |
| 25 | +9 |
无效,而且是在宽容的方向上。
我会保留下来的东西
把预算固定住,否则你测的就是预算。实验的免费版本是建起来最方便的那个,而它会递给你一个自信的正数。不管这个改动本该从哪里挪用资源,就从那里挪,然后看结果还站不站得住。
这个陷阱在一天里坑了我两次。同一个下午做的和棋轻视值扫描显示,决出胜负的对局从 32% 升到 50%,而这本来就是提高轻视值必然产生的结果,因为自我对弈扫描中双方都用了同一个设置。只有让两个取值互相对抗,才能看出它是否付出了代价。它没有,所以那一项发布了。
评估函数的这个短板是真实的,诊断也没错。只是它背后什么都没有。在同一批对局里找到的两个常数,一个把对局提前结束的无吃子和棋计数器,以及一个接近零的和棋轻视值,把斗兽棋从四分之一的对局分出胜负提升到了大约一半,而这两者都没教引擎任何东西。那个 issue 要求的是理解。理解从来就不是瓶颈。
这些对局是公开的,上面那个局面也是。分析棋盘运行的是同一个引擎,所以如果你觉得蓝方当时该吃掉那只虎,你可以让它把这条线路走完。