Shogi4:从 APK 中还原规则,21 亿个局面
简而言之
- Shogi4 是一款 4×4 的带打入将棋,它的规则已从公开网络上消失。我通过反编译官方安卓应用还原了这些规则。
- 我搭建并验证了一个求解器,完整求解了一个含 21 亿局面的封闭子博弈:双方各一枚王,外加其余每种棋子各一枚。
- 由于打入会把子留在盘面上,完整博弈是一张 4×10¹⁴ 个槽位的表:约 50 TB,130 到 190 核心年,折合云计算 10,000 到 15,000 美元。
- 分布式设计已在封闭博弈上完成测试,但未真正跑起来。完整求解只会为一款几乎没人玩的游戏确认一个数字。
Shogi4 是 Oca Studios 发布的一款公有领域 4×4 带打入将棋,其规则已从公开网络上消失。我从官方安卓安装包中还原了规则,随后围绕还原出的规则构建了一个强解引擎。
这并不是一次完整求解。它是一个经过验证的求解器、一个含 21 亿局面的封闭子博弈,以及一套在封闭博弈上测试过、但从未全规模运行的分片外存设计。有意思的恰恰是这条边界:Shogi4 是动物将棋之上的第一级台阶,在这里打入把一次博弈求解变成了分布式系统问题。
可以直接在下面试试规则。查看器会强制执行合法着法,包括打入、升变和越友跳,但不会显示理论结果。
本文余下部分把两件事分开讲:完整博弈的求解器设计(已测试但未全规模运行),以及最大的封闭子博弈(已实际求解)。
规则
没有任何二手资料以引擎级精度记录 Shogi4 的规则。可打印自玩的 PDF 从未被存档,出版方的服务器也已下线。我从官方安卓安装包中还原了规则:这是一个 Python/Kivy 应用,游戏代码以一个 .mp3 文件的形式发布,实际上是一个 gzip 压缩的字节码 tar 包。反编译后,其中的 get_possible_squares 和 can_take_square 函数就是权威规则集。完整还原的规则见 Mistboard;这里的摘要足够看懂求解过程。
游戏在 4×4 棋盘上进行,每方五枚棋子,全部每回合走一格:
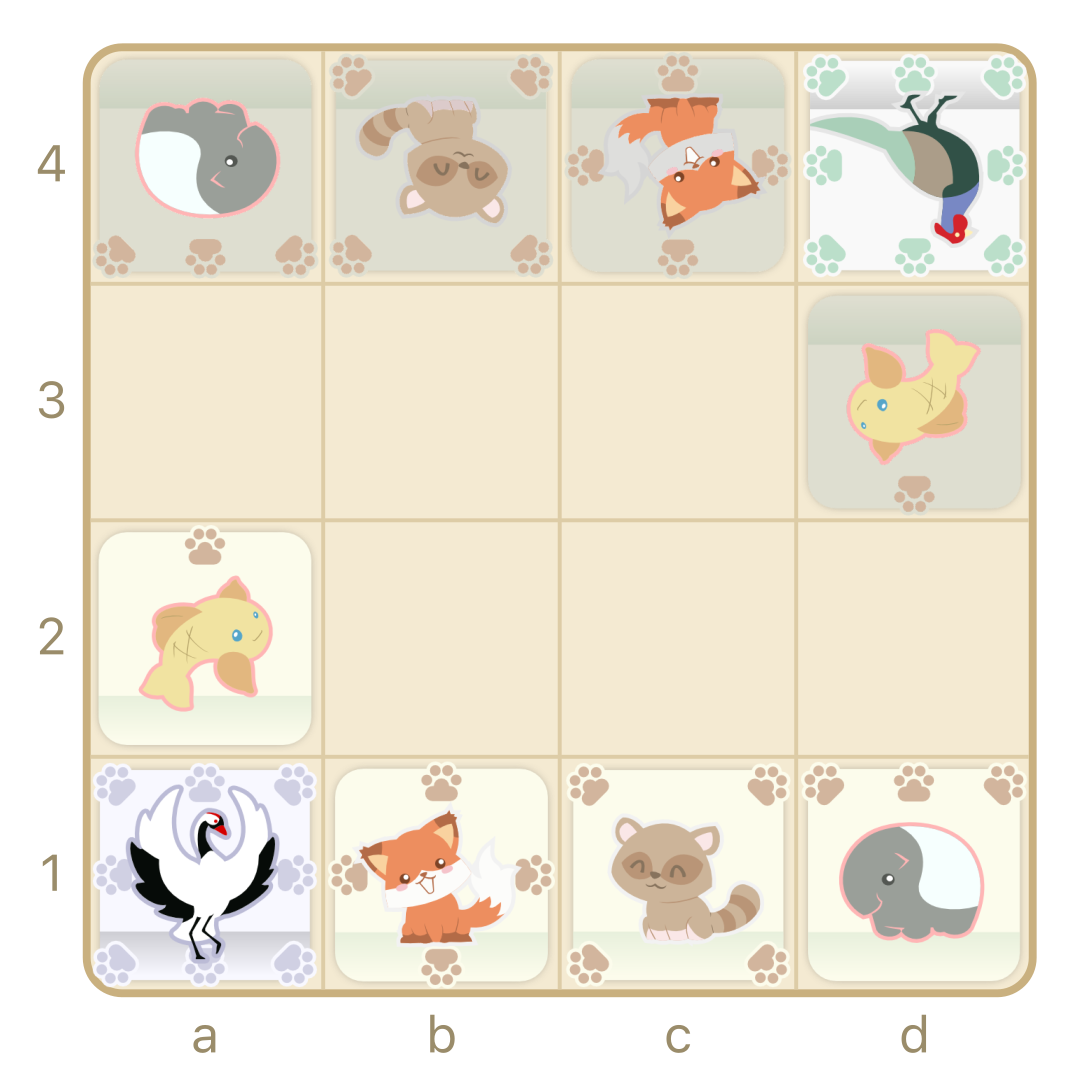 初始局面。棋子归属由朝向表示,而非颜色。
| 棋子 | 走法 |
|---|---|
| 王将(鹤 / 雉) | 一格,8 个方向任意(相当于王) |
| 鲤 | 向前一格 |
| 狐 | 正向一格 |
| 狸 | 斜向一格 |
| 貘 | 向前或斜前一格 |
有三条规则让 Shogi4 需要自己的引擎,而不是把动物将棋改改就行:
- 打入。被吃的棋子会改变归属,从手中放回任意空格,因此子力总量守恒。唯一的限制是不能打入对方底线。
- 升变。走到最远一行的棋子必须升变:鲤、貘、狸升为银将走法,狐升为金将。被吃掉的已升变棋子恢复为原始形态。
- 越友跳。如果在某个合法走子方向的相邻格上有一枚己方棋子,该棋子可以跳过它落到两格外。只能跳一枚己方棋子,不能连跳,也不能跳过敌方棋子。动物将棋中没有对应规则。
吃掉王将即获胜。没有将军或将死的概念,走到会被吃的位置也是合法的,也没有王入敌阵取胜的规则。与动物将棋相比,多出一枚棋子、更大的棋盘、更宽的升变集合、打入限制以及越友跳规则,足以要求一个全新的引擎。
为什么完整的 Shogi4 是一个分布式问题
强解通过逆向分析为每个局面赋值(胜、负或和棋),从终局局面(这里是王被吃掉)往回推。若某个着法可到达一个负局面,则该局面为胜;若所有着法都到达胜局面,则为负;否则为和棋。
在国际象棋中,吃子只会减少子力,因此求解可以分解成一层层越来越小的残局,自下而上求解。打入破坏了这种结构。被吃的子会回来,子力固定,整张图是一个强连通的循环,必须作为一个整体求解。这个整体很大:
| 量 | 数值 |
|---|---|
| 全排列上界(精确值) | 205,148,532,253,680 |
| 从初始局面可达 | ~3×10¹³ |
| 稠密编号索引域 N | 410,297,064,507,360 |
求解器用稠密编号(局面到整数的双射)为局面建立索引,于是值表就是一个平坦数组,查表是 O(1)。索引必须覆盖每一种合法排列,因此决定规模的是 N(约 4×10¹⁴),而不是可达局面数:每槽两比特约为 100 TB,做精确的左右对称折叠后约 50 TB。这使得完整求解是一次分布式外存计算,而不是内存中就能跑完的任务。
完整求解的设计
求解器采用推送式。每个局面保存一个未定子节点计数。终局局面(王在下一着会被吃)被初始化为胜,随后值向后传播:只要某个局面有一着走进负局面,它立刻成为胜;而某个局面的计数降到零,意味着它所有子节点都已是胜,它就成为负。值只会从已定流向未定,因此整个计算是一个单调不动点。
为了扩展到多台机器,编号空间被划分成若干分片,每个分片持有自己槽位的值和计数。确定一个局面的值时,通过反着法生成其前驱,并把每个前驱作为消息发给持有它的分片。这种路由就是 shuffle,也是工作量的主体:每个局面约 7 条前驱消息,全规模下为 15 到 30 PB。
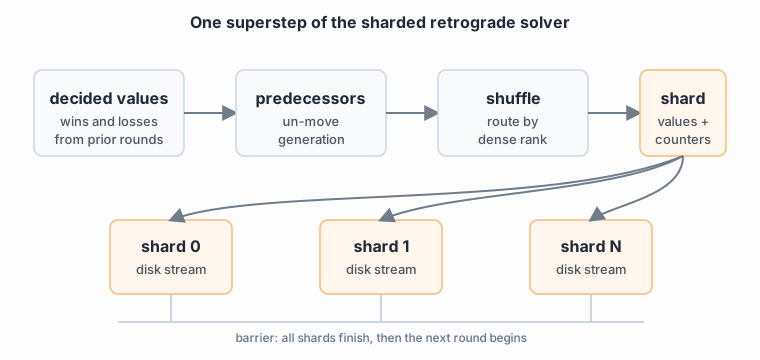 每个分片持有稠密编号表的一段。消息把计算搬到持有该前驱的分片上。
工作节点在屏障后按超步推进。每个节点处理完当前一轮消息,确定能确定的值,并发出下一轮消息。由于不动点是单调的,最终的表既不依赖空间如何分片,也不依赖消息到达的顺序。分片只改变调度,绝不改变答案,正是这一性质让该计算可以安全地分布式化。
决定计算形态的是存储,而不是算力。值数组分片存放在磁盘上,按超步流式读取后丢弃,而不是常驻内存;精确的左右折叠把存储和工作量都减半。
验证
引擎与一个独立的 Python 移植版(基于反编译的应用)对照检查。索引和值分别验证。
着法生成。perft(从初始局面起各深度的着法树节点数)逐位吻合:
| 深度 | 局面数 |
|---|---|
| 1 | 8 |
| 2 | 64 |
| 3 | 626 |
| 4 | 6,304 |
| 5 | 68,723 |
| 6 | 769,014 |
另有一项覆盖 4,000 个局面的随机对局差分测试(含打入、升变、吃子、跳跃),两个引擎的着法列表零不一致。
索引。稠密编号是经过验证的双射:在每个小型博弈的索引上,编号再反编号都是恒等映射,且它枚举出的局面与直接枚举一致。它在完整博弈上的域恰好是独立排列计数的两倍。该枚举器还以动物将棋作为校验:它复现了 Tanaka 公布的 1,567,925,964 个局面数,以及按手中棋子的完整分解。
值。三个求解器(两个 Python 算法、一个 Rust)在每个封闭子博弈上结果一致。局部一致性审计零违例:每个胜局面都有一着通向负,每个负局面的所有着法都通向胜,和棋局面两者皆无。左右镜像完全成立,零不一致,前驱生成器与真正的反向边吻合。
这些已完整求解的小型封闭博弈,是 Shogi4 的首批博弈论结果(值以行棋方视角给出):
| 子博弈 | 局面数 | 胜 | 负 | 和棋 |
|---|---|---|---|---|
| 2 王 | 480 | 35.0% | 0% | 65.0% |
| 2 王 + 鲤 | 24,480 | 75.9% | 23.3% | 0.7% |
| 2 王 + 狐 | 24,480 | 76.7% | 23.3% | 0% |
| 2 王 + 狸 | 24,480 | 76.2% | 23.8% | 0% |
| 2 王 + 鲤 + 狐 | 1,164,704 | 74.5% | 17.8% | 7.7% |
双王结果没有负局面,这是一个合理性检验:只剩王时,行棋方总能避开被迫吃子。
在笔记本上为完整求解设计去风险
在租用集群之前,我在一台笔记本上测试了分布式设计,以内存求解器作为参照标准。
- 汇合性。分片求解器在 1、4、16、64 个分片下都复现了单机结果。传播最多跑 54 个超步,即最长强制变化的深度。单调不动点的论证说明分片数不可能有影响;测试证实了这一点。
- 校验。一次一致性遍历就能以低于求解本身的成本认证整张表。在 {2 王 + 鲤 + 狐} 上,求解耗时 5.5 秒,审计 3.0 秒,即校验占求解的 55%,而我人为破坏的每个值都被抓出(每个表现为 1 到 5 处局部违例)。
- 恢复。崩溃重放能逐字节复现每个超步。实现它时抓到了一个真实缺陷:前驱是从哈希集合中收集的,导致重放顺序与原始顺序不一致。对输出排序后求解器变为确定性的,这正是幂等恢复所需要的。
最大的一次封闭运行
设计验证完成后,我求解了一个更大的封闭博弈:双方各一枚王,加上每种棋子各一枚(鲤、狐、狸、貘),共 2,100,849,024 个局面。它是一个简化博弈,而不是完整 Shogi4 的切片,因为打入使子力守恒,真实博弈永远不会到达每种棋子各一枚的配置。它是我能用来在较大规模上验证核心的最大封闭博弈。
| 实例 | Hetzner Cloud CCX43(16 个独享 vCPU,64 GB) |
| 操作系统 | Ubuntu 26.04 |
| 模式 | 单线程,全程在内存中 |
| 峰值内存 | 约 15 GB(工作队列压缩为 32 位编号) |
| 实际耗时 | 5.3 小时 |
| 成本 | 约 2 美元 |
这是一次单机内存求解,不是分布式路径的运行。约 15 GB 的占用在笔记本上也放得下;我只是租了台机器,好让自己的机器在这五个小时里空出来。结果(以行棋方视角):
| 结果 | 局面数 | 占比 |
|---|---|---|
| 胜 | 1,662,776,212 | 79.15% |
| 负 | 339,566,116 | 16.16% |
| 和棋 | 98,506,696 | 4.69% |
各项计数之和与局面总数完全相符,并通过了审计。
这次运行还校准了单边成本随工作集大小的变化:
| 局面数 | 每边纳秒数 |
|---|---|
| 1,164,704 | 327 |
| 51,461,568 | 493 |
| 2,100,849,024 | 697 |
21 亿这一档是第一次让值数组(约 14 GB)超出 CPU 缓存的运行,因此 697 ns/边是推算完整求解的依据。缓存内的基准测试会低估这类任务。
完整求解要花多少钱
以 697 ns/边为锚点、4×10¹⁴ 为索引规模,完整求解大约需要 50 到 100 TB 的工作存储,以及 130 到 190 核心年的算力:约一百万核心小时,按云价折合 10,000 到 15,000 美元。
这个数字来自两次修正。原始局面数起初差了一个数量级。随后又把占用错按可达局面数(约 3×10¹³)而不是排列域(约 4×10¹⁴,大约是前者的 13 倍)估算,而稠密编号索引必须覆盖后者。
这个索引是别扭但必要的部分。小型求解器可以枚举可达局面,并维护一个从局面键到表槽位的 HashMap。在这个规模下,构建这张映射本身就已经太大。可扩展的做法是给每一种排列一个数学地址:rank(position) -> integer。这会在非法或不可达的排列上浪费槽位,但它把残局库变成了可以分片、流式处理、检查点和审计的平坦数组。
同样的取舍也出现在逆向步骤中。小型内存求解器可以存一份压缩稀疏行(CSR)形式的全部前驱边列表,然后直接遍历这张反向图。完整求解器负担不起为每条边存一行。它改为按需生成前驱:还原着法形态,为每个前驱计算编号,再把更新发给持有该编号的分片。这样每条边的 CPU 开销更高,但这正是内存受限的捷径与外存求解器之间的差别。
在得出这一估算之后,我在相邻的 4×5 微型将棋台阶上实测了这一取舍:每方 K+P+G,869,287,068 个可达规范局面。可达 HashMap + 存储 CSR 的求解器核心求解峰值 RSS 约 60.5 GiB、耗时 12,385 秒。而针对 KPG 的稠密编号 + 反着法求解器使用了 2,037,557,340 个编号槽(是可达数的 2.34 倍),复现了相同的值计数,峰值 RSS 约 6.86 GiB,总求解时间 8,464 秒。
| 方法 | 索引 | 前驱 | 峰值内存 | 单核耗时 |
|---|---|---|---|---|
| 可达 + CSR | 8.69 亿个可达键 | 存储反向图 | 约 60.5 GiB | 核心求解 12,385 秒 |
| 稠密编号 + 反着法 | 20.4 亿个编号槽 | 按需生成 | 约 6.86 GiB | 总求解 8,464 秒 |
这就是工程上的取舍:稠密编号用槽位和编号/反编号的 CPU 开销,换取不必存储反向图。在这一档上,内存下降了 8.8 倍,单核运行快了 1.46 倍,因为它免去了构建和保存反向图。
为什么没有跑
引擎、分布式设计、校验和标定都已完成。要完成完整求解,需要的是租来的算力,而不是又一个想法。
这笔花费过不了门槛。技术是已知的,所以结果里没有论文;游戏很冷门,所以它的值也没什么需求。自掏腰包只会买来一个数字:一款几乎没人玩的游戏的博弈论值。
这个项目的价值在于能力本身。规则已还原,求解器已构建并验证,分布式路径也在整套集群运行之前用封闭博弈检验过。求解这款游戏只会确认一个值,不会改变方法。
相关资源:
- Shogi4 查看器:仅限合法着法的自由对局。
- Shogi4 规则:完整还原的规则集。
- brianhliou/shogi4:Rust 引擎、求解器和验证工具。
- 求解动物将棋:下一级台阶,已完整求解。